Un agent ou un comité ? Ce que l'usage des comités m'a appris depuis leur mise en place
Un agent seul se croit toujours dans le vrai. Deux agents d'accord aussi, peut-être : à deux, ils se trompent parfois simplement plus fort. 🥊
En bref — Ce qui a vraiment amélioré mon travail, ce n'est pas le comité. C'est un lecteur qui n'avait rien vu, et un petit programme qui refait la vérification. Le comité, lui, m'aide à comprendre et à décider ; il ne corrige pas. Comprendre, oui ; vérifier, non. Quand un agent IA me rend un résultat, je ne sais pas toujours s'il est juste. La tentation est connue : mettre plusieurs agents sur la même question et croire celui sur lequel ils s'accordent. À partir du 3 octobre 2026, j'ai travaillé de deux façons : le mode « classique », un agent par tâche, et le mode « comité », plusieurs agents sur la même tâche. Cet article raconte ce que leur usage a changé, du 3 au 23 octobre. Quatre changements en sont sortis : un relecteur neuf pour mon propre travail, un petit programme à la place d'un agent vérificateur. S'y ajoutent un deuxième agent seulement quand le premier revient sans preuve valable, et des comités qui m'aident à trier et à décider. Vous pouvez en tirer un geste dès demain : faire relire votre dernier document par un assistant qui ne l'a jamais vu.
Les mots nouveaux de cet article
Agent, token, salle, garde, test vert ou rouge : je les ai expliqués dans mes articles précédents. Voici seulement les mots qui apparaissent ici pour la première fois.
- Un comité réunit plusieurs agents sur la même question, avec la même consigne écrite. Une dernière étape, la consolidation, tranche entre leurs réponses. Elle ne vote pas : elle compte les preuves, pas les mains levées.
- Un bras est un agent qui tente la tâche de son côté.
- L'escalade, c'est lancer un deuxième bras, ou un modèle plus puissant, quand le premier revient sans preuve valable.
- Un relecteur neuf est un agent qui n'a rien vu du chantier : il relit mon travail avec des yeux neufs.
- Le mode classique est mon défaut : un agent par tâche, coût « 1× ». Le mode comité, lui, met plusieurs agents sur la même tâche.
Un agent seul se croit toujours dans le vrai
Je suis coach produit, je ne code pas, et je fais livrer des produits par des agents IA. Mon problème est de savoir quand croire ce qu'on me rend. Mettre plusieurs agents sur la même question rassure, mais un accord n'est pas une preuve. Voici comment j'ai organisé le travail, ce que j'ai vu dans des situations réelles, ce que j'ai écarté, et ce que je vais faire ensuite.
Comment je travaille, en trois lignes
La règle posée le 3 octobre, devenue permanente le 4, tient en trois lignes.
- Le comité sert à comprendre, jamais à écrire. Diagnostic, audit, relecture, conception : oui. Faire écrire le même document par plusieurs agents produit un conflit ; il y a donc un seul rédacteur par sujet.
- Un agent d'abord, un deuxième seulement si besoin. Un seul agent, avec une consigne soignée. Un deuxième ne part que si le premier revient sans preuve valable : c'est l'escalade. Si les deux échouent, la réponse est « Information insuffisante » et c'est moi qui tranche.
- Quand la preuve peut se refaire par un petit programme, c'est lui qui tranche, pas un agent.
Le comité est annoncé en une ligne, avec sa raison.
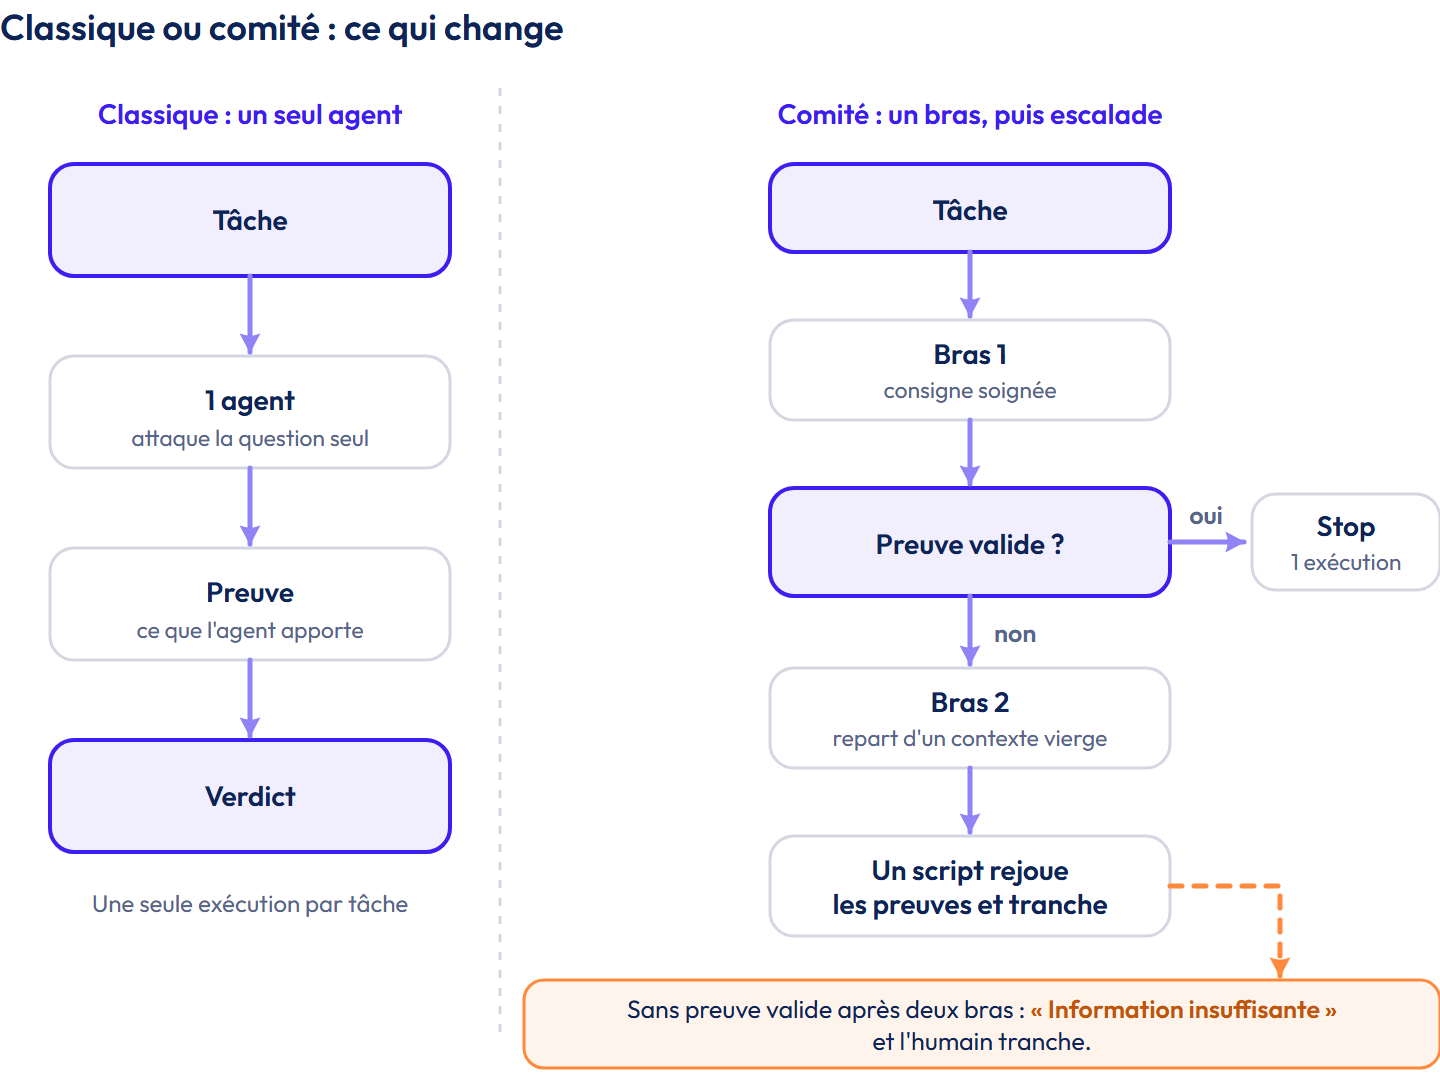
Classique : un agent, un verdict. Comité : un bras, puis un deuxième seulement si la preuve manque.
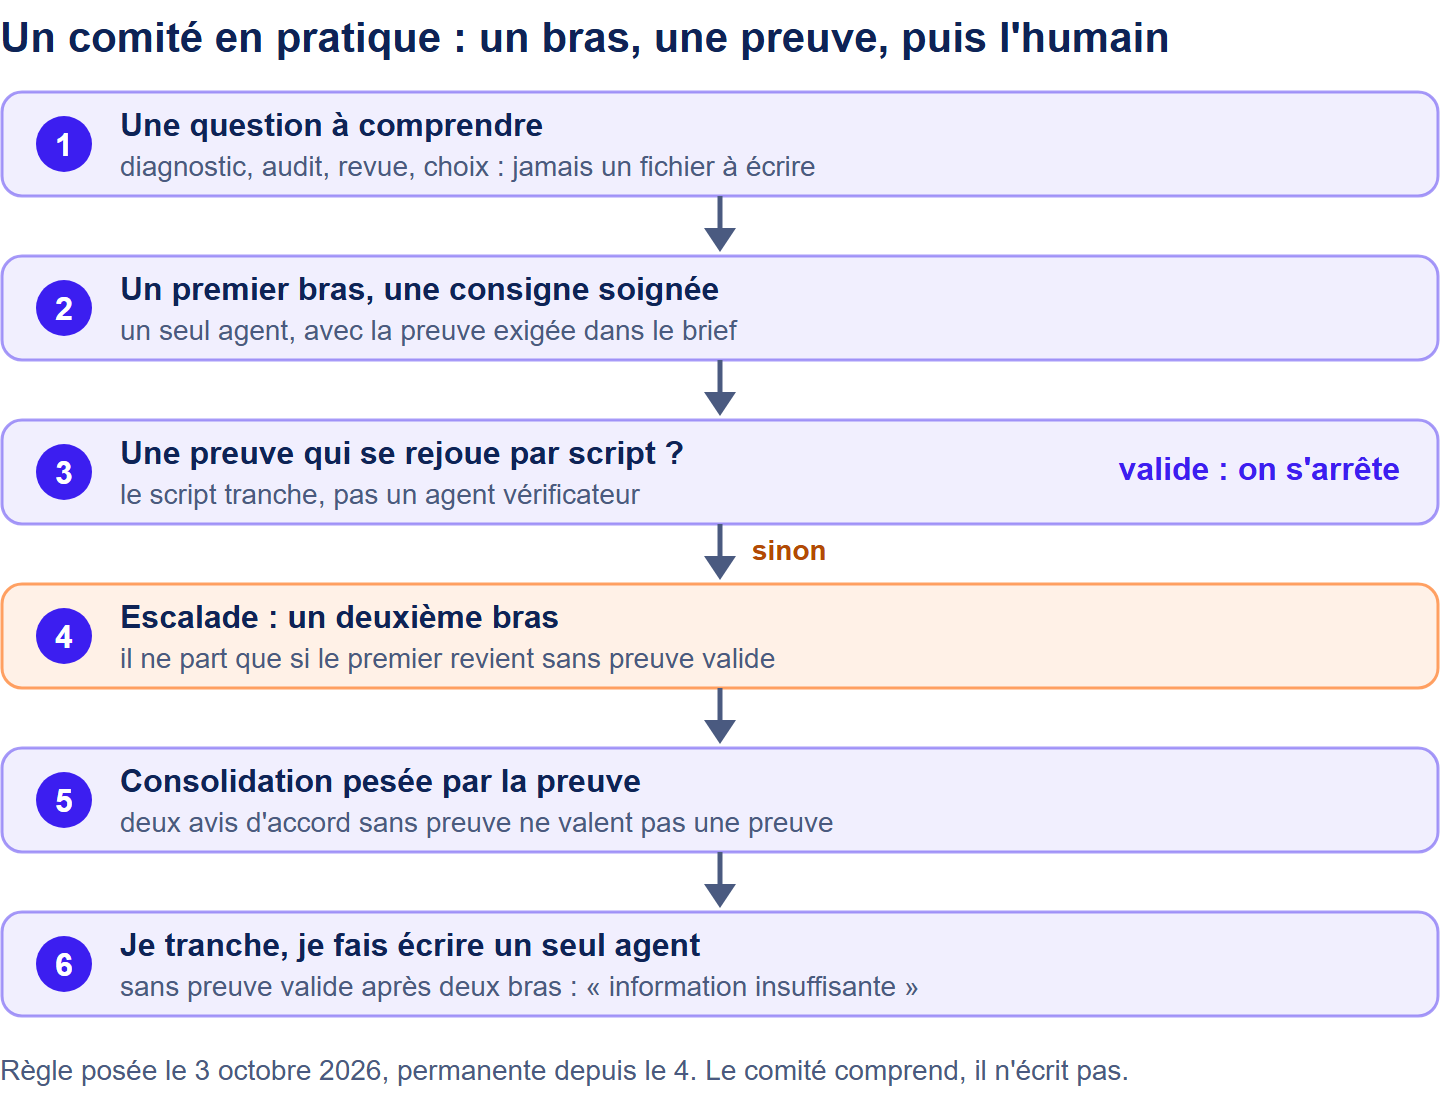
Cette règle est permanente mais reste un essai : première révision à 10 exécutions par mode.
Quatre changements, quatre situations réelles
Pour chaque scène : la situation, ce que j'ai fait, ce que j'ai obtenu.
1. Un relecteur neuf trouve ce que je ne vois plus
Situation. Le 19 octobre, je renforçais mes protections et mon journal de travail. Un de mes outils, qui applique des changements à une présentation, pouvait aussi supprimer des diapositives sans le dire.
Ce que j'ai fait. J'ai confié la relecture à des relecteurs neufs.
Résultat. Ils ont trouvé deux vrais défauts, dont une protection de sécurité de l'outil de présentation qui restait ouverte dans un cas oublié. Les deux ont été corrigés avant la fusion. L'outil refuse désormais de supprimer une diapositive sans le dire, compare les diapositives censées rester intactes avant et après, et vérifie l'ordre. Deux nouvelles gardes en sont sorties : le journal refuse un « succès » sans preuve, et les protections n'ont plus de repli sans limite.
Même chose pour sept modèles de formes que j'ajoutais à mes présentations : tous les tests étaient verts. Un relecteur neuf a remarqué que si l'on changeait l'angle du dégradé de couleur d'une forme, aucun test ne s'en apercevait. La correction a tenu en trois lignes de vérification : un angle modifié rend désormais le test rouge.
Ce gain est revenu plusieurs fois : dans 14 des 29 cas que j'ai relus, le relecteur neuf a fait corriger au moins un défaut. J'en ai fait une règle : pour toute modification risquée de mes protections ou de mon journal, la relecture par un relecteur neuf est obligatoire. Ce résultat est celui d'un agent seul, pas d'un comité.
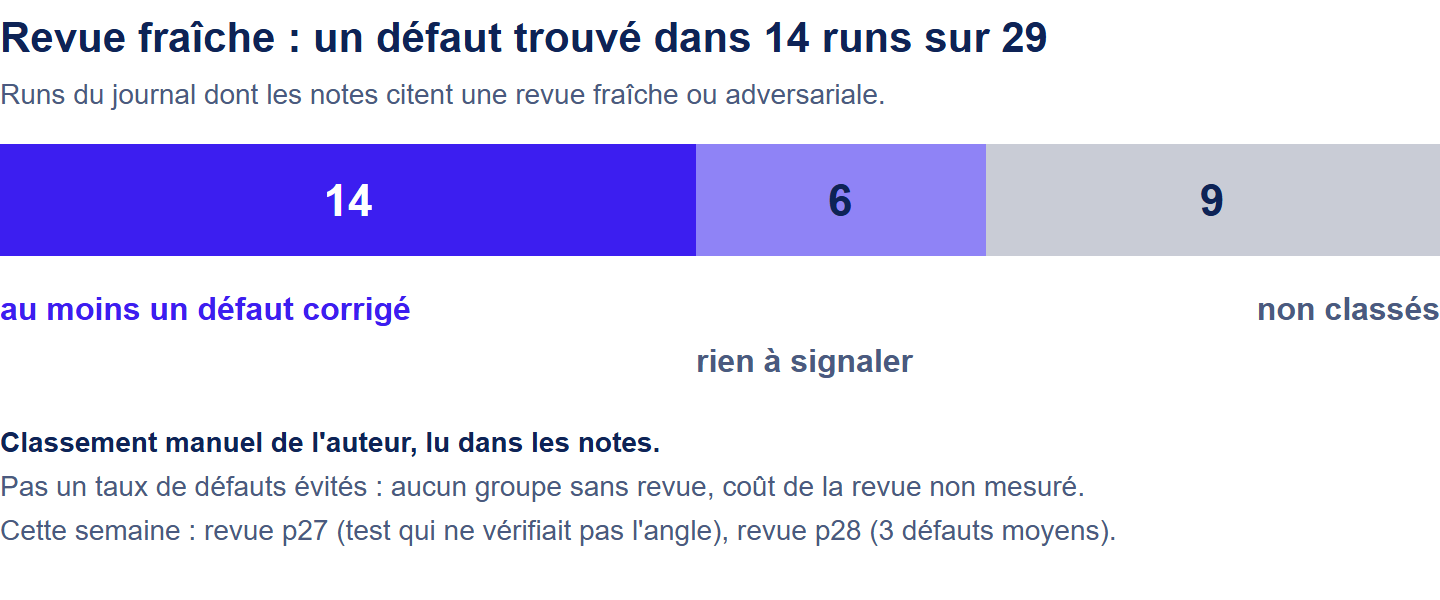
Le gain que je peux chiffrer vient du relecteur neuf, pas du comité.
2. Un petit programme juge mieux que l'agent vérificateur
Situation. Pour savoir si une preuve tenait, j'avais deux juges possibles : un agent vérificateur, ou un petit programme qui refait la vérification.
Ce que j'ai fait. J'ai comparé les deux sur 44 verdicts d'agents.
Résultat. L'agent validait à tort 8 preuves sur 44 que le programme rejetait (rejoué le 23 octobre), sans jamais rejeter une bonne preuve. Le programme met quelques secondes contre six minutes pour l'agent, et ne dépense aucun token. C'est désormais lui qui juge.
3. Un agent d'abord, un deuxième seulement si besoin
Situation. Lancer deux agents par tâche, systématiquement, coûte cher.
Ce que j'ai fait. J'ai refait le calcul sur mes mesures du 4 octobre avec une nouvelle règle : un agent d'abord, puis un deuxième seulement si le premier revient sans preuve valable.
Résultat. 12 exécutions au lieu de 20 pour couvrir 9 tâches sur 10, et 15 au lieu de 25 pour couvrir 13 tâches sur 13. Soit 40 % d'exécutions en moins, pour la même couverture. Cette règle est en vigueur depuis le 4 octobre.
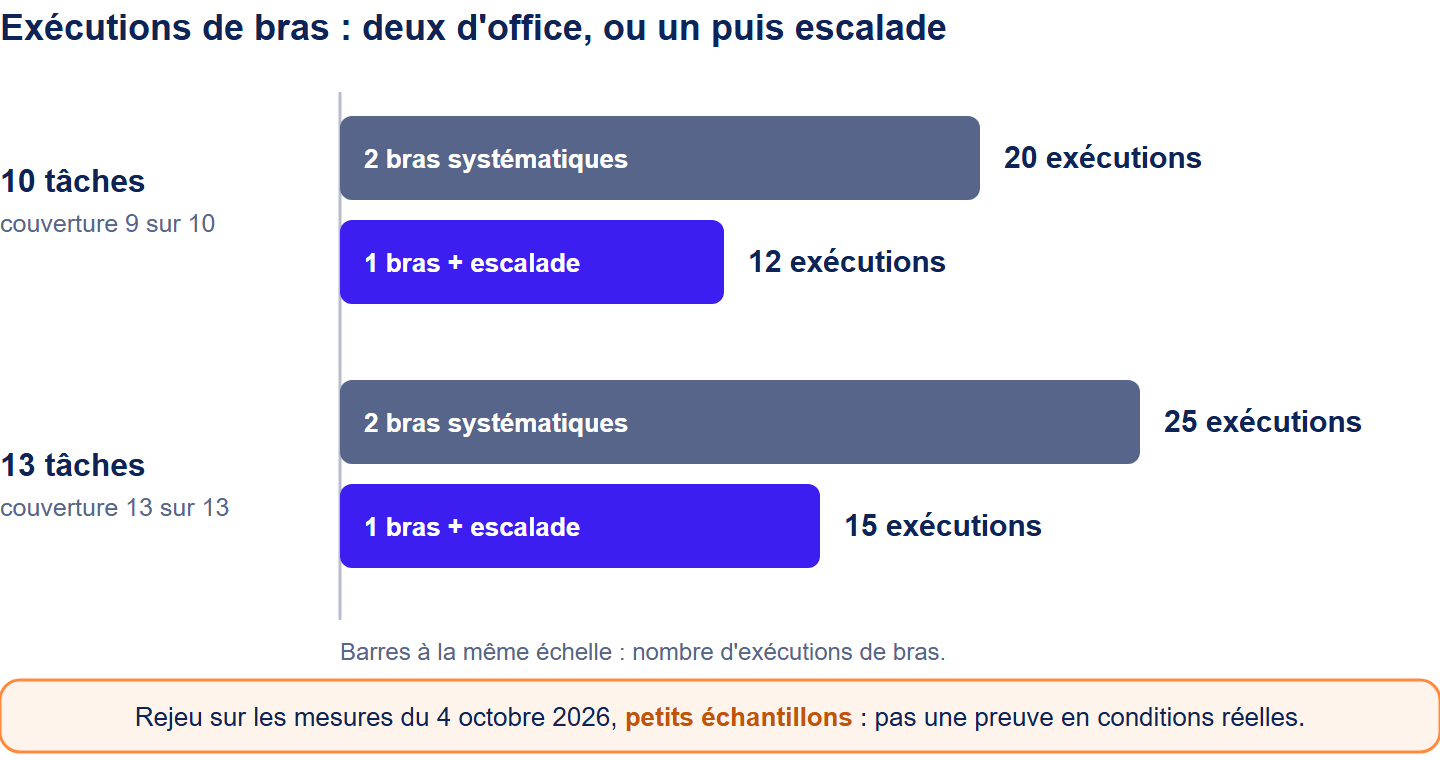
Un bras puis escalade : moins d'exécutions pour la même couverture, sur un rejeu de petits échantillons.
4. Des comités qui trient et qui m'aident à décider
Situation. Le 20 octobre, j'avais treize trouvailles de veille et sept constats ouverts à trier. Le 23 octobre, je devais décider d'un plan d'amélioration à partir de chiffres de départ.
Ce que j'ai fait. Trois comités de lecture, puis mon arbitrage. Pour le plan, un agent adversaire a vérifié chaque chiffre à la source.
Résultat. 8 trouvailles adoptées, 5 refusées, 3 constats fermés. Pour le plan, des chiffres périmés ou tirés d'un seul essai ont été corrigés avant que je décide quoi que ce soit. Le comité ne rédige rien : il m'aide à comprendre et à décider, et une seule personne ou un seul agent écrit.
Comment l'appliquer à vos sujets
Vous avez déjà demandé à un assistant IA de relire sa propre réponse, et il l'a trouvée très bien. Moi aussi. J'ai alors confié la relecture à un agent qui n'avait rien vu du chantier. Ce n'est pas un comité, c'est plus simple, et vous pouvez le faire dès demain.
Un exemple de coach produit : vous venez d'écrire une note de cadrage ou une user story avec un assistant. Ouvrez une conversation neuve, donnez-lui seulement le texte, et demandez : « Qu'est-ce qu'un développeur comprendrait de travers ? Quel critère d'acceptation manque ? » Le relecteur neuf ne connaît pas vos échanges : il voit ce que l'équipe verra.
Quatre questions, dans l'ordre :
- Ma tâche produit-elle quelque chose à écrire ou à envoyer ? Oui : un seul rédacteur, puis un relecteur neuf. Non : question suivante.
- Puis-je refaire la vérification moi-même, ou par un petit programme, une formule, une comparaison de deux fichiers ? Oui : je le fais, pas besoin de comité.
- La cause ou le choix est-il incertain et ouvert ? Oui : un premier agent ; si sa preuve manque, un deuxième ; si elle est valable, je m'arrête là.
- L'action est-elle irréversible (envoi client, suppression) ? Oui : je valide moi-même, sans comité.
Commencez petit. Prenez une tâche réelle. Notez avant ce que vous allez mesurer (nombre de défauts trouvés, temps, coût). Refaites-la une dizaine de fois, puis comparez. Mes chiffres viennent d'un seul poste et de petits échantillons : les vôtres compteront plus que les miens.
Une question à garder pour tous vos sujets : « qu'est-ce qui me permettrait de vérifier sans croire personne ? »
Ce que les essais de charge ont montré
Les 3 et 4 octobre, j'ai fait travailler 30 puis 40 agents à la fois. Chacun devait trouver ce que les tests de mon dispositif ne protègent pas, et un petit programme refaisait chaque preuve. À 30 agents, le comité a obtenu 14 preuves valides sur 20 ; à 40 agents, 22 sur 25 (rejoué le 23 octobre). Mais ce qui a craqué, ce n'est pas le travail des agents : c'est leur lancement. Un lancement refusé, c'est un agent que mon poste n'arrive même pas à démarrer. Au-delà de quatre agents lancés d'un coup, ces refus augmentaient, jusqu'à 65 % des lancements à 40 agents. Depuis, je lance les agents un par un.
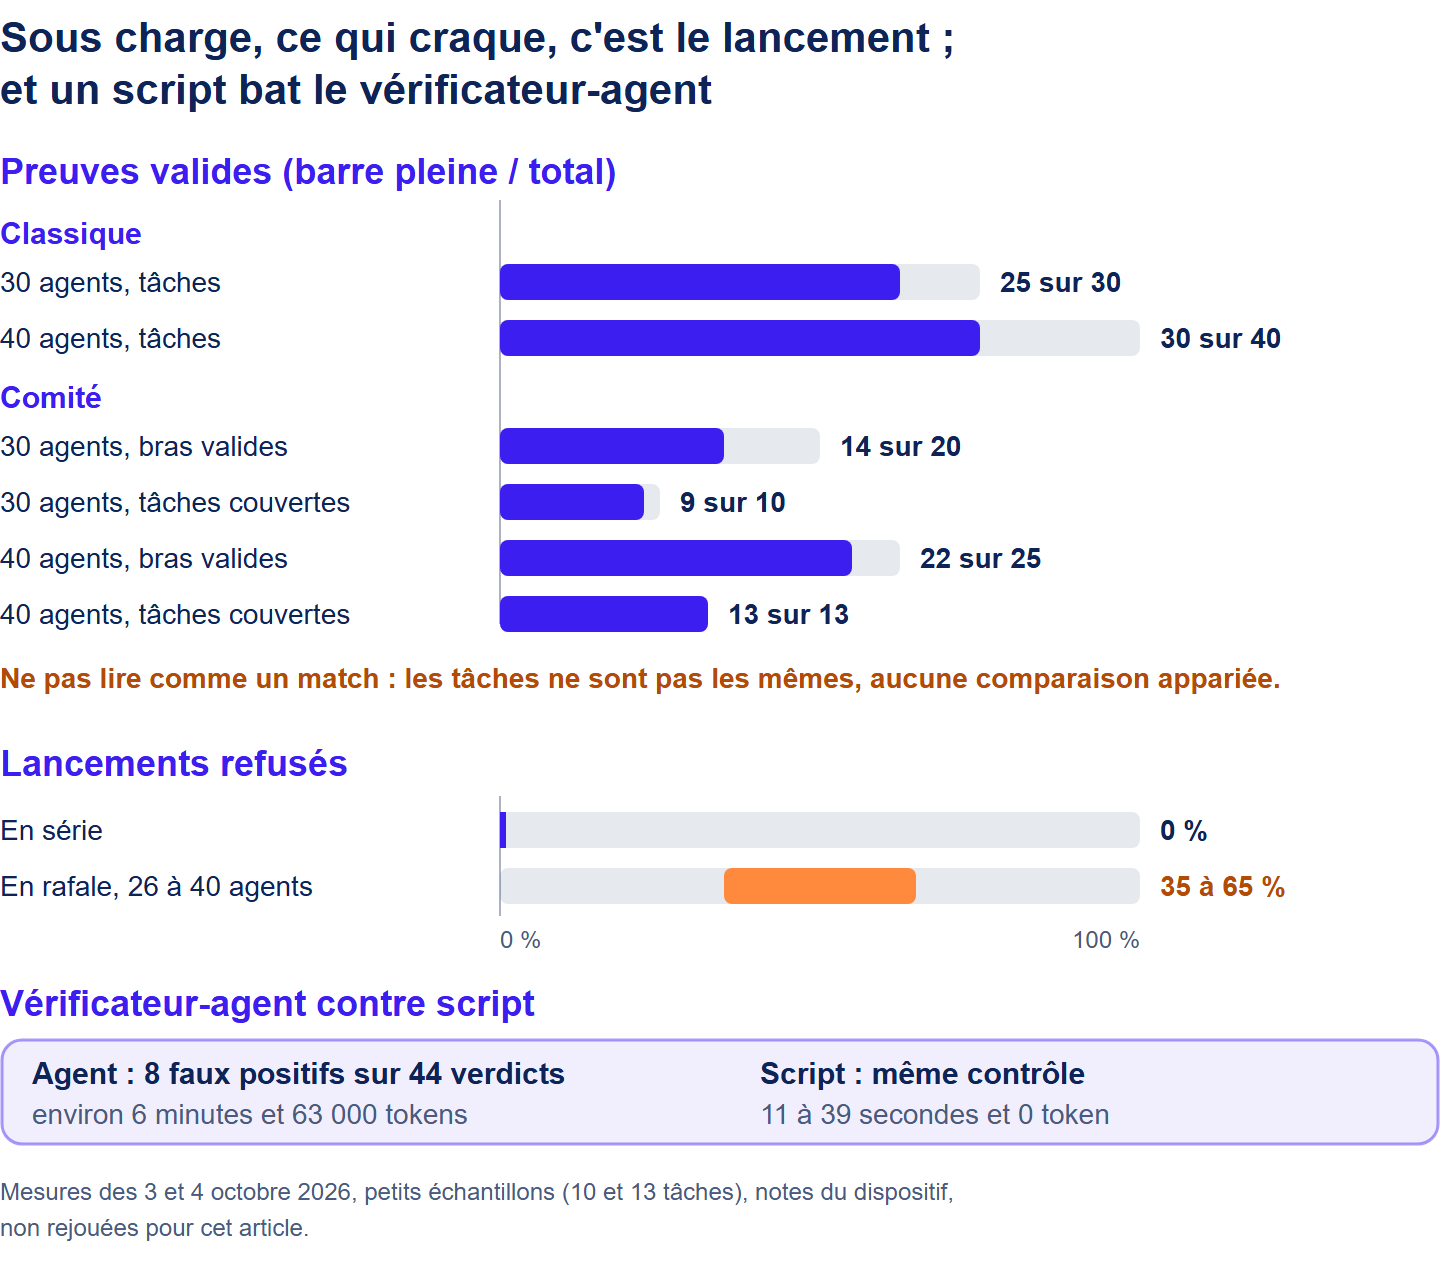
Sous charge, ce qui craque, c'est le lancement. Et un script bat le vérificateur-agent.
Ce que j'ai écarté, et pourquoi
- Le comité pour tout : le 7 octobre, une salle en comité a coûté environ 358 000 tokens contre 84 000 pour un agent seul, soit ×4,3. J'avais fixé le seuil d'abandon à ×2. Je réserve le comité aux questions à comprendre.
- L'accord comme preuve : le 8 octobre, une escalade vers un modèle plus puissant a contredit la recommandation commune d'une salle. Depuis, une salle ne s'enregistre plus sans les traces écrites de ses deux tours : un accord n'est plus pris pour une preuve.
- La conclusion sur un seul cas : le 9 octobre, un comité avec tableau commun a été non concluant, car le sujet ne distinguait pas les modes. Je ne conclus plus sur un seul cas.
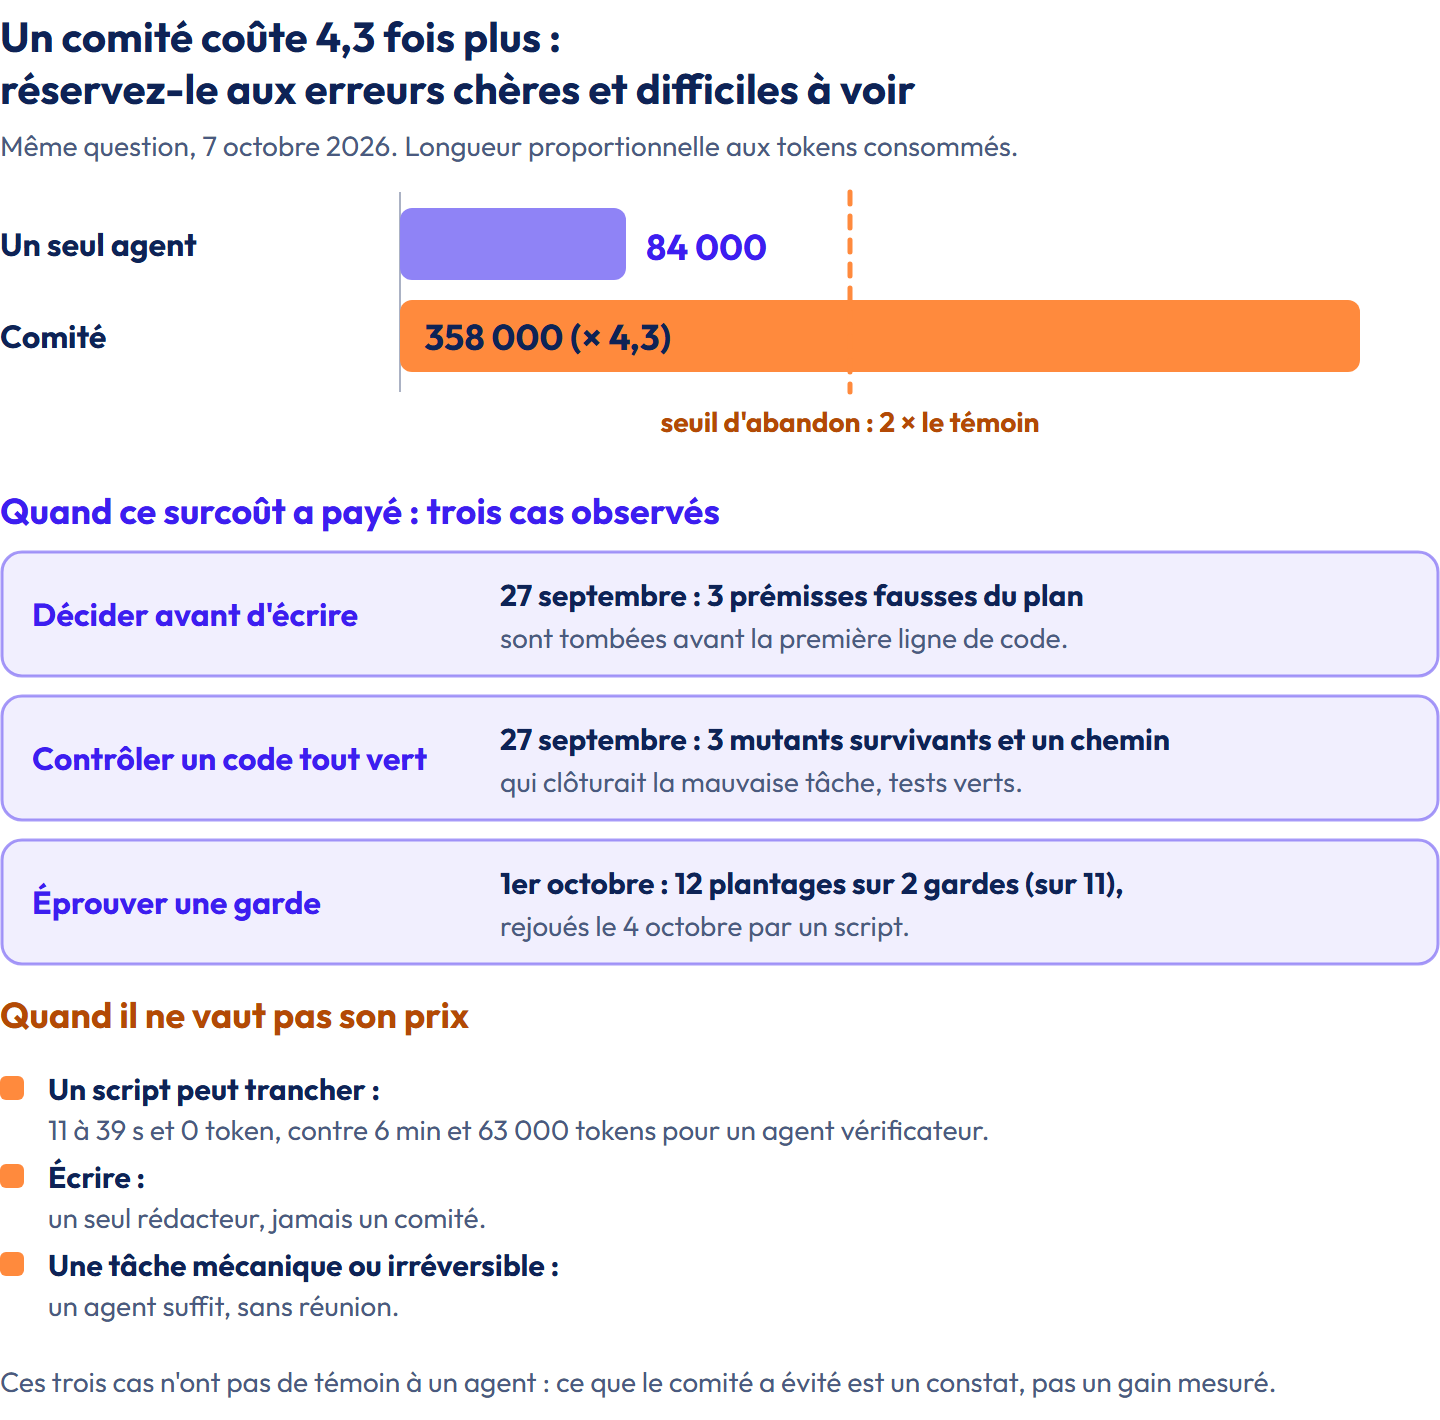
Même question, 84 000 tokens pour un agent, 358 000 pour le comité. Figure reprise de l'article de la série sur le coût des agents.
Limites, en une fois > > 1. Les 40 % d'exécutions en moins viennent d'un rejeu sur de petits échantillons. > 2. Le 14 sur 29 vient de mon propre classement de mes notes, sans groupe témoin. > 3. Le lien entre les relectures et le renforcement de l'outil de présentation, je le lis dans l'historique des modifications. > 4. Le comité coûte plus (×4,3 dans le cas le plus net).
Ce que j'en retiens
Quatre décisions, en mots simples.
- Pour relire mon travail, je prends un relecteur neuf. C'est le gain le plus net que j'ai pu chiffrer.
- Je demande une preuve que je peux refaire moi-même, ou faire refaire par un petit programme, plutôt qu'un avis.
- Je ne mets plus plusieurs agents sur une question par réflexe. Un seul, bien briefé, d'abord ; un deuxième seulement s'il revient sans preuve valable.
- Le comité ne rédige jamais. Il aide à comprendre et à décider ; une seule personne ou un seul agent écrit.
Et si l'action est irréversible (envoi à un client, suppression) ou si c'est un livrable que je dois valider, je reste en mode classique et je valide moi-même.
Pistes ouvertes : ce qui est lancé, ce qui vient
Ces essais m'ont laissé plus de questions que de réponses, alors j'ai lancé des chantiers dès le 23 octobre. Aucun n'est terminé, et je ne promets aucun gain : je dirai ce qu'ils donnent quand je l'aurai mesuré.
Lancés cette semaine
- Exiger une preuve à la sortie. Un agent ne pourra plus écrire « réussi » sans montrer la commande qu'il a lancée et son résultat.
- Repérer quand je m'acharne. Un rapport détecte deux corrections ratées sur le même problème et me propose de m'arrêter pour repartir à neuf. Il ne décide rien. Sur mon historique, il n'a encore rien trouvé : un détecteur muet ne prouve pas que le problème n'existe pas.
- Mettre mes tests à l'épreuve. Un test peut être vert pour de mauvaises raisons. Un outil casse volontairement le code, un petit détail à la fois, pour vérifier que mes tests s'en aperçoivent.
- Limiter le nombre d'agents en parallèle. Un plafond de quatre, qui refuse en expliquant pourquoi. J'avais écarté cette idée, puis j'y suis revenu.
- Un mode d'orchestration plus ambitieux, éteint par défaut. Un score déciderait qui travaille sur quoi. Je le compare d'abord, en lecture seule, à ce que j'ai vraiment fait. S'il agit un jour, chaque action sera une trace que je pourrai annuler. La seule simulation que j'ai lue ne montre pas de gain : je ne l'allumerai pas sans preuve.
À mesurer ensuite
- Refaire un essai de charge avec ces règles en place, pour apprendre ce que l'escalade et le petit programme changent en vrai, au-delà du rejeu.
- Noter dans chaque exécution le verdict constaté ensuite. Le 10 octobre, sur 252 exécutions journalisées, aucune ne le notait.
La suite, avec les chiffres, bons ou mauvais, dans un prochain article.
Conclusion
Faut-il mettre plusieurs agents pour être sûr ? Pas par réflexe. Les essais m'ont fait alléger le comité : un agent de moins, un petit programme de plus. Le comité m'aide à comprendre et à décider ; il peut être contredit par une escalade, et il coûte plus. Les quatre changements tiennent : un relecteur neuf, un petit programme qui juge, un deuxième agent seulement si besoin, et des comités qui m'aident à décider.
Le 19 octobre, mon travail passait tous mes tests. Un relecteur qui ne l'avait jamais vu y a trouvé une protection de sécurité restée ouverte, que je ne voyais plus. Essayez demain : prenez le dernier document que vous avez écrit avec un assistant, ouvrez une conversation neuve, et faites-le relire par un lecteur qui n'a rien vu. Notez ce qu'il trouve.
Pour aller plus loin, mes articles précédents sur le même dispositif :
- Les salles d'agents : le seul endroit où l'on est content d'être contredit : comment je fais délibérer plusieurs agents avant une décision ;
- Mes agents lisaient trop : ce que dix semaines de chasse aux tokens m'ont appris : d'où vient la figure du 7 octobre sur le coût ;
- Je ne code pas, BMAD code pour moi avec ses agents : sur parole ou sur preuves ? : pourquoi je demande des preuves plutôt que la parole d'un agent ;
- Des agents IA et des skills sur huit projets, nous gardons le volant et le fossé attendra : les protections et la veille de mon dispositif.
Note de l'auteur
Pour cet article, j'ai de nouveau boxé quelques rounds avec l'IA 🥊. Les chiffres viennent des essais des 3 et 4 octobre 2026 et des notes de suivi jusqu'au 23 octobre, sur mon propre dispositif ; leurs limites sont réunies dans l'encadré plus haut.