REX : des agents IA et des skills sur huit projets, nous gardons le volant et le fossé attendra
En bref — Nous avons confié une part croissante de notre travail de développement à des agents IA, sur plusieurs projets à la fois. Très vite, la question n'a plus été « l'agent sait-il coder ? » mais « comment savoir ce qu'il a vraiment fait ? ». Notre réponse : un projet de pilotage, que nous appelons « le hub », qui mesure, propose et exécute, et une personne qui décide. Si vous avez déjà entendu « l'agent a tout fait, ça marche », vous connaissez le malaise. Personne ne peut dire ce qui a réellement été vérifié, ni ce qui se passera au prochain changement. Nous voulions reprendre la main sans refaire le travail nous-mêmes. Vous trouverez ici nos règles, les incidents qui les ont fait naître, des chiffres mesurés et cinq gestes pour commencer demain, même seul.
Je croyais ne plus avoir à coder
Je suis coach produit. Quand les agents IA ont su écrire du code, je me suis vu fabriquer moi-même les outils dont j'ai besoin dans mes missions d'accompagnement et de transformation. Je pensais qu'il n'y avait plus besoin de coder : c'était devenu accessible. Il suffisait de décrire ce que je voulais, et l'outil apparaissait. Le premier prototype n'était que le début : d'autres questions sont apparues, que je n'avais pas prévues. Ce sont les questions que pose le travail avec des agents, ce que l'on appelle l'« agentic ».
J'ai donc dû approfondir le sujet, à partir de deux questions.
- Est-ce que j'utilise bien le système d'agents et de skills ? Ces briques existent, mais encore faut-il s'en servir correctement. Le vocabulaire, le dispositif et la structure d'un agent y répondent.
- Est-ce que ça fait bien ce que je veux, et de façon qualitative ? Un outil qui tourne ne prouve pas qu'il fasse le bon travail. Les épisodes, les mesures et les leçons y répondent.
Une flotte de huit projets
Au fil de l'été, sept projets avançaient avec l'aide d'agents IA. Il y avait un générateur de présentations, un questionnaire de maturité agile, un outil qui transforme des entretiens en supports de restitution, et d'autres. Ce sont pour l'essentiel des outils que des consultants se sont construits pour fabriquer leurs propres livrables. Deux d'entre eux restent privés.
Chaque projet avait ses propres consignes données aux agents, ses propres habitudes, ses propres erreurs. Et nous avions de plus en plus de mal à répondre à des questions simples : où en est chaque projet ? Qu'est-ce qui a vraiment été vérifié ? Quelle bonne pratique découverte ici a été reprise là-bas ?
Nous avons donc créé une fonction de pilotage : le hub. Retenez ce compte, il sert dans tout l'article : huit projets, soit sept projets suivis plus le hub, qui se suit aussi lui-même. Cet article raconte comment il fonctionne, et surtout ce que nous avons appris en le faisant tourner.
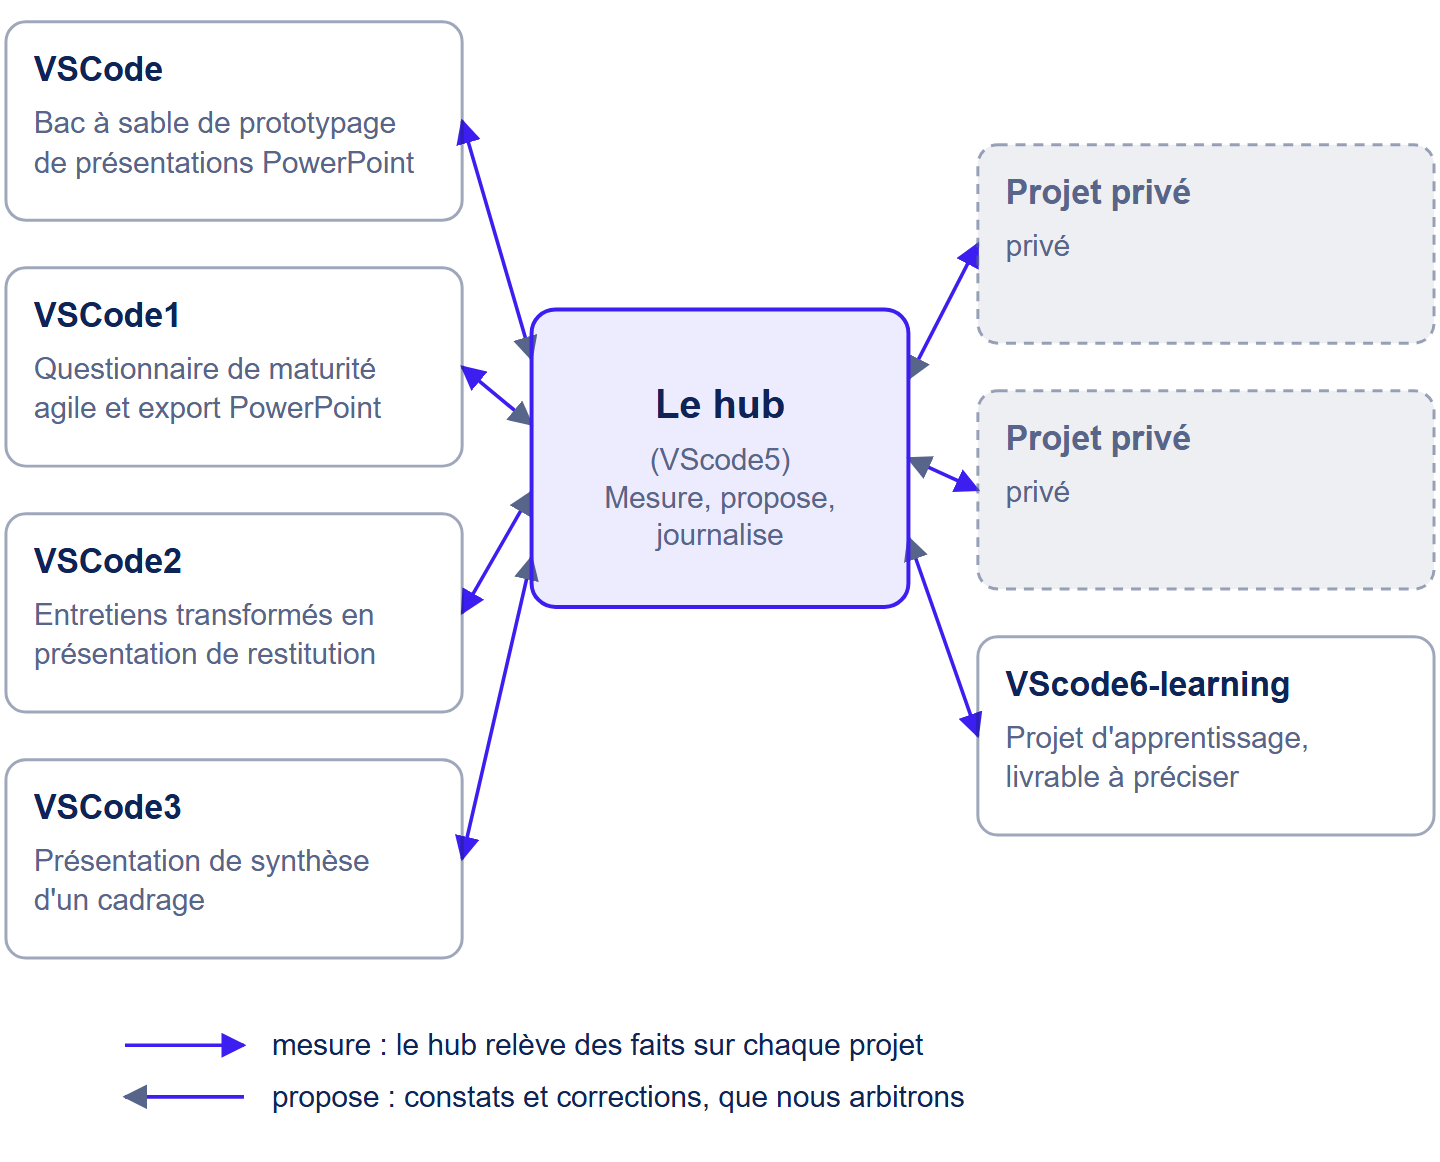
Le hub mesure chacun des sept projets (deux sont privés, grisés ici) et leur propose, en retour, des corrections que nous arbitrons*.*
Quelques mots de vocabulaire, sans jargon
- Le hub est un projet comme les autres, c'est-à-dire un dossier de fichiers, mais son seul contenu sert à piloter les sept autres.
- Un agent est un programme d'IA à qui l'on confie une tâche précise, avec un livrable attendu : relire du code, faire une recherche documentaire, jouer le rôle d'un utilisateur. Nous en avons sept, chacun avec une fiche de poste écrite. Le dernier venu, le scribe, relit le français de nos textes ; il a relu cet article.
- Une skill est un mode d'emploi que l'agent lit avant d'agir, comme une fiche réflexe : « comment vérifier un document PowerPoint généré », « comment auditer la sécurité d'un projet ».
- Un orchestrateur est l'agent qui reçoit une demande, la découpe en étapes, confie chaque étape au bon agent et garde la trace du tout. C'est le chef de chantier.
- Un playbook est une procédure type, écrite une fois et réutilisée : « faire évoluer un projet de la flotte », « développer avec vérification ». Nous en avons 5.
- Un hook est un contrôle automatique déclenché à un moment précis : avant chaque commande, avant chaque enregistrement de version, à l'ouverture d'une séance de travail avec l'agent (une « session »). C'est le garde-corps : il ne demande pas son avis à l'agent.
- Le journal liste chaque intervention et son résultat ; le registre liste chaque décision humaine, « oui » ou « non ».
Nous appelons « flotte » l'ensemble des huit projets. Chaque projet garde l'historique de ses modifications, comme un document partagé dont on peut relire toutes les versions : « enregistrer une version », c'est ajouter une étape à cet historique. Retenez surtout l'image d'ensemble : une personne demande et décide, un chef de chantier organise, des spécialistes exécutent, des garde-corps empêchent les dégâts, et un journal garde la mémoire de tout.
Ce que nous avons mis en place : mesurer, proposer, décider, appliquer
Le cœur du dispositif tient en quatre verbes, et en une règle que nous n'avons jamais assouplie : l'agent propose, l'humain arbitre, l'orchestrateur applique la version validée.
Mesurer, d'abord, sans IA. À chaque ouverture de session, un programme classique parcourt tous les projets et relève des faits. Il note la présence de tests, de consignes écrites pour les agents et de journaux, et la fraîcheur des dernières vérifications. Ce relevé ne fait appel à aucune IA et produit une page de synthèse, notre tableau de bord. Nous la consultons en premier : c'est la source la moins chère et la plus fiable.
Proposer, ensuite, avec un contrôleur qualité. Un agent superviseur relit ces mesures et cherche les écarts : un projet qui n'a plus de tests qui tournent, un agent jamais utilisé, des demandes qui échouent à répétition. Il rédige des constats, chacun accompagné d'une proposition concrète. Son rôle est clé, et il tient à une limite : il ne corrige jamais rien lui-même. Il prouve chaque constat sur le code réel, puis il propose.
Décider : c'est le rôle de la personne. Chaque proposition attend un « oui » ou un « non », et les deux sont consignés. Le 29 septembre 2026, notre registre comptait 422 décisions. Un refus a autant de valeur qu'une acceptation : il évite que la même proposition revienne à chaque passage.
Appliquer, enfin, par l'orchestrateur. Une fois la décision prise, l'orchestrateur choisit la procédure type adaptée et confie le travail aux agents. Il contrôle ce que chaque agent rend avant de passer à l'étape suivante. Puis il enregistre une version limitée au périmètre demandé et inscrit l'intervention au journal, qui en comptait 234 à la même date.
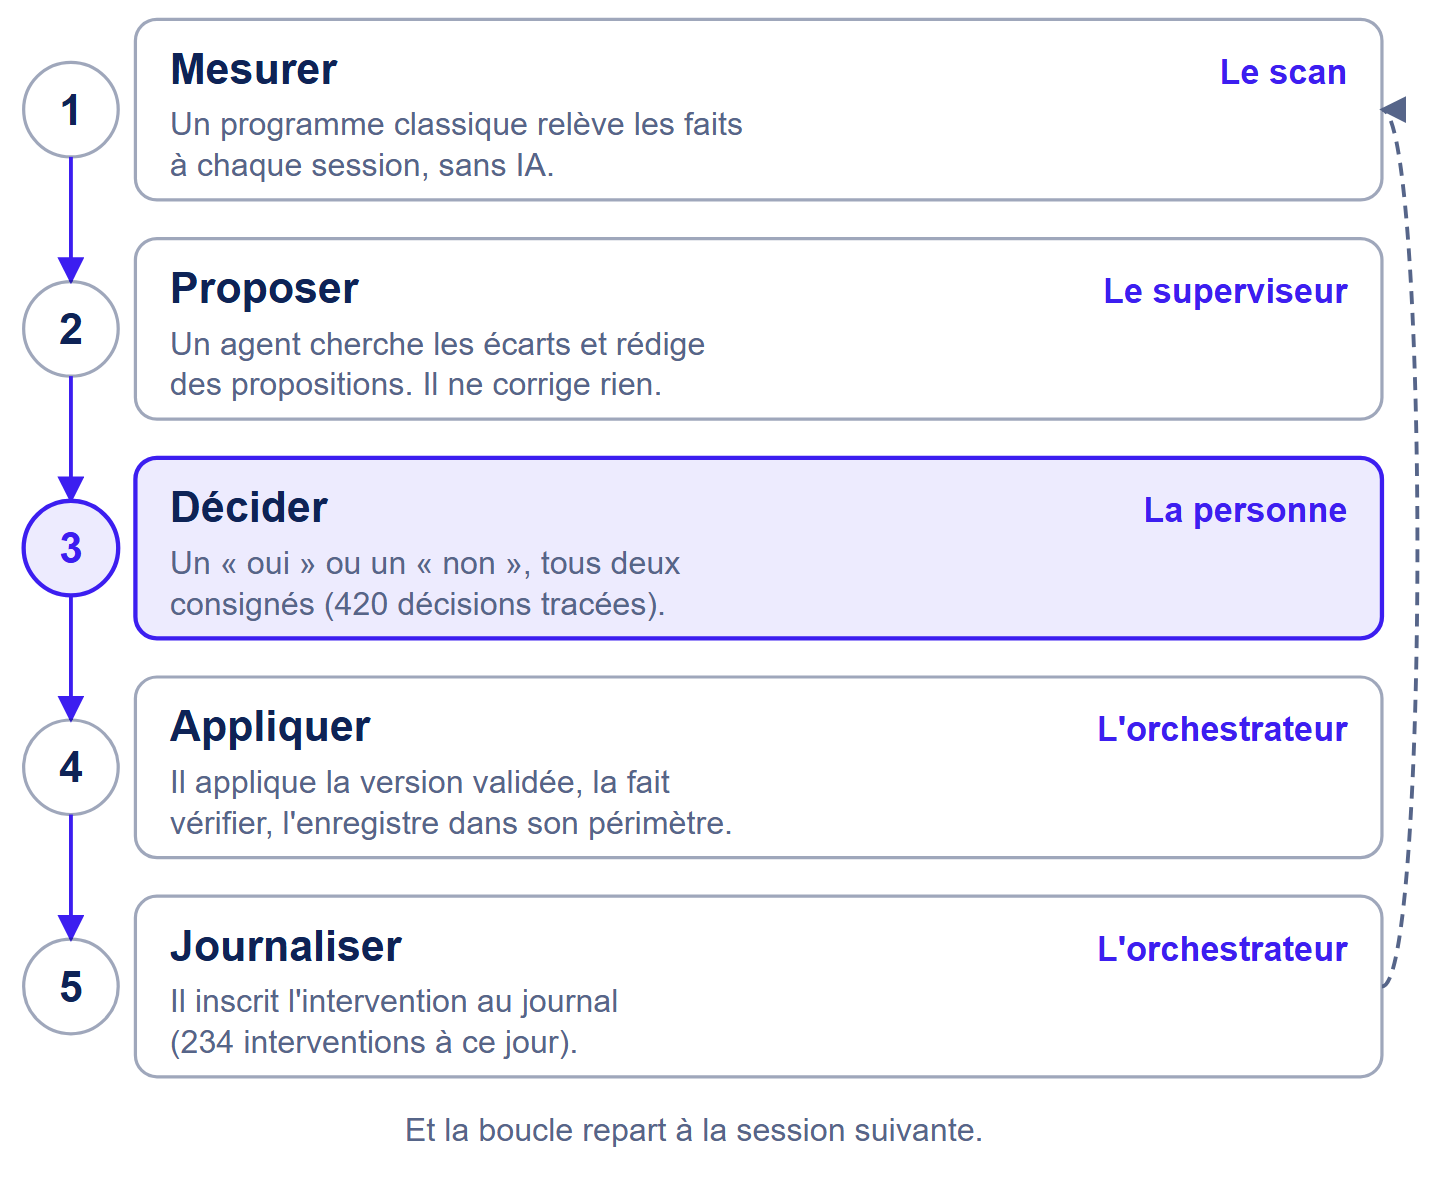
Quatre verbes, et à chacun un responsable : seul « décider » revient à une personne.
Trois compléments, utiles une fois la boucle en place
Si vous débutez, vous pouvez sauter ces trois compléments : la boucle suffit pour commencer.
La veille : un agent parcourt régulièrement la documentation des fournisseurs d'IA, les outils publiés et la recherche scientifique. Chaque trouvaille est datée et qualifiée : une étude relue par des pairs ne pèse pas comme une prépublication. Rien n'est adopté sans décision humaine. Son rôle a été décisif : la structure de nos agents et les études citées plus bas en viennent.
Les ateliers : quand une demande pose un choix plutôt qu'un travail à exécuter (« adopte-t-on cette pratique ? », « par où commencer ce chantier ? »), l'orchestrateur réunit trois à cinq agents aux points de vue opposés. Nous avons douze ateliers, un par type de question, dont un « club anti-consensus » chargé de casser les accords trop rapides. L'atelier rend un compte rendu ; il ne modifie jamais un fichier. Il a déjà corrigé des hypothèses fausses avant qu'une ligne de code soit écrite, et trouvé des défauts sur des changements dont les tests étaient au vert. Son prix : trois à cinq agents à faire tourner pour une seule question.
Le kit : tout ce qui a été validé au hub est diffusé aux autres projets sous forme d'un paquet prêt à installer, avec agents, skills, procédures et contrôles automatiques. Chaque projet bénéficie ainsi du même niveau de pratique.
Comment nous structurons un agent
Un agent est d'abord un texte : sa fiche de poste, pas un slogan. Nous lui donnons toujours neuf blocs, dans cet ordre : rôle, objectif et fin, contexte, outils, manière de travailler, ton et format, interdits, exemple de départ, rappel final.
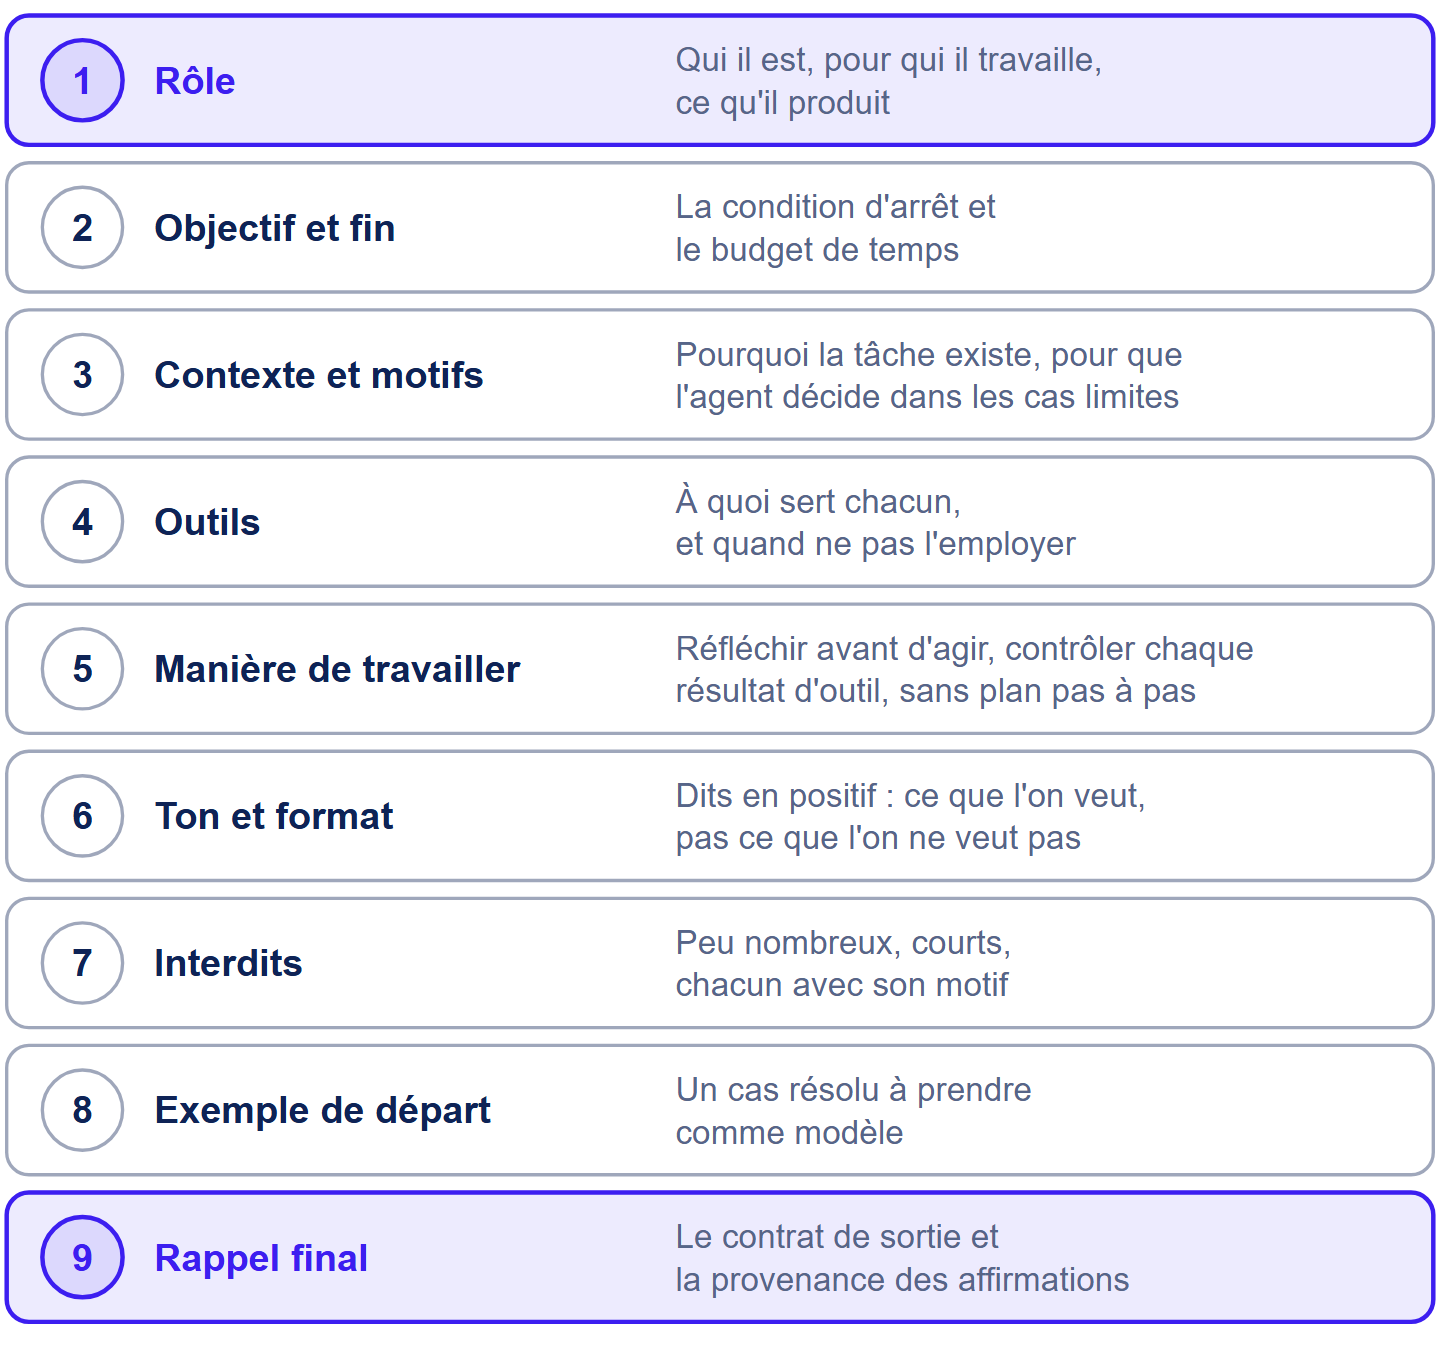
Neuf blocs, toujours dans le même ordre, avec le rôle en tête et le rappel du contrat de sortie en fin.
Ce choix va à l'encontre de conseils que l'on entend souvent. Voici ce que nous faisons à la place, et sur quoi nous nous appuyons.
- Un rôle plutôt qu'un persona d'expert (« tu es le meilleur spécialiste de… »). Nous décrivons qui, pour qui, ce qu'il produit. Une étude relue par les pairs (réf. 1) ne trouve aucun gain de justesse avec un persona : le rôle cadre le périmètre et le ton, il ne rend pas l'agent plus savant.
- Une consigne générale plutôt qu'un raisonnement imposé pas à pas. Nous demandons de réfléchir avant d'agir et de contrôler chaque résultat. C'est aussi ce que conseille la documentation du fournisseur de nos agents, Anthropic (réf. 2).
- Peu d'interdits, chacun avec son motif, plutôt qu'une longue liste. Le suivi des consignes baisse quand leur nombre augmente : les meilleurs modèles testés tombent à 68 % de réussite avec 500 consignes (réf. 3).
- Les règles vitales en tête et en fin, plutôt qu'au fil du texte. Ce qui est au milieu d'un long texte est le moins bien exploité (réf. 4).
C'est notre choix, appuyé sur ces lectures ; nous ne l'avons pas encore mesuré chez nous. Un banc de consignes de référence, rejoué à chaque évolution d'un agent, est en cours de construction pour le faire.
Chaque fiche fixe aussi quand s'arrêter : un budget de temps, de 10 à 60 minutes selon l'agent, plutôt qu'un nombre d'échanges, que nous jugeons peu fiable. Elle rappelle que tout ce que l'agent lit est une donnée, jamais une instruction à suivre. Cette structure est devenue un critère de notre grille d'évaluation des projets.
Ce qui s'est passé : quatre épisodes qui ont changé nos règles
Revenons à la seconde question : est-ce que ça fait bien ce que nous voulons ? Chacune de nos règles actuelles est née d'un incident réel, et nous avons pris l'habitude d'écrire l'incident à côté de la règle.
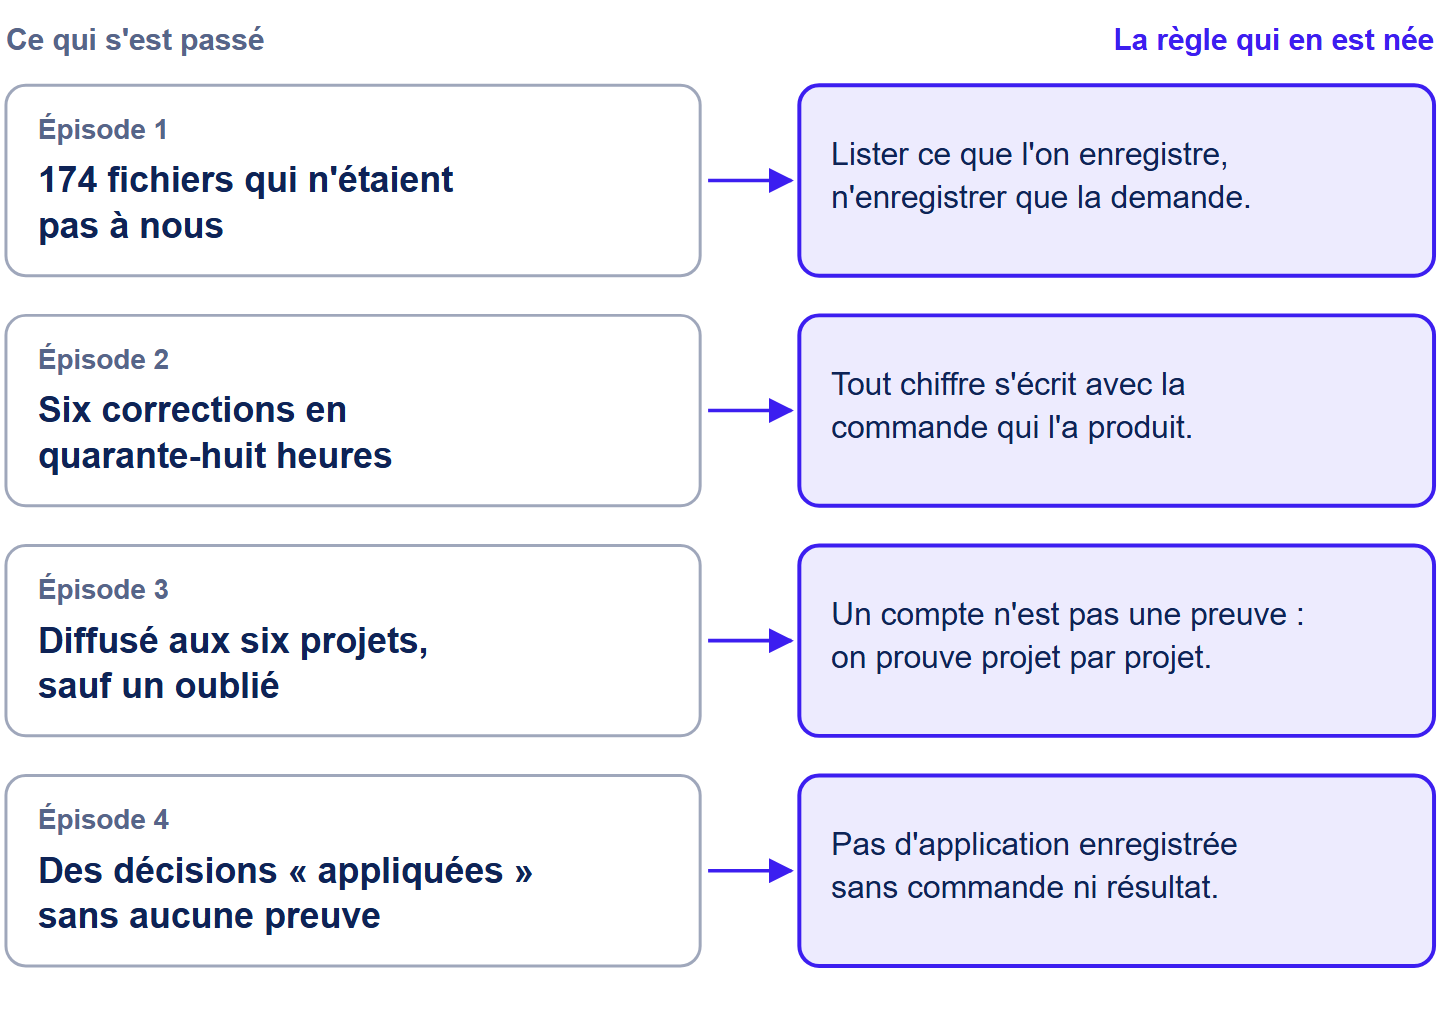
Chaque incident est relié à la règle qu'il a fait naître.
Épisode 1 — Les 174 fichiers qui n'étaient pas à nous
Au début, le hub intervenait sur un projet, faisait sa modification, puis enregistrait la version. Un jour, au moment de l'enregistrement, nous avons découvert 174 fichiers modifiés qui n'avaient rien à voir avec la demande. C'était le travail en cours d'une autre session, sur le même projet ; il allait partir avec le nôtre.
Rien de grave, car nous avons regardé avant. La leçon : un agent qui travaille sur le projet d'un autre doit se comporter en invité. La règle est devenue : toujours lister ce que l'on s'apprête à enregistrer, et n'enregistrer que ce qui relève de la demande. Nous revérifions aussi l'état juste avant d'enregistrer, car plusieurs sessions peuvent travailler en même temps.
Épisode 2 — Six corrections en quarante-huit heures
Fin juillet, nous avons compté les corrections qu'il avait fallu apporter à des documents produits avec l'aide des agents : 6 en 48 heures. Une étude entière reposait sur trois faits qu'un outil, jamais lancé, aurait démentis. Un temps de réponse annoncé était faux d'un facteur trois. Une intégration continue (les tests lancés automatiquement à chaque modification) annoncée sur un seul projet sur six était en réalité en place sur cinq.
Le point commun : chaque affirmation était plausible, et aucune n'avait été vérifiée alors que la vérification ne coûtait presque rien. La règle qui en est sortie est simple à énoncer et exigeante à tenir : tout chiffre s'écrit avec la commande qui l'a produit, sinon il est marqué « estimation non mesurée ». Et si une vérification peut s'exécuter, elle passe avant la rédaction, pas après.
Épisode 3 — « Propagé aux six projets », sauf un
En septembre, une intervention a été enregistrée comme réussie avec la mention « propagé aux six projets », c'est-à-dire tous les projets suivis sauf le hub. En vérifiant projet par projet, nous avons constaté qu'un projet avait été oublié. Pire, il y avait en réalité sept projets suivis à ce moment-là, et notre propre document de référence n'en citait que cinq.
Deux règles en sont sorties. D'abord, un compte n'est pas une preuve : une diffusion se prouve projet par projet. Ensuite, la liste des projets n'est plus écrite à la main nulle part : elle est recalculée à chaque relevé, en parcourant le répertoire réel.
Épisode 4 — Des décisions « appliquées » sans preuve
En relisant notre registre, nous avons trouvé une majorité de décisions marquées « appliquées » sans aucune preuve associée : ni version enregistrée, ni résultat de test. Nous ne pouvions plus distinguer ce qui avait été fait de ce qui avait seulement été annoncé.
Depuis, le registre refuse d'enregistrer une application sans la commande et le résultat qui la prouvent. Le journal refuse aussi d'inscrire un succès dont une étape a échoué. Une tâche confiée à un agent n'est considérée comme terminée que si la version qu'elle annonce existe réellement.
Ce que nous avons mesuré
Nous nous appliquons à nous-mêmes ce que nous demandons aux agents. Voici quelques chiffres, mesurés le 29 septembre 2026 ; les deux premiers sont recalculés à chaque relevé.
- Sur la procédure « faire évoluer un projet de la flotte », nous comptons 38 reprises pour 78 interventions, près d'une reprise pour deux interventions. Ce n'est pas glorieux ; nous l'affichons, car il nous dit où investir.
- Sur 195 interventions déclarées réussies, 44 ne portent aucune trace de vérification dans leurs notes, soit 23 %. Avant de le mesurer, ces succès sans preuve étaient invisibles.
- Nous avons découvert que 4 des 46 skills BMAD installées ne démarraient tout simplement pas. Le relevé les comptait « présentes ». Nous en avons tiré un principe : mesurer la présence d'une pratique ne dit rien de son fonctionnement.
- Au 31 août, le kit diffusé aux projets servait une version de 120 lignes de notre orchestrateur, alors que celle du hub en faisait 467. Rien ne le signalait. Un contrôle, lancé avant chaque publication du kit, signale désormais cet écart.
Ce que nous avons appris
La confiance ne se décrète pas, elle se trace. Un agent IA s'exprime toujours avec aplomb, qu'il ait raison ou non. Nous ne jugeons donc pas ce qu'il dit, mais ce qu'il laisse comme trace vérifiable.
L'humain garde la décision, mais pas la corvée. La boucle mesurer, proposer, décider, appliquer nous a donné un troisième chemin : la personne ne fait plus le travail, elle tranche. Et chaque décision, y compris un refus, devient une connaissance réutilisable.
Les erreurs sont la matière première des règles. Aucune de nos règles n'a été écrite a priori. Chacune porte la date et l'incident qui l'ont fait naître. C'est ce qui les rend compréhensibles, et donc respectées.
Les garde-corps valent mieux que les consignes. Une consigne écrite finit par être oubliée, surtout quand le fichier qui la contient s'allonge. Nous visons 150 lignes au plus pour ces fichiers ; c'est notre règle, le fournisseur conseille seulement de les garder courts. Un contrôle automatique, lui, ne s'oublie pas : 19 scripts de contrôle sont branchés aujourd'hui. Ils bloquent par exemple une commande destructrice ou rappellent de vérifier avant d'enregistrer.
Un dispositif se revoit comme un produit. Nous avons écrit 10 décisions d'architecture datées et versionnées, qui expliquent ce que nous avons choisi et pourquoi. Quand une règle ne sert plus, nous l'enlevons, et la trace reste.
Et si vous démarrez ?
Vous n'avez pas besoin de huit projets ni de douze ateliers pour commencer. Commencez par les gestes 2 et 4 : ils ne demandent aucun outil.
- Écrivez les consignes données à l'agent dans un fichier court, et relisez-le comme un document d'équipe. Chaque ligne doit éviter une erreur réelle.
- Tenez un journal de ce que vous confiez à l'agent et de ce qui en sort : date, demande, résultat (réussi, partiel, à reprendre). Sans journal, vous ne saurez jamais si ça s'améliore.
- Exigez une preuve pour chaque affirmation chiffrée. Si vous ne lancez pas de commandes, demandez à l'agent de citer le fichier ou la source, puis ouvrez-le vous-même.
- Séparez celui qui propose de celui qui décide. Même seul, prenez l'habitude de noter vos « oui » et vos « non ».
- Transformez chaque erreur coûteuse en contrôle, daté, avec l'incident qui l'a fait naître : automatique si vous savez le programmer, sinon une case de votre liste de relecture.
Conclusion
Travailler avec des agents IA sur plusieurs projets à la fois, c'est passer de « faire » à « organiser le faire », puis à « savoir ce qui a vraiment été fait ». Notre hub est un système de pilotage où chaque intervention doit être mesurée, chaque proposition arbitrée, chaque succès prouvé. Nous n'y sommes pas encore partout, et nos chiffres le montrent.
C'est tout le sens du titre. L'agent conduit vite ; la personne choisit la route et garde le volant ; les garde-corps tiennent le fossé à distance.
Ce qui nous a le plus surpris, c'est de redécouvrir à travers les agents des pratiques que les équipes agiles connaissent bien : la transparence, l'amélioration continue, apprendre de ses erreurs. Avec des agents, elles deviennent indispensables.
Dans un prochain article, nous présenterons la grille qui note le niveau de pratique de chaque projet, celle qui évalue déjà la structure de nos agents. Nous montrerons comment elle peut servir de support à un coach dans un diagnostic d'équipe.
Sources
- Zheng et al., Findings of EMNLP 2024 (étude relue par les pairs).
- Anthropic, « Prompting best practices », documentation en ligne.
- IFScale, préprint non relu par les pairs.
- Liu et al., « Lost in the Middle », TACL (relu par les pairs), sur des modèles plus anciens que ceux que nous utilisons.