Plugin Modernization by Anthropic
Plugin Modernization by Anthropic
Avant l’essor des approches agentiques, moderniser un système legacy exigeait du courage, de la persévérance et une solide maîtrise technique. Ces projets pouvaient mobiliser pendant plusieurs mois de nombreux professionnels, avec un budget parfois difficile à engager. Les équipes s’appuyaient notamment sur les principes et les pratiques du Domain-Driven Design et du Software Craftsmanship pour comprendre le métier, maîtriser les dépendances et faire évoluer le code progressivement.
L’arrivée des agents ne remet pas en cause ces fondements, mais fait évoluer une partie de la démarche. L’un des changements les plus visibles concerne la transformation du code : le refactoring progressif peut désormais céder la place à la génération d’une nouvelle implémentation à partir des règles métier extraites du système existant.
La réussite repose alors sur la qualité de cette compréhension préalable : expliciter les règles métier, reconstituer l’architecture et cartographier les dépendances entre les modules. Les agents peuvent accélérer et systématiser ce travail d’analyse, tandis que l’expertise humaine reste essentielle pour vérifier les résultats, lever les ambiguïtés et orienter les choix de transformation.
Le plugin Modernization incarne cette évolution : il propose un cadre pour organiser l’exploration de l’existant, en extraire les connaissances utiles et conduire les transformations à partir d’éléments documentés et validés.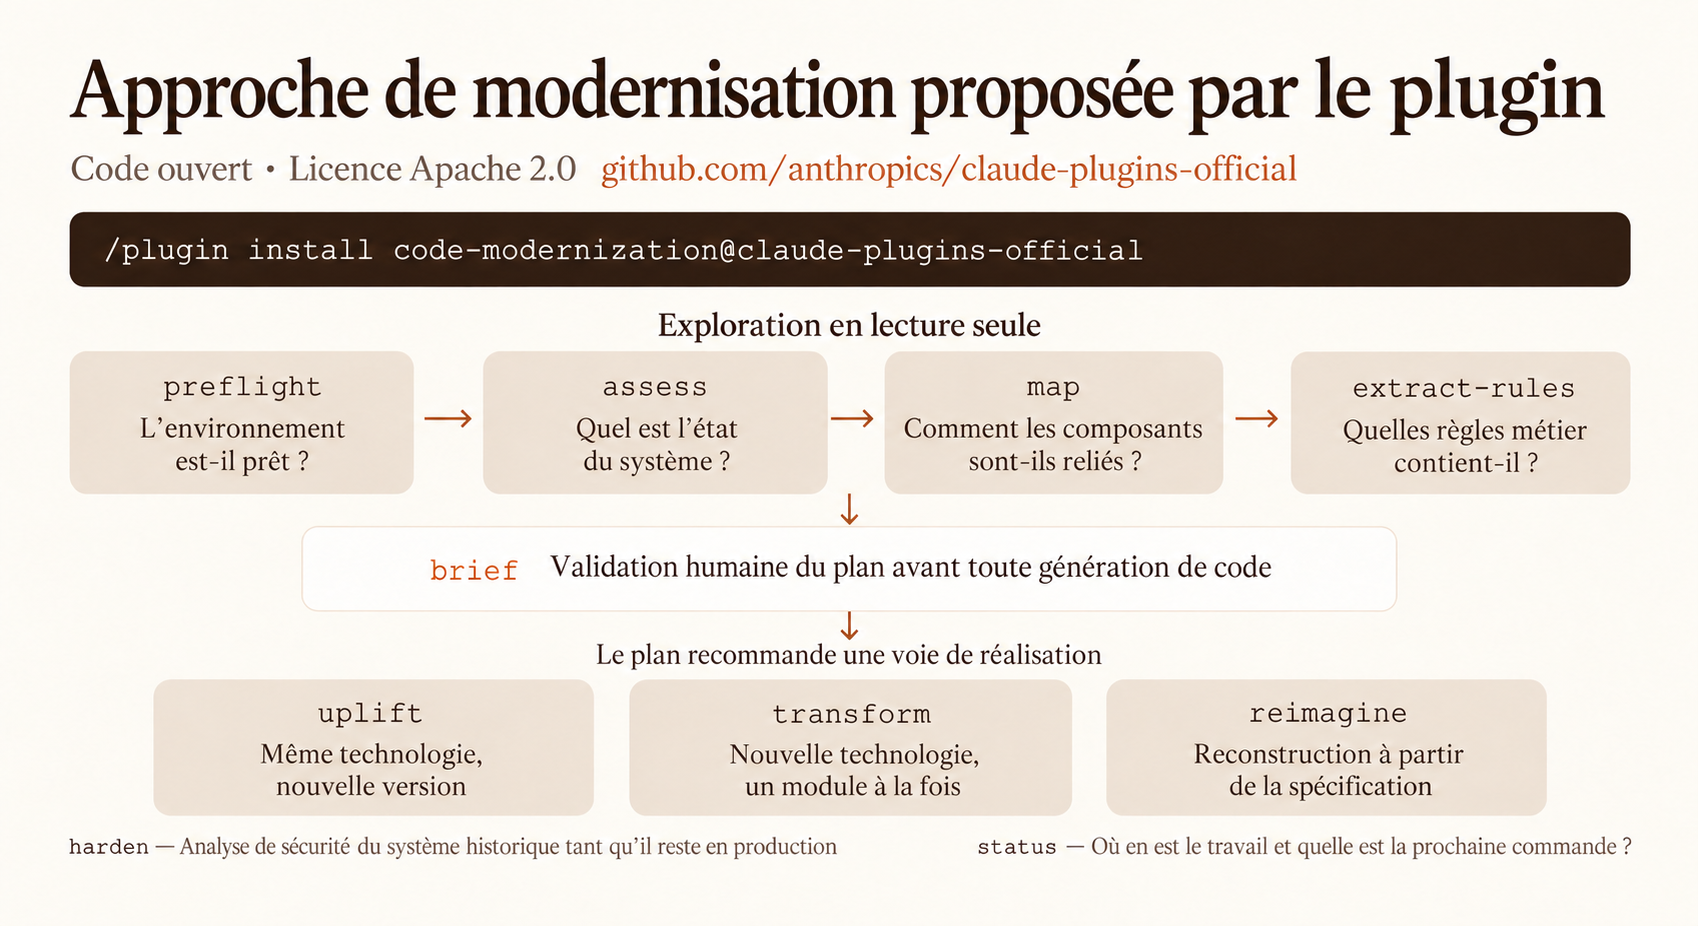
Le plugin est disponible en open source sur le dépôt GitHub d’Anthropic. Vous pouvez donc l’adapter à vos besoins, dans le respect de sa licence.
Au sommaire
- Pourquoi s’intéresser à ce plugin ?
- Pourquoi un système legacy freine l’équipe
- Quel problème souhaitez-vous résoudre ?
- Comprendre le système avant de le transformer
- Trois voies selon l’ampleur du changement
- Monter de version sans tout réécrire
- Réécrire progressivement dans une autre technologie
- Reconstruire sur une nouvelle architecture
- Vérifier la modernisation et examiner la sécurité
- Rehost et Replace : déplacer ou remplacer le système
- Une architecture multi-agents pour répartir le travail
- Des artefacts pour conserver et partager la connaissance
- Le contrôle humain au cœur du processus
- Conclusion : comprendre, choisir, vérifier
1. Pourquoi s’intéresser à ce plugin ?
Dès l’apparition des agents IA, des équipes pionnières ont cherché à les utiliser pour moderniser des bases de code legacy. Nous disposons aujourd’hui de plusieurs mois de recul sur des modernisations réussies, conduites selon une démarche proche de celle que propose le plugin.
Cette démarche commence par la rétrodocumentation de l’existant. Il s’agit de reconstituer, à partir du code, ce qu’il faut savoir pour comprendre l’application : son fonctionnement, ses règles métier et ses dépendances. Une fois vérifiées et validées par les équipes, ces connaissances servent de socle pour définir la cible et préparer la transformation.
Plusieurs trajectoires s’ouvrent alors. On peut rénover l’application sans changer de technologie, la migrer vers une autre technologie, ou repenser plus profondément son architecture et ses usages. Le choix dépend des besoins métier, des contraintes techniques et de l’ampleur du changement visé.
Dans la pratique, la mise en œuvre reste pourtant souvent artisanale. Disposer d’agents ne suffit pas : il faut organiser leurs interventions, leur fournir le bon contexte et contrôler leurs résultats. Ce cadre d’exécution, que l’on appelle parfois « harnais agentique », demande un vrai travail de conception.
C’est précisément ce que le plugin cherche à structurer. Il enchaîne les activités, organise les validations et produit des livrables dont on peut examiner la cohérence, la complétude et la traçabilité.
Reste à savoir ce que cette proposition open source peut apporter à nos pratiques. Encore jeune, son dernier commit date de septembre 2026, le plugin mérite d’être confronté à notre expérience. Quels choix fait-il ? Quelles tâches facilite-t-il ? Quels résultats permet-il d’obtenir ? Cette analyse vise à identifier ses apports, ses limites et ce dont nous pourrions nous inspirer.
2. Pourquoi un système legacy freine l’équipe
Un système legacy est un système hérité qui rend toujours des services, souvent essentiels, mais qu’il devient difficile de faire évoluer. Son âge n’est pas un problème en soi. Les difficultés apparaissent lorsque sa maintenance absorbe une part croissante des efforts et réduit la capacité de l’équipe à répondre aux nouveaux besoins.
Trois difficultés qui se renforcent
Le poids de la maintenance. Corriger les incidents, contourner les limitations, composer avec la dette technique : tout cela prend du temps. L’équipe consacre alors davantage d’énergie à maintenir le service qu’à l’améliorer.
La perte des compétences et de la connaissance. Les personnes qui maîtrisent les technologies en place, ou qui connaissent les raisons des choix passés, finissent par partir. Si leur savoir n’a pas été transmis, chaque modification exige plus d’investigation et comporte plus d’incertitude.
Les risques techniques. Certaines dépendances ne sont plus maintenues, les correctifs deviennent difficiles à appliquer et les exigences de sécurité continuent d’évoluer. Maintenir le système dans de bonnes conditions devient de plus en plus complexe.
Ces trois difficultés s’alimentent entre elles. La perte de connaissances ralentit les interventions ; une maintenance plus lourde laisse moins de temps pour documenter et moderniser ; pendant ce temps, les risques s’accumulent.
Retrouver la connaissance avant de transformer
Dans un système ancien, certaines règles métier n’existent que dans le code : une condition particulière, une exception dans un calcul, un traitement exécuté chaque nuit. D’autres ne sont connues que de quelques experts.
Avant toute transformation, il faut donc retrouver cette connaissance, la documenter et la faire valider. L’enjeu est de distinguer les comportements indispensables au métier de ceux qui relèvent d’une anomalie ou d’une contrainte devenue obsolète. Sans ce travail, une réécriture peut faire disparaître des fonctions essentielles, même si le nouveau code paraît plus simple.
Un repère pour ouvrir la discussion
Selon une enquête Stripe/Harris Poll publiée en 2018, les développeurs estiment consacrer environ 42 % de leur temps à la dette technique et au code de mauvaise qualité, plutôt qu’à de nouvelles fonctionnalités.
Ce chiffre est un repère historique, non une mesure de la situation de chaque équipe. Pour décider d’un investissement, mieux vaut examiner les difficultés concrètes du système : temps passé en interventions, fréquence des incidents, délais d’évolution, dépendance à quelques personnes clés.
3. Quel problème souhaitez-vous résoudre ?
« Moderniser » peut recouvrir des réalités très différentes. Avant de choisir une solution, il faut identifier la dimension sur laquelle porte le problème, sachant que plusieurs dimensions se combinent souvent.
| Dimension | Ce que l’on fait évoluer | Exemples |
| Langage et technologies | On adopte un langage ou un environnement mieux maintenu. | C vers Java ; VB6 vers C#/.NET ; Perl vers Python |
| Plateforme d’exécution | On change la manière d’héberger et d’exécuter les traitements. | Traitements planifiés vers fonctions serverless (exécutées à la demande, sans serveur à gérer) ; serveurs sur site vers Kubernetes (plateforme d’orchestration de conteneurs) |
| Architecture | On redéfinit le rôle de chaque composant et les frontières entre eux. | Séparer la gestion des ordres, le calcul du risque et le règlement |
| Intégrations | On fait évoluer les échanges avec les autres applications et les partenaires. | Échanges de fichiers par FTP vers des API REST, tout en restant compatible avec les fichiers existants |
| Pratiques de développement | On fiabilise la construction, les tests et la mise en production. | Intégration et déploiement continus (CI/CD) ; infrastructure décrite par du code |
Deux mises en garde
- La technologie à la mode n’est pas une fin en soi. Le cloud et les micro-services sont des options parmi d’autres. Une architecture se choisit pour répondre à un besoin précis, et le bénéfice attendu doit justifier la complexité supplémentaire à exploiter au quotidien.
- Un changement technique peut modifier le métier. Remplacer un traitement de nuit par des événements en temps réel, par exemple, change le moment où les données deviennent disponibles, et les utilisateurs s’en apercevront. Ces conséquences doivent donc être définies et validées avec eux, au même titre que le code.
4. Comprendre le système avant de le transformer
Une démarche de modernisation ne commence pas forcément par une transformation du code. La première demande est souvent plus fondamentale : « Aidez-nous à comprendre ce que fait réellement notre système. » C’est tout l’objet de la rétrodocumentation.
Rétrodocumenter, c’est reconstituer à partir du code existant une documentation absente, incomplète ou dépassée. On cherche à comprendre ce qui est réellement implémenté : quelles règles s’appliquent, comment les traitements s’organisent, quelles dépendances relient les composants.
Dans un système ancien, une partie de cette connaissance ne subsiste que dans le code ou dans la mémoire de quelques experts. La rendre explicite permet de la partager, d’en débattre et de prendre des décisions mieux étayées.
La rétrodocumentation répond à des besoins très concrets : préparer le départ d’un expert, accueillir de nouveaux développeurs, répondre à un audit ou éclairer une décision d’investissement. Elle peut être un objectif en soi, ou préparer une modernisation selon l’une des voies Uplift, Transform ou Reimagine.
Trois regards complémentaires sur le système
Les règles métier. Ce sont les calculs, conditions et exceptions qui déterminent les décisions du système. À partir de quel montant un ordre est-il bloqué ? Comment traite-t-on un paiement reçu après l’échéance ? Ces règles sont parfois dispersées dans plusieurs programmes ; les rassembler et les reformuler permet aux équipes métier de les examiner.
L’architecture. Il s’agit des principaux composants, de leurs responsabilités et de leurs interactions. Cette vue montre où entrent les données, quels traitements s’exécutent en différé et comment le système échange avec ses partenaires. Elle offre un langage commun aux équipes techniques et métiers.
Les dépendances entre modules. Appels, données partagées, contraintes d’exécution : cette cartographie aide à anticiper les effets d’une modification et à choisir un premier périmètre. Un module peu dépendant des autres, par exemple, fait un bon candidat pour un pilote.
La démarche du plugin en deux phases
- Explorer. Le code existant est analysé en lecture seule, sans aucune modification. Cette phase aboutit à un plan que vous validez selon vos attentes.
- Exécuter. Le plan est mis en œuvre selon la stratégie retenue :
- Uplift : une montée de version sur la même technologie ;
- Transform : une migration vers une nouvelle technologie ;
- Reimagine : une reconstruction à partir d’une nouvelle spécification.
Un parcours outillé, commande après commande
Le plugin accompagne l’exploration par une succession de commandes, chacune enrichissant la connaissance produite par les précédentes. Dans les exemples qui suivent, le système étudié s’appelle order-service ; ses résultats sont regroupés dans le dossier analysis/order-service/.
Pour être guidé dès le départ, on utilise la commande d’entrée :
/code-modernization:modernize order-service --source /chemin/vers/le/codeElle pose quelques questions, localise le code et oriente vers les étapes adaptées. Pour une démarche de rétrodocumentation, l’option Understand it first, lance l’analyse sans engager de reconstruction.
Étape 1 — Vérifier les conditions de départ
On commence par préciser le périmètre et les conditions d’analyse. Le plugin interroge l’utilisateur sur la compilation, les tests disponibles, les outils particuliers, les tentatives de migration antérieures et les restrictions à respecter.
Il vérifie aussi que le code peut effectivement être compilé. Si ce n’est pas le cas, cette limite doit être identifiée, car elle conditionne les vérifications possibles par la suite.
# Syntaxe : <system> [target-stack] [--source <path>]

/code-modernization:modernize-preflight order-service --source /chemin/vers/le/code
Réponses et vérifications sont consignées dans PREFLIGHT.md, qui signale les obstacles à lever avant de poursuivre.
Étape 2 — Évaluer pour établir un état des lieux
L’évaluation dresse un premier état des lieux : technologies utilisées, complexité du code, dette technique et risques de sécurité. Elle esquisse aussi une orientation architecturale, qui reste une hypothèse à approfondir.
# Syntaxe : <system> [--show-secrets] | --portfolio <parent-dir>

/code-modernization:modernize-assess order-service
Les résultats sont rassemblés dans ASSESSMENT.md. Le mode --portfolio étend l’évaluation à plusieurs systèmes regroupés dans un même dossier, pour obtenir une vue d’ensemble du parc applicatif.
Étape 3 — Cartographier les composants et les flux
On reconstitue ensuite la topologie du système : composants, dépendances, points d’entrée, circulation des données et principaux flux métier.
# Syntaxe : <system> [--graph <file>] [--no-describe]

/code-modernization:modernize-map order-service
La carte interactive est produite dans TOPOLOGY.html, à partir des données de topology.json. Elle permet d’explorer les relations entre composants et de suivre le cheminement des appels derrière un comportement métier. Sur un système volumineux, c’est un appui précieux pour examiner les dépendances avant toute modification.
Étape 4 — Extraire les règles métier
L’extraction rend lisibles les comportements enfouis dans le code. Les agents reformulent chaque règle en scénario testable selon la structure Given / When / Then : une situation initiale, un événement, un résultat attendu.
# Syntaxe : <system> [module-pattern]

/code-modernization:modernize-extract-rules order-service
Les règles sont regroupées dans BUSINESS_RULES.md sous forme de fiches numérotées. Chacune renvoie à un emplacement précis du code source et fait l’objet d’une seconde vérification indépendante.
Cette traçabilité permet de remonter à l’origine d’une règle et d’en discuter l’interprétation. Elle ne remplace pas pour autant la validation métier : les règles extraites doivent être relues par celles et ceux qui connaissent le domaine.
Étape 5 — Préparer la suite, si une transformation est envisagée
Lorsque l’objectif va au-delà de la compréhension, les connaissances recueillies alimentent un plan de modernisation progressif.
# Syntaxe : <system> [target-stack]

/code-modernization:modernize-brief order-service
La commande produit MODERNIZATION_BRIEF.md, qui formalise la cible, les contraintes et le déroulement proposé. Ce document sert de référence pour la réalisation et doit être explicitement approuvé avant toute transformation.
Si la rétrodocumentation est l’objectif du projet, les documents produits et validés constituent déjà un livrable utile, sans aucune modification du système.
Une connaissance à valider et à entretenir
La documentation extraite du code décrit ce que le système fait, pas forcément ce qu’il devrait faire. Elle peut révéler des anomalies, des exceptions oubliées ou des comportements devenus obsolètes. La revue humaine permet de faire le tri entre les règles à préserver et les comportements à corriger.
Cette documentation doit enfin rester accessible dans les outils de l’équipe et évoluer avec le système. Son entretien fait partie du travail de développement : sans mises à jour régulières, elle perd peu à peu sa fiabilité et son utilité.
5. Trois voies selon l’ampleur du changement
Une fois la stratégie définie, comment passer à la réalisation ? Le plugin propose trois voies, de la plus légère à la plus profonde : Uplift, Transform et Reimagine. Chacune associe une démarche de réalisation à des contrôles qui permettent d’en vérifier les résultats.
L’image d’une maison aide à les distinguer :
- Uplift, c’est rénover : on garde la structure et l’on remet à niveau ce qui en a besoin.
- Transform, c’est reconstruire pièce par pièce avec de nouveaux matériaux, tout en continuant d’habiter la maison.
- Reimagine, c’est redessiner les plans pour bâtir une nouvelle maison à partir des besoins de ses occupants.
Un arbre de décision pour orienter le choix
L’arbre de décision aide à répondre à une question centrale : jusqu’où faut-il transformer le système ? Il se parcourt question après question, chaque réponse négative conduisant à examiner l’option suivante. Les trois voies que le plugin met en œuvre par une commande y figurent en couleur.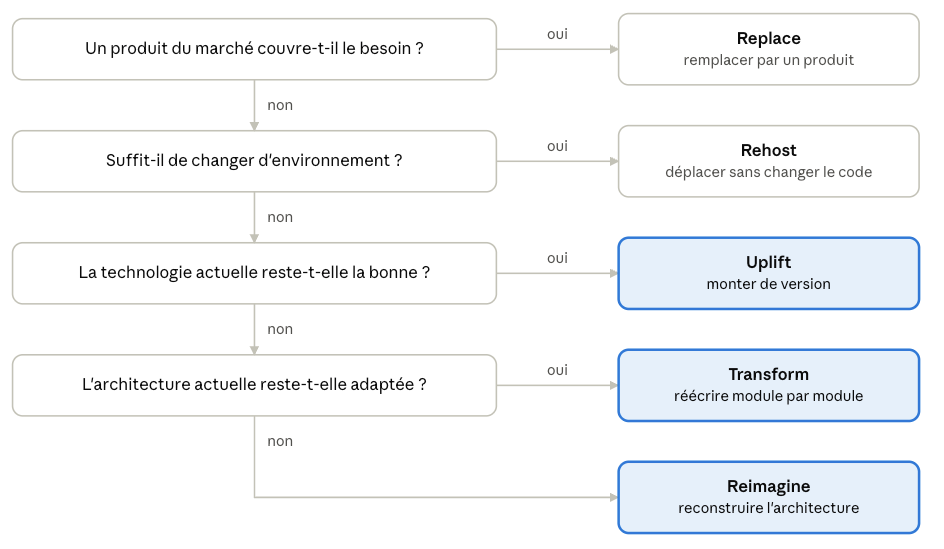
Cet arbre est une aide à la réflexion, à confronter aux contraintes réelles du projet. Plus une transformation est profonde, plus elle demande généralement de travail, de moyens et de prise de risque : elle doit donc être justifiée par les besoins.
Ce que chaque voie conserve, transforme et vérifie
| Voie retenue | Ce que l’on conserve | Ce qui change | Comment on vérifie |
| Uplift | L’essentiel du code et la logique métier | La version du langage ou du framework, avec les adaptations nécessaires | La même suite de tests est exécutée sur la version d’origine et sur la version cible |
| Transform | Les comportements attendus du système | La technologie, progressivement, module par module | Les deux implémentations reçoivent les mêmes entrées et leurs résultats sont comparés |
| Reimagine | La connaissance métier extraite du système et validée par l’équipe | L’architecture et la manière d’implémenter les fonctionnalités | Des tests d’acceptation et des vérifications progressives accompagnent la reconstruction |
Le choix dépend donc de ce qu’il faut préserver et de ce qui doit évoluer : la version technique, la technologie elle-même ou l’organisation du système.
6. Monter de version sans tout réécrire
Quand l’utiliser Uplift ? Lorsque la technologie reste adaptée mais que sa version doit évoluer. L’objectif est de conserver l’essentiel du code et d’y apporter les adaptations nécessaires pour le rendre compatible avec la version cible.
Il peut s’agir de passer de Java 8 à Java 25, de Spring Boot 2 à Spring Boot 4, ou de .NET Framework à .NET 10. L’ampleur du travail dépend des fonctionnalités et des dépendances utilisées par l’application.
/code-modernization:modernize-uplift <name> [source-version] [target-version]La démarche commence par un catalogue des incompatibilités (delta catalog). Il recense les différences entre les versions qui ont un impact réel sur le code analysé. L’équipe concentre ainsi ses efforts sur les adaptations nécessaires, sans passer en revue toutes les nouveautés de la version cible.
Une première partie du système sert ensuite de pilote. Sur ce périmètre limité, on éprouve la démarche, on repère les difficultés et on documente les solutions. Le reste du code est alors traité par lots, en s’appuyant sur ces enseignements.
Le parcours minimal compte quatre étapes :
- Preflight, pour vérifier les conditions de départ ;
- Assess, pour évaluer les changements nécessaires ;
- Uplift, pour réaliser les adaptations ;
- Verify, pour contrôler le résultat.
L’extraction et la revue des règles métier peuvent ici être omises, dès lors que les adaptations préservent la logique existante. Pour un système de grande taille, une cartographie et un plan complètent le parcours : ils définissent les lots, leurs dépendances et un ordre de traitement approuvé avant les travaux.
La vérification consiste à exécuter la même suite de tests sur la version d’origine et sur la version cible, puis à comparer les résultats. Leur concordance montre que les comportements couverts par les tests ont été préservés, d’où l’importance décisive de la couverture de cette suite.
Enfin, si l’analyse révèle qu’il faudrait réécrire l’essentiel du code, le plugin doit le signaler et orienter vers la voie Transform. Ce point de contrôle permet de réévaluer la stratégie lorsque les travaux dépassent le cadre d’une simple montée de version.
7. Réécrire progressivement dans une autre technologie
Quand l’utiliser Transform ? Lorsque la technologie doit changer, mais que l’on souhaite avancer module par module. Le système historique continue de fonctionner pendant la transition, pendant que ses composants sont réécrits un à un.
/code-modernization:modernize-transform <name> [module] [target-stack]La démarche s’appuie sur un plan approuvé, qui fixe le périmètre de la réécriture et l’ordre des travaux. Elle repose aussi sur des tests de caractérisation : ils décrivent les comportements observables du système historique et servent de référence pour vérifier la nouvelle implémentation.
L’objectif est de préserver les comportements attendus tout en adoptant les bonnes pratiques de la technologie cible. Il ne s’agit donc pas de traduire le code ligne à ligne, mais de réécrire chaque module selon les conventions et les possibilités du nouvel environnement.
Pour vérifier le résultat, les deux implémentations reçoivent les mêmes données d’entrée et leurs sorties sont comparées. Chaque écart doit être analysé : il peut révéler une régression, une simple différence technique ou un comportement historique que l’équipe souhaite corriger. Toute différence volontaire doit être explicitement validée.
La migration avance ainsi par étapes, chaque module étant vérifié avant de passer au suivant. Cette comparaison apporte de la confiance sur les cas testés ; la qualité et la couverture des tests restent donc essentielles pour sécuriser la transition.
8. Reconstruire sur une nouvelle architecture
Quand l’utiliser Reimagine ? Lorsqu’une montée de version ou un changement de technologie ne suffit plus. Il faut alors repenser l’organisation même du système : la répartition des responsabilités, les frontières entre composants et leurs interactions.
/code-modernization:modernize-reimagine <name> [target-vision]La démarche commence par extraire une spécification à partir du code existant. Elle décrit ce que fait réellement le système et sert de base à la conception de l’architecture cible. L’équipe examine ensuite cette proposition, l’ajuste et l’approuve avant d’aller plus loin.
Une fois l’architecture validée, le plugin génère les premières structures des services ainsi que des tests d’acceptation exécutables. Ces éléments constituent le point de départ de la reconstruction et permettent de vérifier progressivement les comportements attendus.
Attention toutefois à ne pas confondre la génération de ces éléments avec l’achèvement du système. Leur présence ne prouve ni que toutes les fonctionnalités sont implémentées, ni qu’elles répondent aux besoins métier. La reconstruction doit donc s’accompagner de vérifications régulières, au fur et à mesure que les fonctionnalités prennent forme.
9. Vérifier la modernisation et examiner la sécurité
La place accordée à la vérification est l’un des aspects les plus intéressants du plugin. Une nouvelle implémentation peut très bien compiler et réussir ses tests sans pour autant reproduire tous les comportements attendus du système existant.
Ce risque est particulièrement élevé dans les applications legacy. Certaines règles métier ne sont plus documentées, et des comportements essentiels peuvent dépendre d’exceptions ou de cas limites mal connus. La vérification doit donc aller au-delà du bon fonctionnement apparent du nouveau code.
Construire des preuves indépendantes
La commande modernize-verify réalise une vérification indépendante du travail de transformation. Idéalement lancée dans une nouvelle session, elle ne se contente pas de reprendre les conclusions des agents qui ont effectué les modifications : elle établit ses propres preuves, à partir du code et des résultats d’exécution.
À l’issue de l’analyse, chaque module reçoit un verdict :
- PROUVÉ (PROVEN) : les vérifications exigées ont été réalisées et les preuves recueillies satisfont les critères définis.
- PARTIELLEMENT PROUVÉ (PARTLY PROVEN) : une partie des vérifications est concluante, mais certains éléments restent à démontrer.
- NON PROUVÉ (NOT PROVEN) : des écarts inexpliqués, des tests en échec ou l’absence de vérification effective empêchent de valider le résultat.
Ces verdicts expriment un niveau de preuve au regard des critères examinés. Ils ne garantissent pas l’ensemble des comportements possibles.
Tenir compte des limites de l’environnement
Il n’est pas toujours possible d’exécuter le système historique dans l’environnement de travail, par exemple lorsqu’il dépend d’un mainframe ou n’est accessible qu’en production. La comparaison s’appuie alors sur des sorties enregistrées au préalable.
Ces données permettent de vérifier certains comportements, mais limitent les possibilités d’exploration. Dans ce cas, le meilleur verdict atteignable reste PARTIELLEMENT PROUVÉ.
À chaque nouvelle vérification, les verdicts sont recalculés à partir des preuves disponibles : un résultat antérieur n’est jamais reconduit automatiquement. La décision de clore la modernisation repose donc sur deux éléments : des preuves suffisantes sur les comportements attendus, et une acceptation explicite des risques qui subsistent.
Compléter par une analyse de sécurité
Le plugin propose également modernize-harden, une étape complémentaire consacrée aux vulnérabilités du système existant. Elle produit des constats documentés et propose des correctifs à examiner avant toute application.
Cette étape répond à une question distincte de celle de l’équivalence fonctionnelle : un comportement peut avoir été fidèlement préservé tout en présentant une faiblesse de sécurité.
Les correctifs proposés ne sont jamais appliqués automatiquement au code source. Leur examen, leur validation et la décision de les intégrer restent sous responsabilité humaine.
10. Rehost et Replace : déplacer ou remplacer le système
Au-delà des trois voies outillées par le plugin, deux autres stratégies existent : Rehost, qui déplace le système, et Replace, qui le remplace par un produit existant.
Avec Rehost, on installe le système dans un autre environnement d’exécution sans toucher à son code. C’est un déménagement : l’application change d’hébergement, mais conserve son fonctionnement et ses caractéristiques.
Avec Replace, on substitue au système un produit du marché capable de couvrir les besoins métier. Le travail consiste alors à évaluer l’adéquation du produit, à identifier les écarts fonctionnels et à préparer la migration des données et des usages.
Le plugin ne propose pas de commande pour ces deux stratégies. Ses analyses restent néanmoins précieuses pour éclairer la décision : elles font apparaître les fonctionnalités à préserver, les dépendances à prendre en compte et les contraintes à anticiper avant un déplacement ou un remplacement.
11. Une architecture multi-agents pour répartir le travail
Le plugin repose sur plusieurs agents spécialisés, chacun intervenant sur une partie du processus. Certains explorent le code legacy ; d’autres extraient les règles métier, examinent l’architecture, analysent les vulnérabilités, construisent les tests ou prennent en charge les transformations techniques.
Parmi eux figurent notamment legacy-analyst, business-rules-extractor, architecture-critic, security-auditor, test-engineer, version-delta-analyst, uplift-migrator et scaffolder.
Cette spécialisation répartit les responsabilités et introduit des vérifications croisées. Une règle extraite par un agent peut être réexaminée par un autre ; le résultat d’une transformation peut être évalué indépendamment de sa réalisation.
Certaines étapes font travailler plusieurs agents en parallèle. L’extraction des règles métier est la plus intensive : les expérimentations décrites ont mobilisé entre 50 et 200 agents pour certaines exécutions.
Cette parallélisation est un atout pour les grandes bases de code, mais elle exige de maîtriser le périmètre analysé et les ressources consommées. Le plugin recommande donc d’avancer progressivement, par module ou par unité fonctionnelle, surtout lorsque le patrimoine atteint plusieurs millions de lignes.
Enfin, les opérations longues peuvent reprendre après une interruption, grâce à des journaux d’exécution qui conservent l’avancement des travaux.
12. Des artefacts pour conserver et partager la connaissance
L’un des choix structurants du plugin est de conserver l’état du projet dans des fichiers plutôt que dans la conversation avec l’agent. On peut ainsi reprendre une modernisation dans une nouvelle session, faire intervenir plusieurs personnes et garder une trace des analyses comme des décisions.
| Artefact | Rôle |
| INTENT.md | Formaliser l’intention et les objectifs |
| PREFLIGHT.md | Définir le périmètre et les conditions initiales |
| ASSESSMENT.md | Présenter l’évaluation du système |
| TOPOLOGY.html | Visualiser l’architecture et les dépendances |
| BUSINESS_RULES.md | Documenter les règles métier extraites |
| MODERNIZATION_BRIEF.md | Décrire le plan de transformation approuvé |
| VERIFICATION.md | Conserver les preuves et les verdicts |
| SECURITY_FINDINGS.md | Documenter les vulnérabilités identifiées |
| REPORT.html | Présenter une synthèse des résultats |
Chaque artefact peut être relu par les personnes compétentes : responsables de la compilation, ingénieurs logiciels, experts métier, architectes, pilotes de la transformation ou spécialistes de la sécurité.
La documentation n’est donc plus un simple sous-produit de l’analyse : elle devient un support de collaboration et de décision. Le plugin propose d’ailleurs un panneau de suivi interactif, encore en accès anticipé, qui affiche la progression des travaux, la topologie du système, les verdicts de vérification et les prochaines actions.
13. Le contrôle humain au cœur du processus
Bien qu’il mobilise de nombreux agents, le plugin ne cherche pas à se passer des décisions humaines. Six moments exigent une intervention explicite :
- la définition des conditions initiales ;
- la revue des règles métier incertaines ;
- l’approbation du plan ;
- l’acceptation des différences de comportement ;
- la validation finale des preuves ;
- l’application des correctifs de sécurité.
Cette organisation traduit une séparation claire des responsabilités. Les agents analysent, proposent, génèrent et vérifient, mais ils n’ont pas l’autorité de décider seuls de ce qui doit être conservé, modifié ou abandonné.
La revue des règles métier en est l’illustration la plus parlante. Une règle extraite du code décrit avant tout un comportement observé dans l’implémentation ; elle n’est pas nécessairement une règle métier légitime. Le rôle des experts métier est justement de confronter cette connaissance technique à la réalité du domaine : confirmer les invariants, identifier les exceptions, clarifier les comportements attendus.
De même, l’approbation du plan permet de s’assurer que la transformation proposée correspond aux objectifs du projet, à ses contraintes et aux risques jugés acceptables.
L’humain n’intervient donc pas seulement pour autoriser une action. Il apporte le discernement métier et architectural qu’une analyse automatisée ne peut garantir à elle seule.
14. Conclusion : comprendre, choisir, vérifier
Moderniser un système legacy, c’est d’abord retrouver la connaissance qu’il renferme, identifier ce qui doit être préservé et déterminer ce qui doit évoluer. La rétrodocumentation constitue ainsi un premier livrable utile : elle rend explicites le fonctionnement du système et ses règles métier, même lorsqu’aucune transformation n’est engagée dans l’immédiat.
Le plugin Modernization structure cette démarche, de l’exploration de l’existant à la vérification des transformations, et sonne ainsi le glas des modernisations manuelles.
Ses trois voies, Uplift, Transform et Reimagine permettent d’adapter les travaux aux besoins métier, aux contraintes du système et à l’ampleur du changement recherché.
À l’instar de la méthode BMAD, il repose sur une orchestration multi-agent qui répartit les tâches entre des agents spécialisés. Ce cadre coordonne leurs interventions et sollicite l’utilisateur aux étapes clés, afin d’éclairer les décisions et de valider la poursuite des travaux.
Les preuves et les validations humaines occupent une place centrale dans cette approche. Les agents analysent, proposent et produisent ; les équipes valident les règles métier, approuvent les choix et acceptent les risques résiduels. La qualité d’une modernisation se mesure donc autant à la capacité de démontrer les comportements attendus qu’au code livré.
Reste à confronter cette proposition open source à la pratique. Les prochains volets suivront sa mise en œuvre, étape par étape, sur plusieurs scénarios concrets. Ils permettront d’examiner les livrables obtenus, les difficultés rencontrées et les apports de cet outil à nos démarches de modernisation.