Mes agents lisaient trop : ce que dix semaines de chasse aux tokens m'ont appris
En bref — Je suis coach produit. Je ne code pas. Depuis l'été 2026, des agents IA travaillent pour moi sur une flotte de projets, depuis un dépôt central que j'appelle le hub. Chaque fois qu'un agent lit un fichier, il paie en tokens, l'unité de mesure du texte qu'un modèle lit et écrit. Au début, je ne savais pas combien ils lisaient. Le 30 juillet, une première mesure a compté 74 millions de tokens facturables. Personne ne la regardait. Cet article raconte ce que j'ai fait ensuite : des règles de lecture écrites noir sur blanc, des fichiers qu'on n'ouvre plus en entier, des consignes plus courtes, des briefs bornés, des outils retirés parce qu'ils ne servaient à rien. Certaines économies sont mesurées. D'autres ne le sont pas, et je le dis. Ce qui a le plus résisté n'est pas technique : c'est la tentation de croire qu'une règle écrite est une règle appliquée. Je finis par cinq gestes que n'importe quelle équipe produit peut reprendre dès demain, sans écrire une ligne de code.
Les apprentissages, version ticket de caisse : le détail suit, chiffres à l'appui
L'essentiel tient sur un ticket : sept optimisations, cinq apprentissages. Le détail de chaque ligne suit, chiffres à l'appui.
Les sept optimisations, en une ligne chacune :
- D'abord mesurer : 74 241 819 tokens facturables, et personne ne regardait.
- Une discipline de lecture écrite : un journal lu en entier, environ 109 000 tokens.
- Un fichier de règles court : une règle noyée est ignorée, d'où 169 lignes ramenées à 150.
- Retirer ce qui ne sert jamais : 34 skills jamais invoquées, dont 21 « shims », retirées.
- La divulgation progressive : l'orchestrateur passe de 1 130 à 334 lignes, détail à la demande.
- Des briefs bornés : une condition d'arrêt et un budget de sortie pour chaque brief.
- Vider la mémoire au bon moment : compacter dès 40 %,
/clearaprès deux échecs.
Et les cinq apprentissages qui en sortent :
Ce qui ne se mesure pas ne s'optimise pas. Avant le 30 juillet, je pilotais à l'aveugle.
Le moins cher, c'est ce qu'on n'envoie pas au modèle. Un script à 0 token passe avant un agent. Une recherche ciblée passe avant une lecture complète.
Retirer rapporte plus qu'ajouter. Le gain par tour que je cite, environ 2 180 tokens (chiffre du commit, non rejoué), vient d'une suppression.
Le cache est une remise, pas une gratuité. La relecture depuis le cache représente 96 % des tokens d'un mois (estimation non mesurée). Chaque ligne inutile dans mes règles est relue à chaque tour.
Un chiffre sans source n'a pas sa place dans mes règles. C'est valable pour cet article aussi : un gain rejoué avec des hypothèses est écrit « estimation indicative », un chiffre relevé mais non rejoué « estimation non mesurée ».
Le problème : un agent paie tout ce qu'il relit
Un modèle de langage lit des tokens, des morceaux de mots, et chaque token lu ou écrit est facturé. Le contexte, c'est tout ce que l'agent a sous les yeux : mes consignes, les fichiers ouverts, l'historique de la conversation. Il est renvoyé au modèle à chaque tour. Mon hub le dit en une phrase : « Le contexte est un cache actif facturé à chaque tour, pas une mémoire gratuite. »
Le cache, c'est une copie que le fournisseur garde quelques minutes pour ne pas tout retraiter. Relire depuis le cache coûte moins cher, mais cela coûte, et le volume explose vite. Mon hub y est très exposé : il lit six dépôts, porte des dizaines de skills (des modes d'emploi que l'agent charge pour une tâche) et génère des pages de plusieurs centaines de kilo-octets.
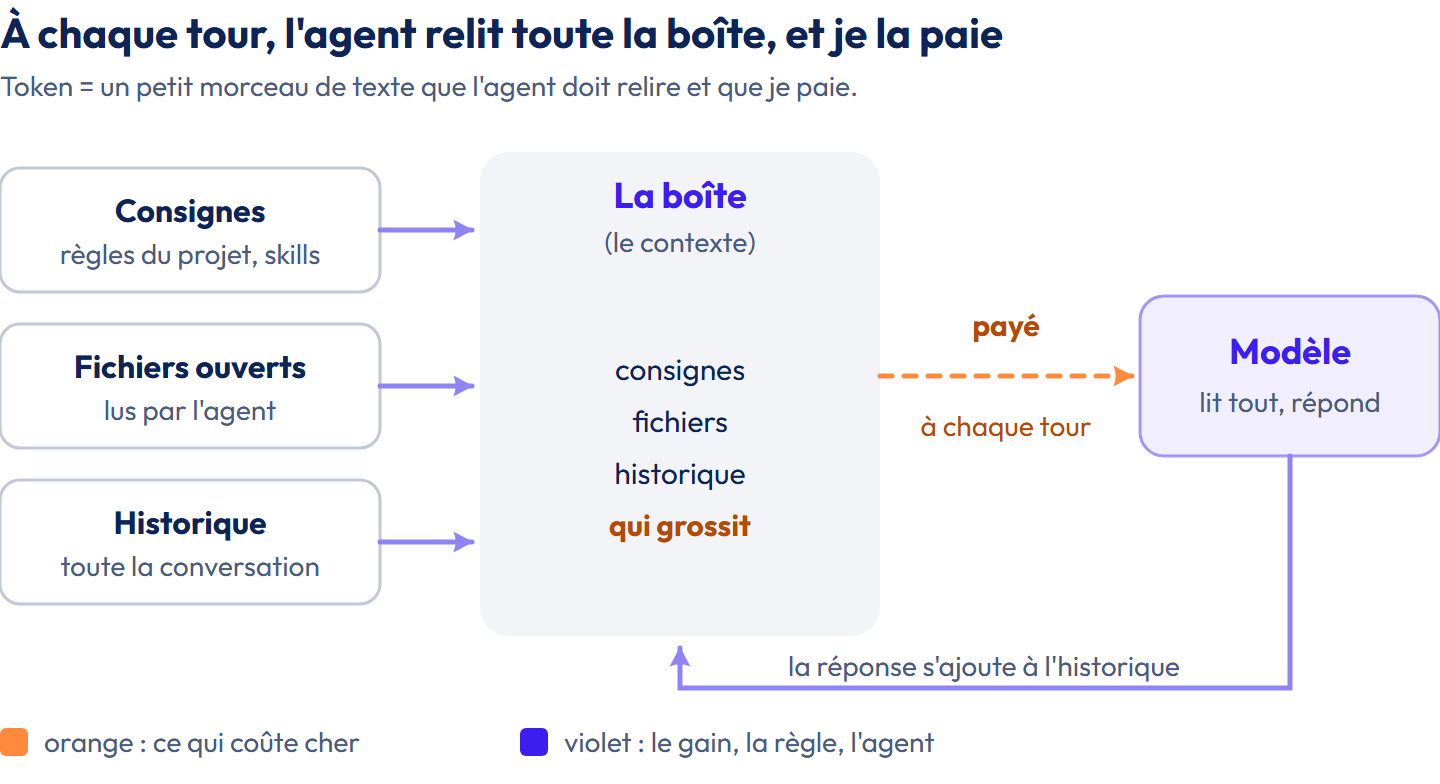
À chaque tour, tout le contexte repart vers le modèle, et tout est facturé.
Optimisation 1 : d'abord mesurer
Le 30 juillet, une étude sur la consommation a buté sur un mur : le journal d'usage comptait 159 invocations, mais aucune donnée en tokens. Les compteurs existaient pourtant, dans les traces de chaque conversation. Un script les a lus : 15 secondes pour 119 traces et 10 299 messages, soit 74 241 819 tokens facturables.
Ce qui a résisté : le script a dormi. Le bilan n'existait que si quelqu'un pensait à le lancer. Une table ronde de mes agents l'a constaté le lendemain ; la réponse a été un onglet « Tokens » dans mon site de supervision, qui rend visible ce que personne ne regardait.
D'où ça vient. Pratique d'ingénierie, sans article racine identifié.
Ce que j'ai constaté ici. 74 241 819 tokens facturables (git show -s d9ed3067). Un fait m'avait échappé : mon fichier de mesure ne lisait que la session principale, pas les 2 410 sous-agents lancés depuis le 8 septembre. En les comptant, un mois de 30 jours représente environ 17,3 milliards de tokens relus depuis le cache, 597 millions écrits dans le cache et 65 millions produits par mes agents.
Pourquoi ce chiffre compte. À chaque tour, l'agent renvoie tout son contexte au modèle. Ce qu'il relit depuis le cache représente 96 % des tokens d'un mois. Un token relu ne coûte que 10 % du prix d'un token neuf, mais ils sont si nombreux qu'ils pèsent encore 62 % de la facture, en équivalent plein tarif. C'est donc là que se jouent les économies : une ligne inutile chargée d'office est relue à chaque tour, des dizaines de milliers de fois par mois.
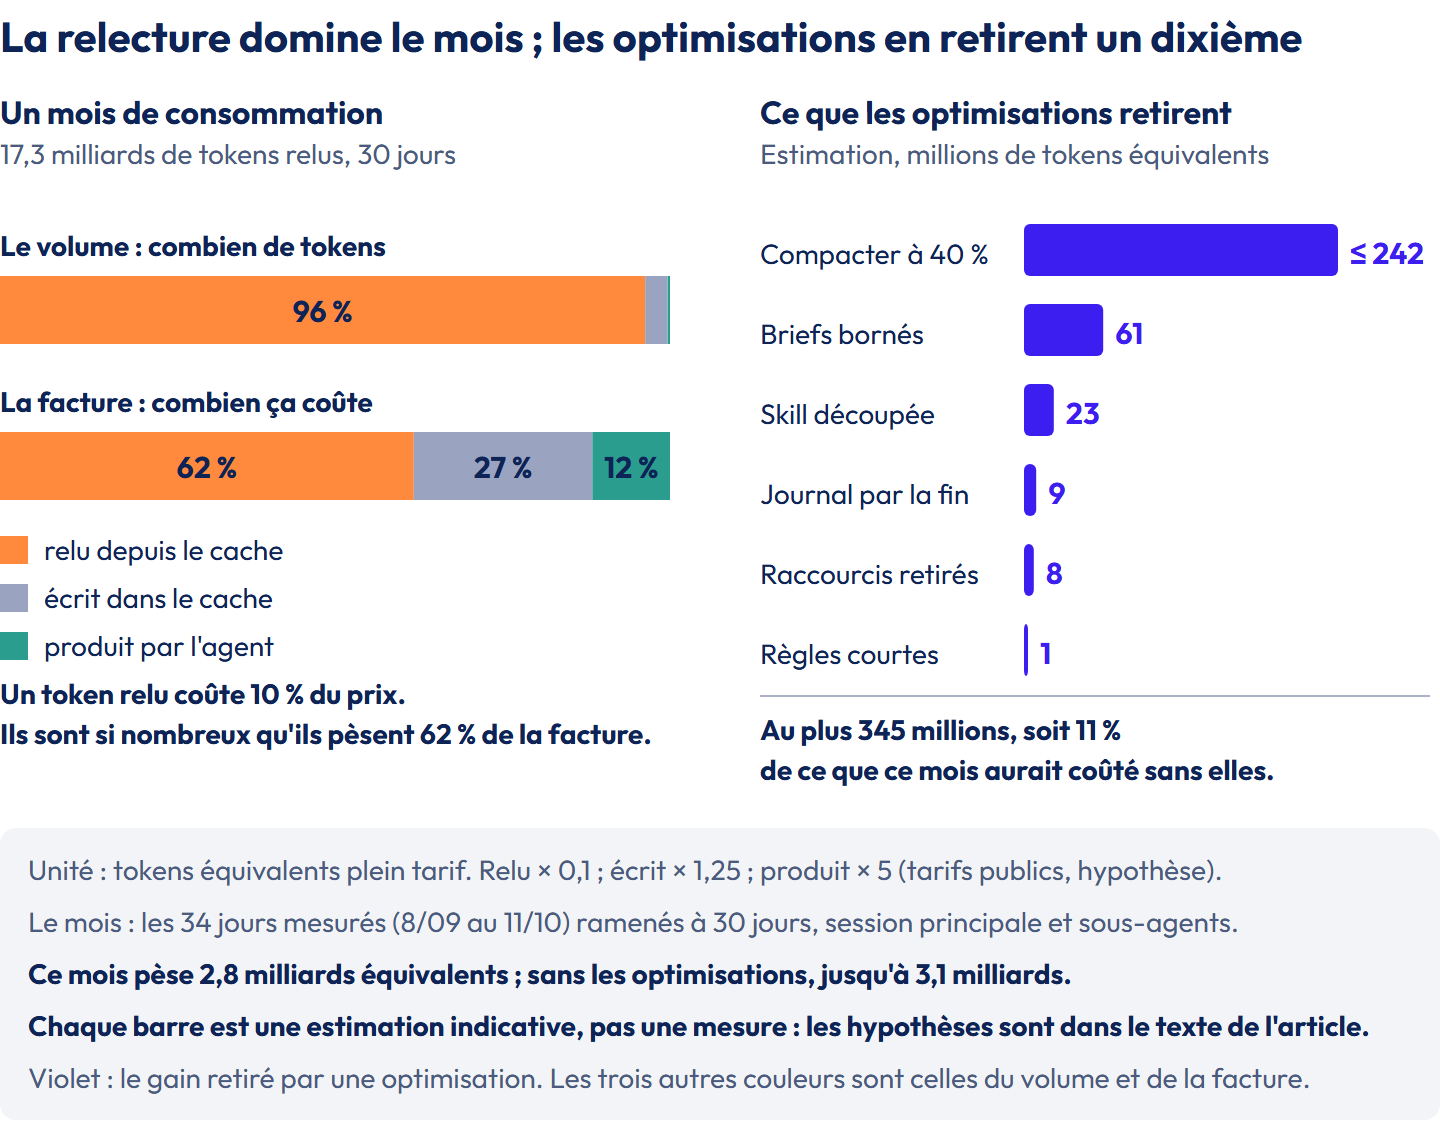
À gauche, la relecture domine le volume et pèse encore plus de la moitié de la facture. À droite, ce que mes optimisations en retirent, en estimation.
Ce que les optimisations auraient donné sur ce mois. Je n'ai pas mesuré ces gains un par un : j'ai rejoué le mois en attribuant à chaque geste un gain par tour, par appel ou par lecture (hypothèses détaillées plus bas). C'est une estimation indicative.
Au plus 345 millions de tokens équivalents, sur un mois qui en pèse 2,8 milliards : sans les optimisations, il aurait coûté environ 11 % de plus. Presque tout vient de la compaction, le geste que j'ai le moins éprouvé ; sans elle, le total tombe à 102 millions, soit 3 %.
Et dans le temps ? Les traces commencent le 8 septembre : l'avant des optimisations 1, 2, 3 et 7 n'y figure donc pas. Voici ce qu'elles montrent, semaine par semaine.
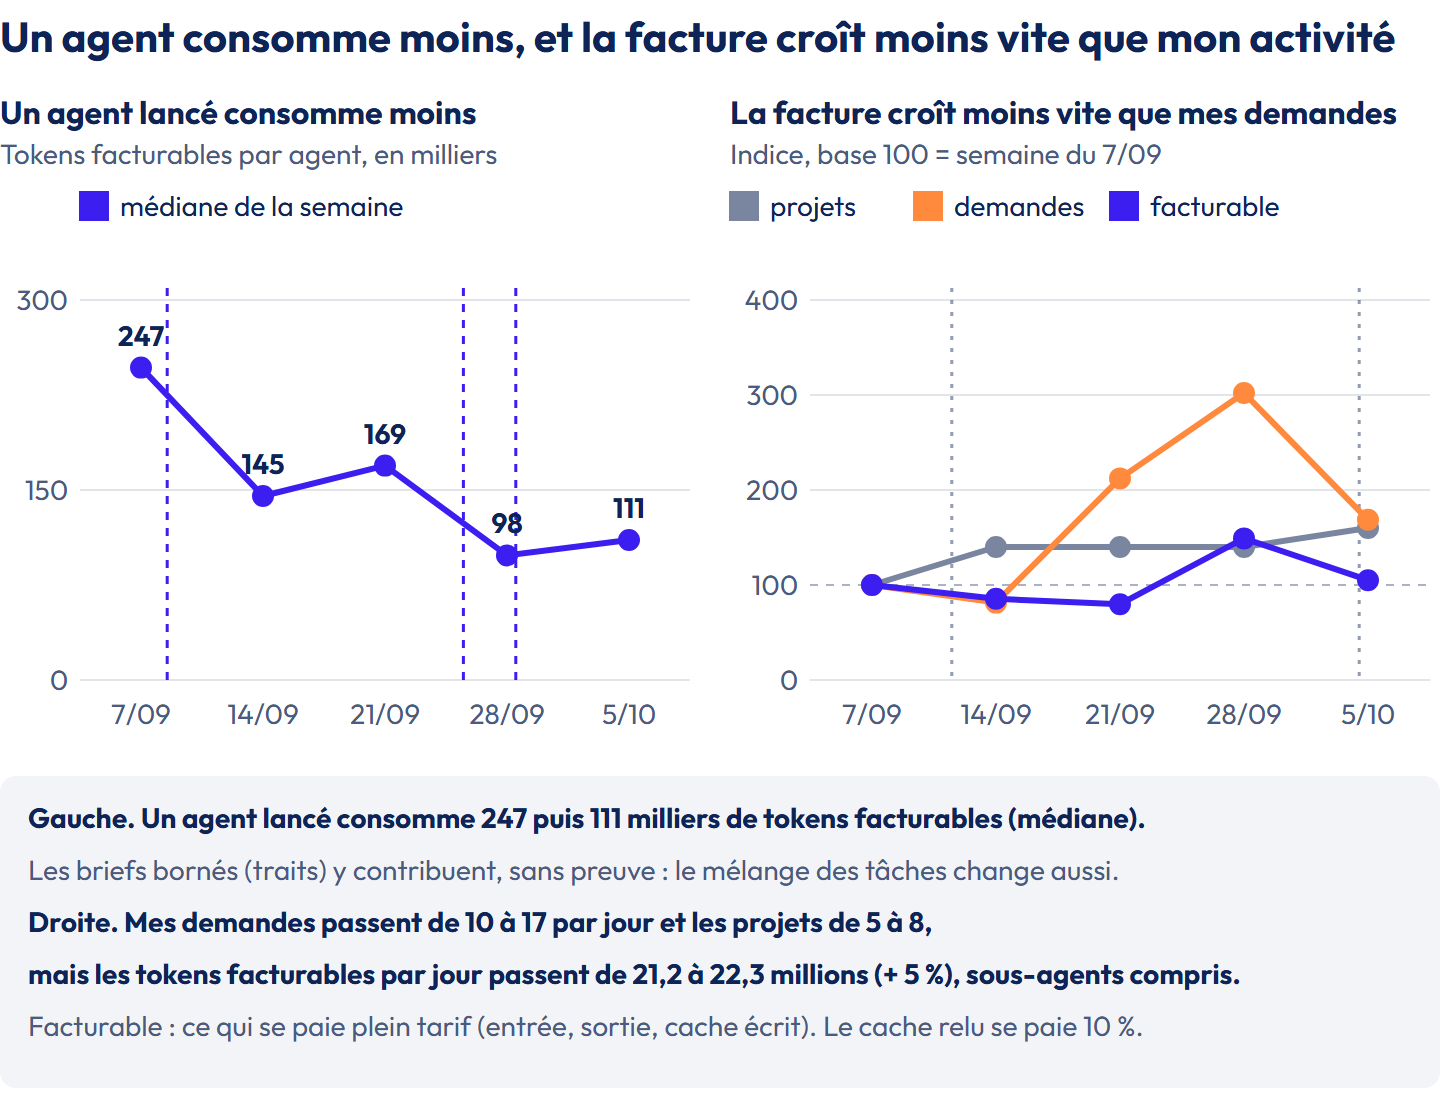
À gauche, ce que consomme un agent lancé. À droite, ce que je demande et ce que je paie.
À gauche, la mesure la plus nette : un agent lancé consomme 247 000 tokens facturables (médiane) la semaine du 7 septembre, 111 000 celle du 5 octobre, soit 55 % de moins. La baisse démarre juste après le 12 septembre, quand j'ai borné les briefs. Je ne peux pas l'affirmer, car la nature des tâches change aussi. Pendant ce temps, les agents lancés par semaine passent de 232 à 486, avec un pic à 1 031 (lots et tests de charge).
À droite, j'ai rapporté la facture à ce que je demande. Mes demandes passent de 10 à 17 par jour, et le hub suit 8 projets au lieu de 5 (deux nés le 15 septembre, un le 8 octobre). Les tokens facturables par jour passent de 21,2 à 22,3 millions : + 5 % pour + 69 % de demandes. Une « demande » est un texte que j'ai saisi moi-même ; le filtre écarte les rappels et les notifications, sans être parfait.
Ce que cela établit : la facture a moins augmenté que mon activité. Ce que cela n'établit pas : que mes optimisations en sont la cause. La baisse par demande tombe entre les semaines du 14 et du 21 septembre, avant les optimisations du 29 septembre et du 2 octobre, et la semaine de départ contient des journées de construction très lourdes. J'y vois un indice favorable, pas une preuve.
Optimisation 2 : une discipline de lecture écrite
Le même 30 juillet, j'ai fait écrire une section « Discipline de gestion des tokens » dans le fichier de règles de mon hub. Ce fichier, le CLAUDE.md, est lu par chaque agent au démarrage. La pratique existait déjà sur les autres projets. Le hub était le seul à ne pas l'avoir.
Les règles sont simples :
- Le bon étage d'abord. Mon scan automatique coûte 0 token : c'est un script, pas un modèle. On lit son résultat avant de lancer un agent facturé.
- Ne jamais ouvrir en entier certains fichiers. On cherche dedans avec une recherche ciblée.
- Lire le journal par la fin. Seules les dernières lignes servent.
D'où ça vient. Liu et al., 2023, « Lost in the Middle », TACL, relu par les pairs : l'information située au milieu d'un long contexte est moins bien exploitée (https://arxiv.org/abs/2307.03172, résumé lu). Et Anthropic, 2025, billet d'ingénierie (documentation officielle) : le rappel se dégrade quand le contexte grossit (https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents, ouvert).
Ce que j'ai constaté ici. Un agent qui lit le journal des exécutions en entier consomme environ 109 000 tokens. Estimation indicative du gain : environ 9 millions de tokens équivalents par mois (4 lectures partielles, chacune évitant une lecture de 100 000 tokens).
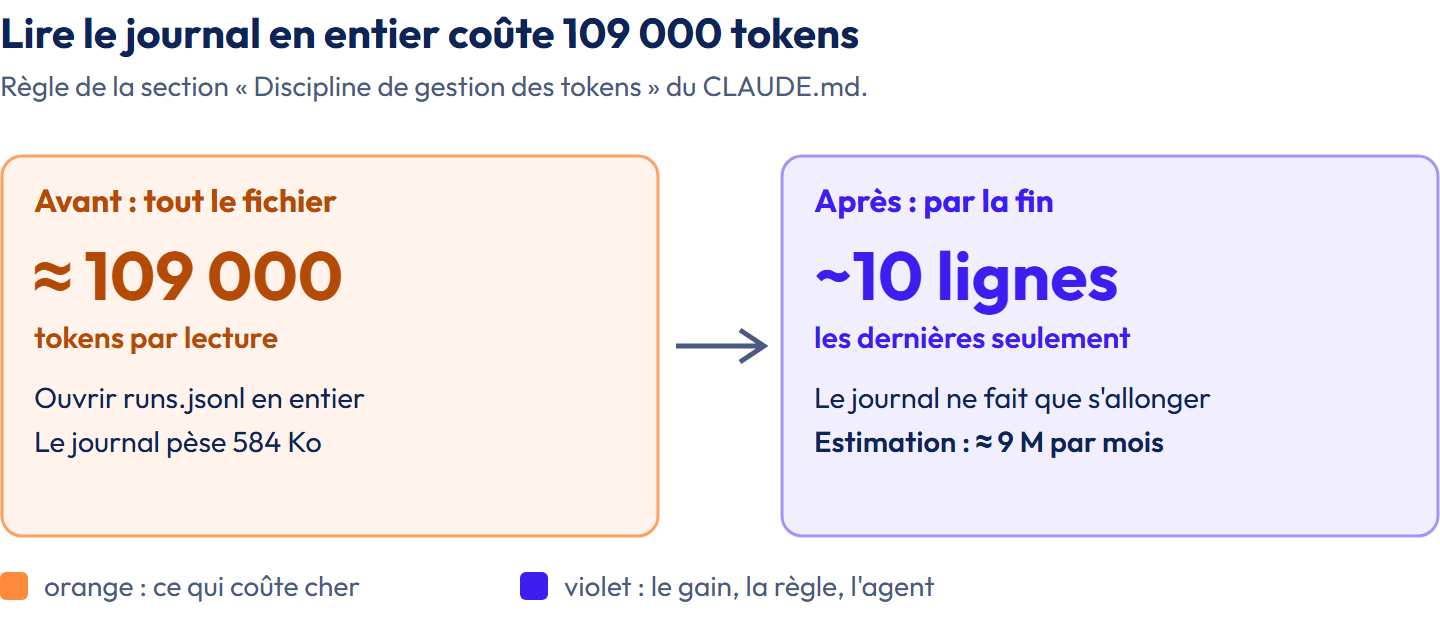
Le même journal, lu en entier ou par ses dernières lignes.
Ce qui a résisté : les tailles. Écrites à la main, elles étaient fausses de 9 à 36 % un jour plus tard. Le scan les recalcule depuis à chaque passage : la page du site pèse 1 141 Ko, le journal 584 Ko contre 94 Ko le 30 juillet.
Optimisation 3 : un fichier de règles court
Une règle noyée dans un long texte est ignorée. J'ai donc fixé un plafond de 150 lignes au CLAUDE.md.
Le 3 septembre, il en faisait 169. Un agent de relecture a proposé six coupes. Je les ai validées avant application. Le fichier est revenu à 150 lignes. Aucune règle ni aucun chiffre n'a été retiré : seulement la prose autour.
Gain en tokens : estimation indicative, environ 1 million de tokens équivalents par mois (395 tokens de moins relus à chaque tour, 34 531 tours par mois). Ce fichier est relu à chaque tour.
D'où ça vient. Même racine que l'optimisation 2 (Liu et al., 2023), par inférence de ma part, non mesurée sur mon fichier.
Ce que j'ai constaté ici. 169 lignes ramenées à 150 (git show -s 37e55dec).
Optimisation 4 : retirer ce qui ne sert jamais
Le 7 septembre, un outil de diagnostic a listé les skills jamais invoquées. Il y en avait 34, dont 33 issues de BMAD, une bibliothèque de méthodes installée sur la flotte. Parmi elles, 21 étaient des « shims », des doublons gardés par prudence lors d'une mise à jour.
Le 8 septembre, je les ai fait retirer. Le message de commit chiffre le coût évité à environ 2 180 tokens par tour. Chaque tour de chaque session payait cette liste.
D'où ça vient. Documentation officielle de Claude Code : une skill chargée reste dans le contexte, « chaque ligne est un coût récurrent » (https://code.claude.com/docs/en/skills, ouvert). Pas d'article racine.
Ce que j'ai constaté ici. Environ 2 180 tokens par tour évités, chiffre du commit 8eb876d3, non rejoué. Estimation indicative sur un mois : environ 8 millions de tokens équivalents (34 531 tours).
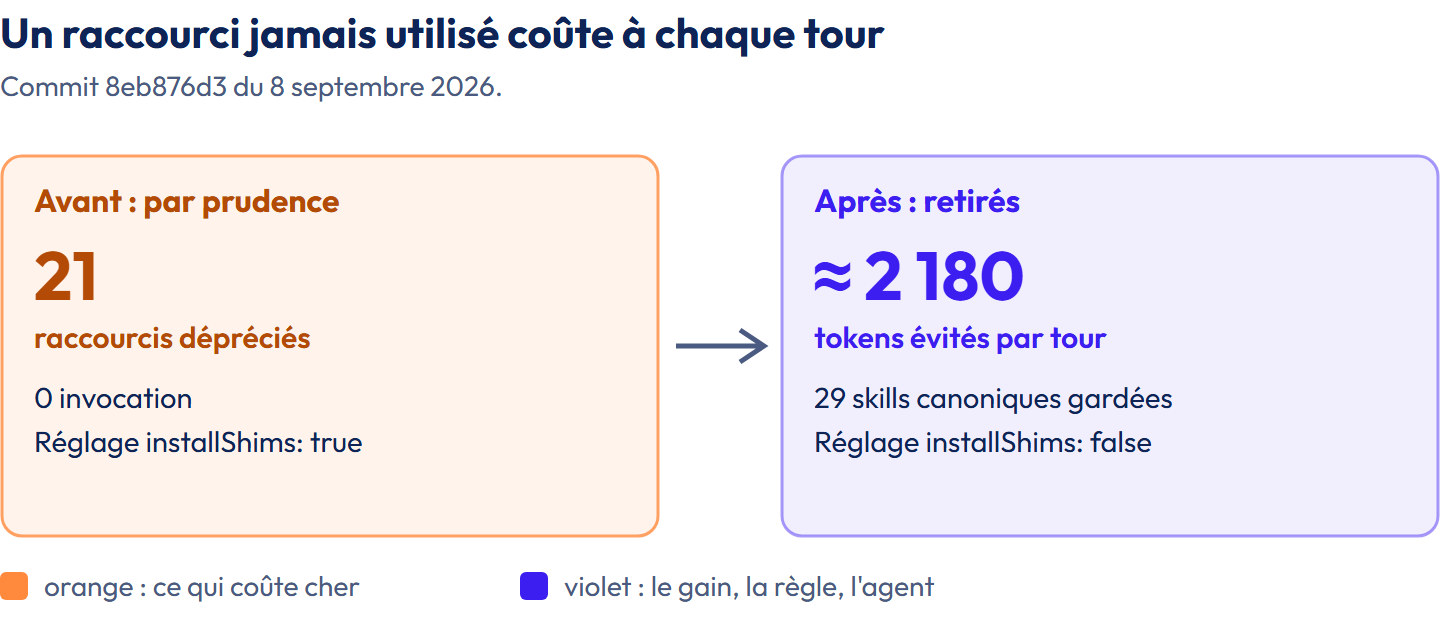
Un seul réglage suffisait à réinstaller les doublons : c'est lui qui a été coupé.
Ce qui a résisté : la peur de casser. Un doublon « au cas où » ressemble à une sécurité. Au bout de plusieurs semaines sans un seul usage, c'est un coût permanent.
Optimisation 5 : la divulgation progressive
Une skill longue est chargée en entier dès qu'elle est appelée. Mon orchestrateur, la skill qui découpe mes demandes et lance mes agents, faisait 1 130 lignes.
Le 2 octobre, je l'ai fait découper. Le cœur est resté dans le fichier principal : 334 lignes. Le détail, les mesures et l'historique sont partis dans sept fichiers de référence. L'agent ne les ouvre que s'il en a besoin. C'est ce qu'on appelle la divulgation progressive. Un test interdit désormais de repasser au-dessus de 500 lignes.
D'où ça vient. Documentation officielle de Claude Code : SKILL.md sous 500 lignes, détail dans des fichiers chargés à la demande (https://code.claude.com/docs/en/skills, ouvert). Pas d'article racine identifié.
Ce que j'ai constaté ici. 1 130 lignes avant, 334 après (git show 2612ca16~1:.claude/skills/agent-orchestrator/SKILL.md | wc -l).
Gain en tokens : estimation indicative, environ 23 millions de tokens équivalents par mois (16 000 tokens de moins à chaque appel, 53 appels par mois, relus en moyenne sur 254 tours). La baisse de taille, elle, est mesurée : environ trois fois moins de lignes chargées d'office.
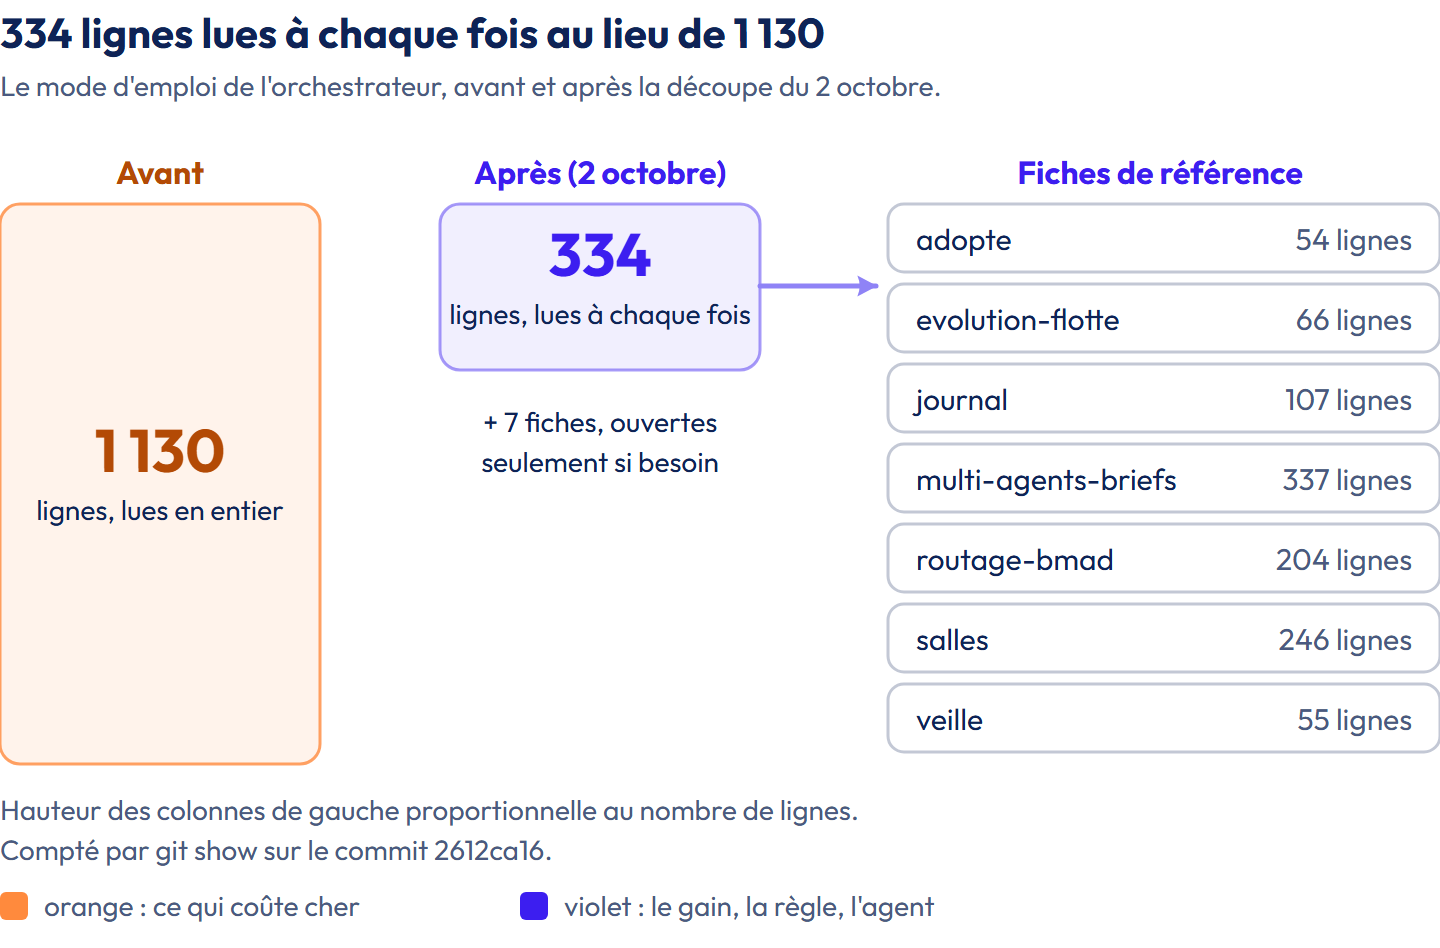
Le mode d'emploi de l'orchestrateur passe de 1 130 à 334 lignes, le reste part dans sept fiches lues à la demande.
Voici ce que ces gestes donnent dans le temps, pour l'agent et pour la skill.
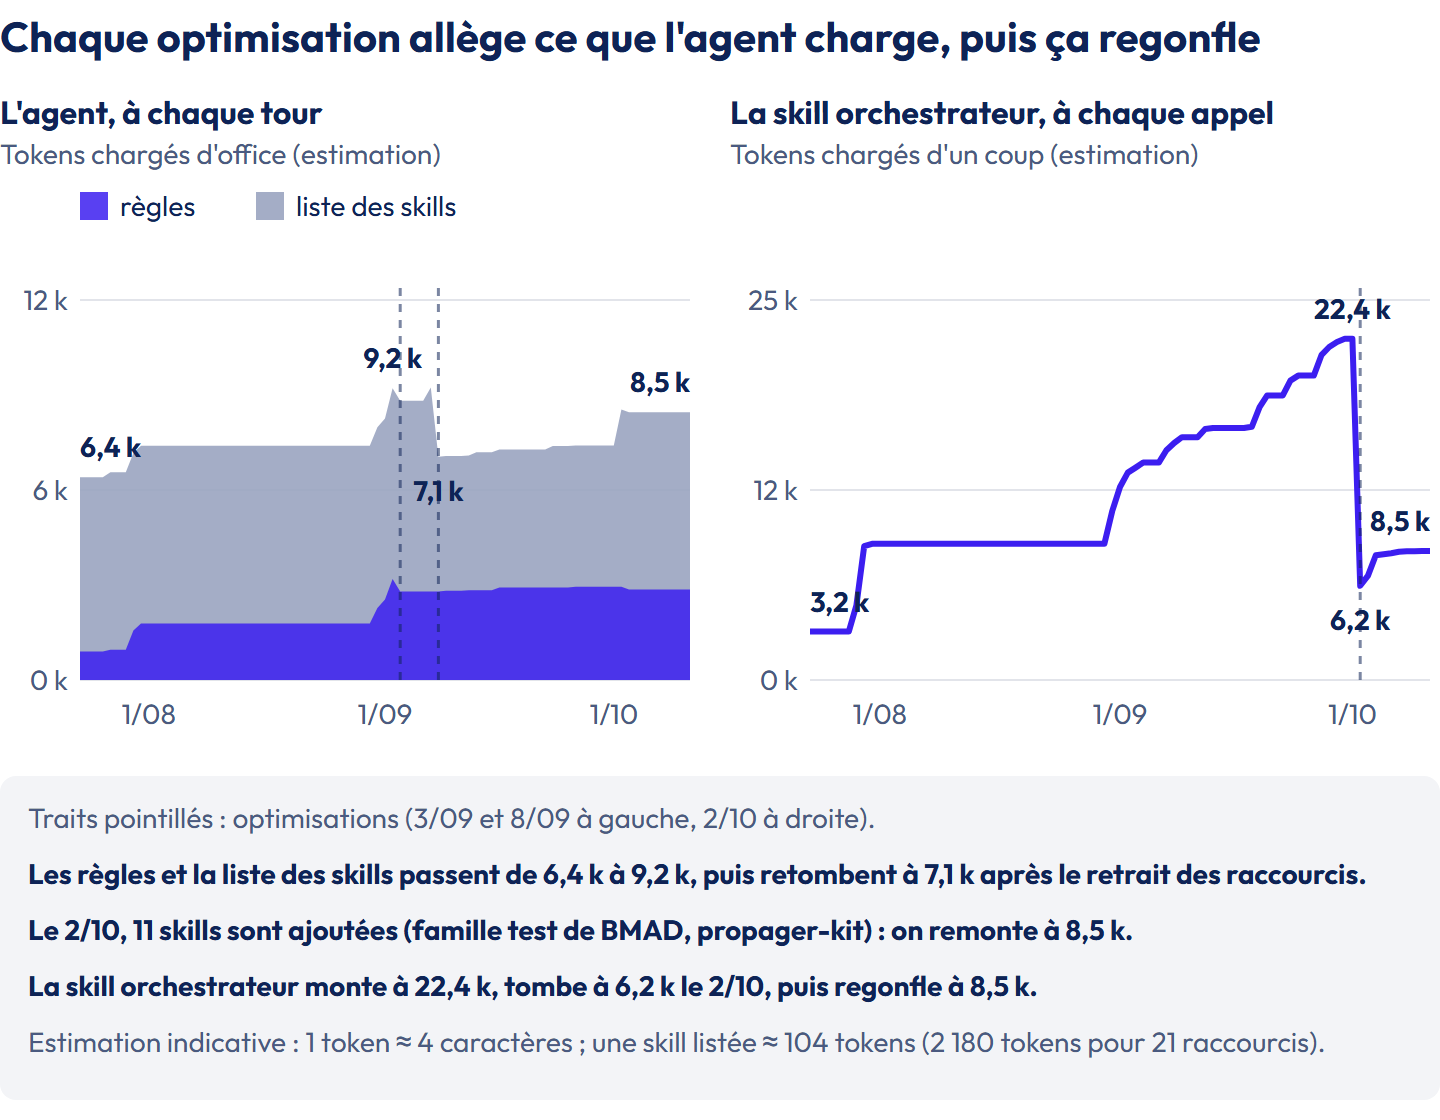
À gauche, ce que l'agent charge d'office à chaque tour. À droite, ce que la skill orchestrateur charge à chaque appel.
Les optimisations 3, 4 et 5 allègent ce chargement, puis il regonfle : 11 skills ajoutées le 2 octobre (la famille test de BMAD et propager-kit), et une skill orchestrateur remontée de 336 à 436 lignes. Ces chargements restent petits face à ce qu'un message relit, environ 8 458 tokens contre 420 000, mais ils sont relus à chaque tour.
Optimisation 6 : des briefs bornés
Un sous-agent est un agent que mon agent principal lance pour une tâche précise. Il démarre avec un contexte vierge. Il ne reçoit qu'un texte : le brief. Ce qu'il lit et produit ne remplit pas le contexte principal.
J'ai appliqué deux gestes sur ces briefs.
Le premier : déléguer à un sous-agent toute sortie volumineuse. Exploration de la flotte, inventaires, longs journaux. Seule la conclusion revient.
Le second : borner. Le 12 septembre, une veille m'a apporté un chiffre publié : un brief incomplet coûte en moyenne 29,7 % de tokens en plus. J'ai fait ajouter au brief une condition d'arrêt explicite et un budget de sortie de 1 000 à 2 000 tokens. Le 2 octobre, un garde-fou s'est mis à signaler tout brief sans taille ni budget déclarés.
D'où ça vient. Smékal, 2026, « Can your AI agent be cheaper? », préprint, non relu, sur 2 700 exécutions (https://arxiv.org/abs/2608.25399, résumé lu). Anthropic, 2025 (officielle) : résumé de 1 000 à 2 000 tokens par sous-agent.
Ce que j'ai constaté ici. Au 10 octobre 2026, 35 briefs sans gabarit ni taille sur 889 mesurés, soit 4 %.
Ce qui a résisté : le budget lui-même. Le 4 octobre, 57 % de mes agents généralistes lancés sur deux jours avaient dépassé le budget annoncé. J'ai remplacé le budget à l'estime par une table en trois classes, de 7 à 46 minutes, calée sur deux fois la médiane mesurée.
Gain en tokens : estimation indicative, environ 61 millions de tokens équivalents par mois, en supposant qu'un brief sur quatre serait resté incomplet sans la règle (hypothèse, sans mesure).
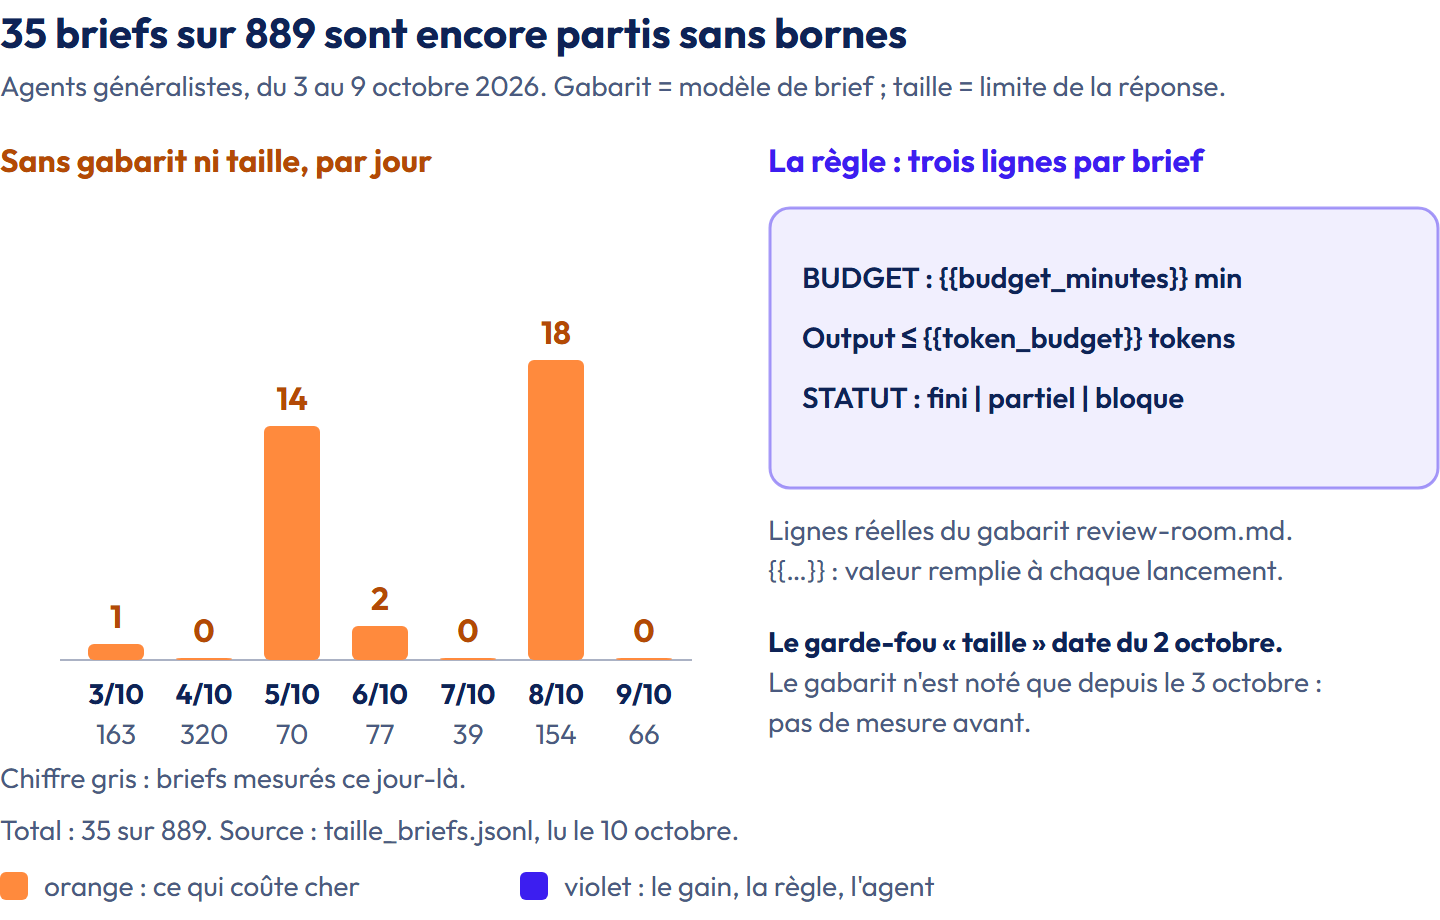
Trois lignes bornent chaque brief ; ceux qui y échappent restent rares, mais reviennent par pics les jours de grosses campagnes.
Optimisation 7 : vider la mémoire au bon moment
La compaction, c'est quand l'agent résume la conversation pour libérer de la place. La commande /compact la déclenche. La commande /clear repart d'une page blanche.
Mes règles : compacter dès 40 % de la fenêtre remplie. Et après deux corrections ratées sur le même problème, /clear plutôt qu'une troisième rustine. Ce second critère, issu d'une veille, a été adopté le 4 septembre.
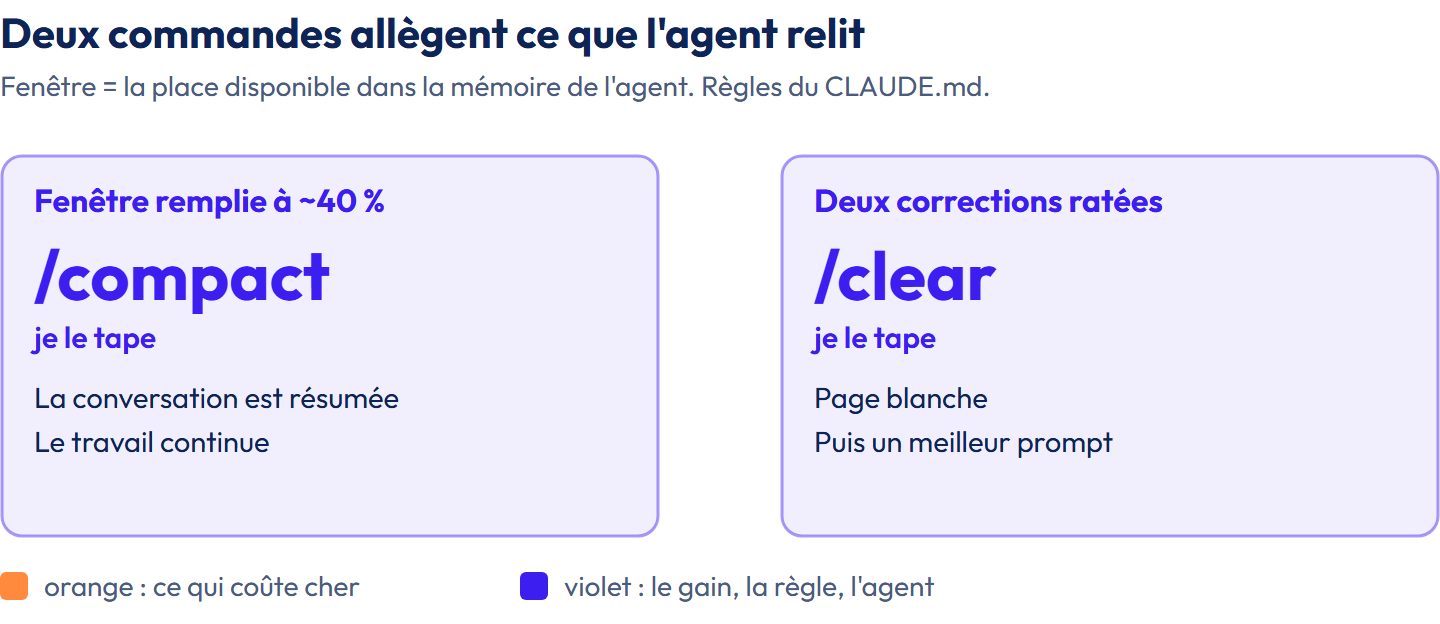
Résumer quand la place manque, repartir de zéro quand on tourne en rond.
Le cache de session expire en cinq minutes environ. J'enchaîne donc les actions d'un même chantier. Une pause relance la facture de tout le contexte.
Gain en tokens : estimation indicative, au plus 242 millions de tokens équivalents par mois, si aucun contexte n'avait dépassé 40 % d'une fenêtre supposée d'un million de tokens. C'est une discipline d'usage, pas un outil.
D'où ça vient. Anthropic, 2025, billet d'ingénierie (documentation officielle) : la compaction résume une conversation proche de la limite et repart avec ce résumé. Les seuils de 40 % et de deux échecs : pratique, sans article racine identifié.
Ce que j'ai constaté ici. Aucune mesure directe. Avec l'hypothèse d'une fenêtre d'un million de tokens, 37 % des tours de la session principale relisent plus de 400 000 tokens.
Les difficultés
Une règle écrite n'est pas une règle appliquée. Le script de mesure a dormi. Le marqueur « discipline tokens » comptait la présence d'une section, pas son effet. Mon hub le dit lui-même : la mesure automatique voit la présence, jamais le fonctionnement.
Les chiffres écrits à la main pourrissent. Les tailles fausses de 9 à 36 % en un jour en sont la preuve. Tout chiffre de mes règles est désormais régénéré par un script, ou retiré.
Plusieurs agents coûtent plusieurs fois. Le 7 octobre, une salle en comité, où plusieurs agents traitent la même question, a coûté environ 4,3 fois le témoin à un seul agent : 358 000 tokens contre 84 000. J'appelais ce mode « neuronal » ; le mot est trompeur, un réseau de neurones apprend des poids, ce que mes agents ne font pas, d'où « comité ». J'ai fixé un seuil d'abandon à deux fois.
Un vérificateur par script bat un vérificateur-agent. Lors d'un test de charge, un agent vérificateur a pris environ 6 minutes et 63 000 tokens par passage. Un script a fait le même contrôle en 11 à 39 secondes, à 0 token. L'agent a aussi produit 8 faux positifs sur 44 verdicts.
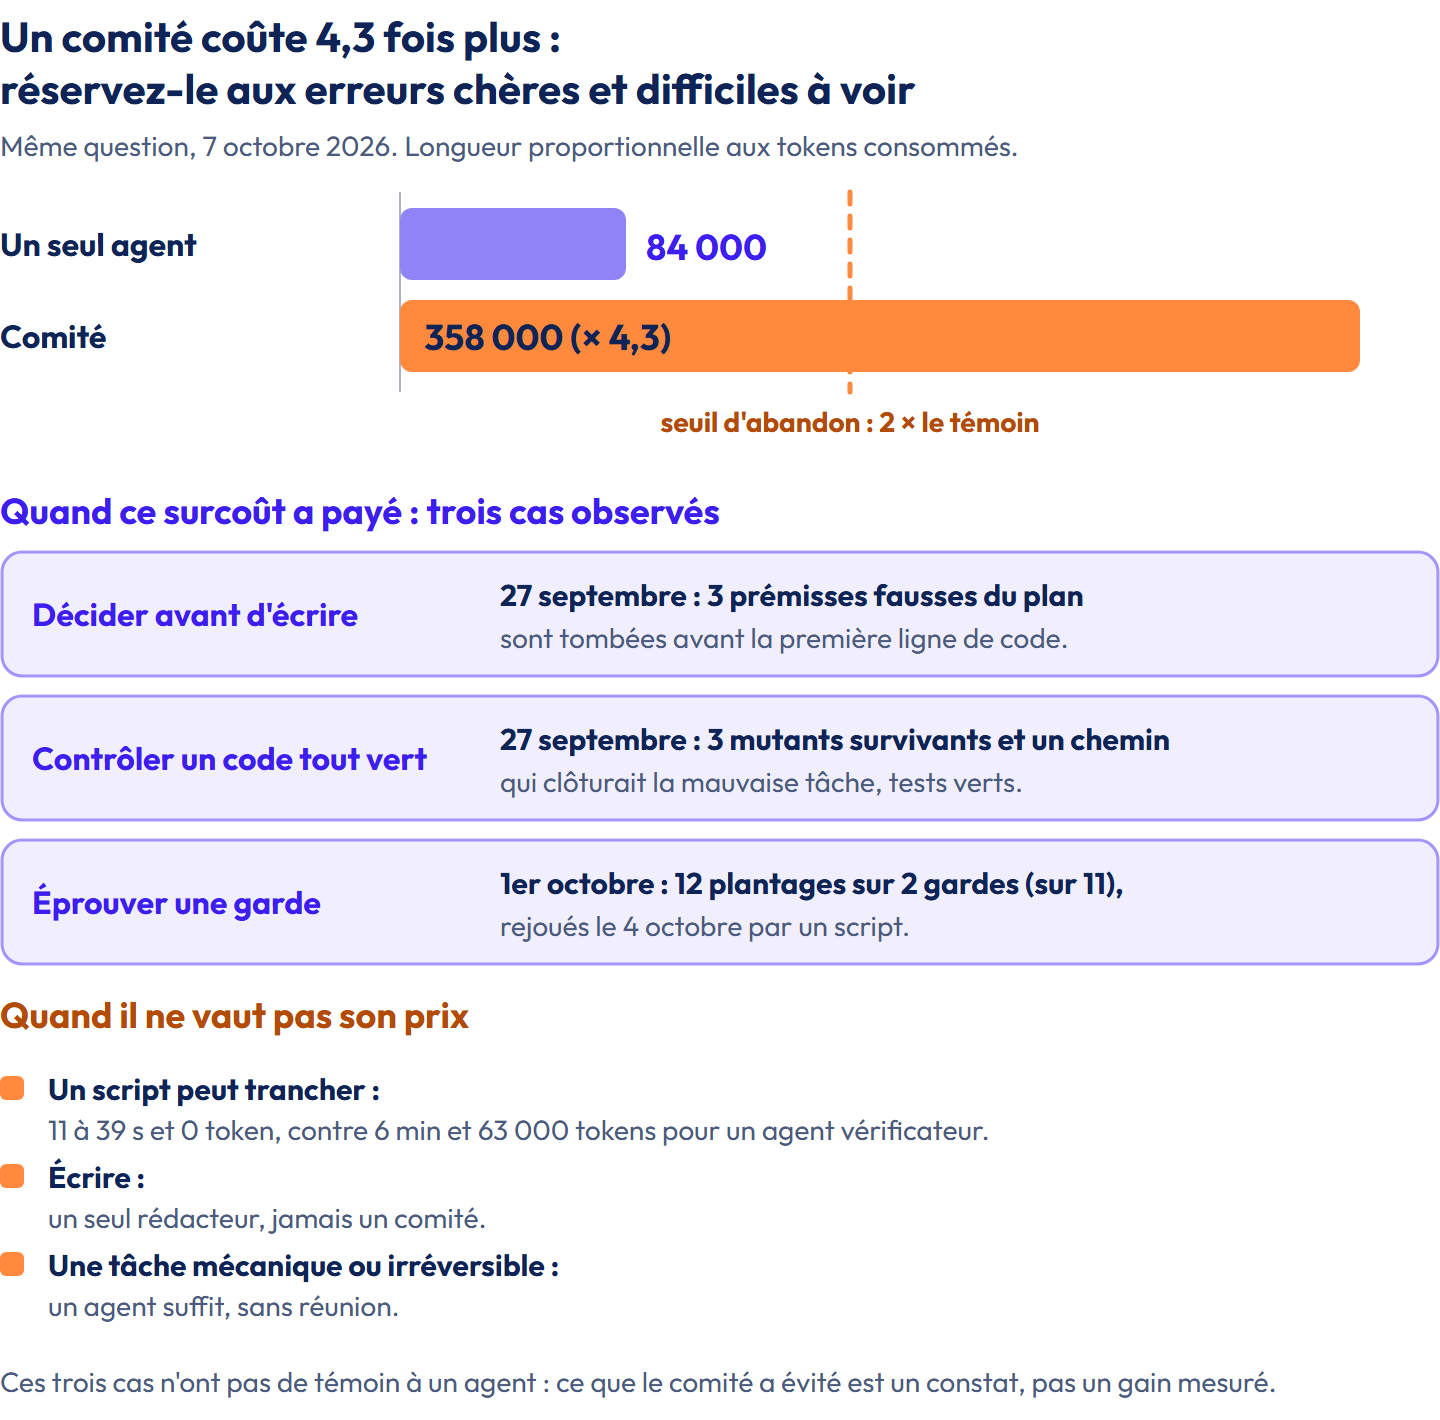
Un comité coûte 4,3 fois plus : il a payé sur trois cas observés, décrits dans l'article précédent, sans témoin à un agent pour comparer, et ne vaut pas son prix quand un script peut trancher, pour écrire, ou pour une tâche mécanique ou irréversible.
Les bonnes pratiques à adopter
Vous n'avez pas besoin de coder. Chaque geste ci-dessous se fait en une séance d'une heure environ, avec un agent et un document partagé. Chacun a un résultat que vous pouvez montrer : si vous ne l'avez pas, le geste n'est pas fait.
- Demandez la mesure. Dites à votre agent : « Donne-moi la consommation en tokens de chaque agent, par jour, sur les trente derniers jours. » Résultat attendu : un tableau de quelques lignes (agent, jour, tokens), à relire chaque semaine. Si l'outil ne sait pas le produire, c'est votre premier constat.
- Écrivez vos règles de lecture. Ouvrez un document d'une page. Listez les fichiers que l'agent n'ouvre jamais en entier (journaux, exports volumineux), et pour chacun la façon de le lire : par la fin, par une recherche ciblée. Résultat attendu : une page de dix lignes au plus, que vous collez dans les consignes de l'agent.
- Faites le ménage. Listez tous les outils, modes d'emploi et consignes que vous avez donnés à vos agents. Demandez à l'agent lesquels il n'a pas utilisé depuis un mois. Résultat attendu : une liste « à retirer », puis un retrait effectif de ceux que personne ne regrette.
- Bornez chaque délégation. Avant de confier une tâche à un agent, écrivez trois lignes : quand il s'arrête, quelle taille de réponse vous voulez, combien de temps il a. Une semaine plus tard, comptez combien d'agents ont dépassé. Résultat attendu : un pourcentage de dépassement, même approximatif.
- Remplacez chaque chiffre écrit à la main. Relisez vos consignes et repérez les chiffres (tailles, comptes, durées). Pour chacun, demandez à l'agent la commande qui le recalcule. Résultat attendu : chaque chiffre est soit recalculé automatiquement, soit supprimé.
Commencez par le geste 1 : sans mesure, vous ne saurez pas si les quatre autres ont servi.
Ma flotte relit encore beaucoup. Mais je sais combien, où, et pourquoi. C'est le début d'un pilotage.
Conclusion
Je ne suis pas riche. Mes agents, eux, avaient pris des habitudes de rentiers : relire tout le journal pour y trouver une ligne, réciter le règlement complet à chaque tour, garder vingt et un modes d'emploi qu'ils n'ouvraient jamais. 17 milliards de tokens relus en cache par mois : même avec une remise, ça finit par se voir sur le relevé.
Je ne leur ai pas coupé les vivres. Je leur ai appris à faire les courses avec une liste : lire la fin du journal, ouvrir la bonne fiche, rendre une réponse de la taille demandée. Ils lisent moins.
On dit qu'on ne s'enrichit pas avec ce qu'on gagne, mais avec ce qu'on ne dépense pas. Pour les agents, c'est pareil : le token le moins cher est celui qu'on ne lit pas. Et si un jour vous surprenez un agent en train de lire un fichier de 584 Ko pour y chercher une date, posez-lui la question qui fâche : est-ce lui qui paie l'abonnement ?
Reste une question que je n'ai pas creusée : la valeur du comité, où plusieurs agents traitent la même question. Lors de l'essai du 7 octobre, il a coûté environ 4,3 fois plus que le témoin à un seul agent. Vaut-il ce prix ? Je n'ai pas encore la réponse complète. Mon prochain article, « Un agent ou un comité ? Ce que l'usage des comités m'a appris depuis leur mise en place », raconte ce que j'ai observé, et ce que je n'ai pas pu mesurer.
Note de l'auteur
Pour écrire un article sur les économies de tokens, j'ai fait travailler mes agents, qui ont relu beaucoup de choses : par décence, je n'ai pas compté ce que cet article m'a coûté. Les chiffres, eux, sortent des scripts du dispositif et de l'historique git, chacun avec sa source ; ce qui n'a pas pu être mesuré est écrit « estimation indicative », avec ses hypothèses. Deux chiffres sur les salles viennent de mes notes de travail et n'ont pas été recomptés.