Les salles d'agents : le seul endroit où l'on est content d'être contredit
Un agent seul gagne toujours : il boxe contre son ombre. Personne ne lui rend un coup, personne ne lui dit qu'il a tort, et il sort du ring persuadé d'avoir dominé. 🥊
En bref — Le 1er octobre 2026, cinq agents IA ont débattu d'une question en apparence technique : que faire quand une de mes gardes de sécurité (un petit programme qui contrôle chaque commande d'un agent avant qu'il l'exécute) plante ? Tous cherchaient le danger au même endroit. En recoupant leurs essais, ils l'ont trouvé ailleurs, et la décision a changé. Ce jour-là, trois « salles » sur quatre n'étaient tenues que par un seul agent qui jouait tous les rôles. J'ai douze salles ; entre fin juillet et fin septembre 2026, 22 de mes 234 tâches journalisées en citent au moins une dans leur plan. Elles coûtent trois à cinq sessions d'agent chacune, et rien ne garantit qu'elles servent. Cet article raconte ce qu'elles ont attrapé, ce qui les fait dérailler et les règles que j'en ai tirées.
Pourquoi faire débattre des agents
Posez une question à un agent IA : « faut-il faire A ou B ? ». Il choisit, il argumente, il a l'air sûr de lui. Reposez-la autrement : il choisira peut-être l'autre, avec le même aplomb. Rien dans sa réponse ne signale qu'un autre point de vue aurait tout changé.
Tout facilitateur connaît ce travers chez les humains : en atelier, la voix la plus assurée n'est pas forcément la plus juste, c'est seulement celle qu'on entend. On fait donc parler les autres et apparaître le désaccord, puis on s'en sert. C'est mon métier de coach produit, et j'ai simplement appliqué cette méthode aux agents.
Une salle réunit plusieurs agents, chacun avec un rôle écrit. L'un traque les failles de sécurité, un autre les cas limites, un troisième défend la simplicité contre tout le monde. Au premier tour, chacun donne sa position sans voir celle des autres. Ensuite, ils se confrontent. La salle rend un compte rendu ; la décision reste la mienne.
Ce n'est ni gratuit ni toujours utile. Une étude relue par les pairs (Nature Machine Intelligence, 2026, 260 configurations à budget égal) montre qu'au-delà d'un certain niveau de capacité de l'agent seul, ajouter des agents n'améliore plus la performance, et peut même la dégrader. Ma règle en découle : un seul agent capable d'abord. Je ne convoque une salle que pour un vrai choix à instruire (une refonte, une adoption, la façon de découper un chantier), jamais pour une exécution nette comme « régénère la page ».
Comment une salle fonctionne
J'ai douze salles, une par type de décision. Parmi elles : le conseil de flotte (que corriger, adopter ou abandonner dans mon dispositif), l'atelier de développement qui prépare un chantier, la revue de code qui l'attaque une fois écrit, l'atelier d'idées, l'inspection critique, et mon préféré, le « club anti-consensus », convoqué précisément quand tout le monde est d'accord trop vite. Toutes tiennent dans un seul fichier de configuration, avec les rôles qui y siègent.
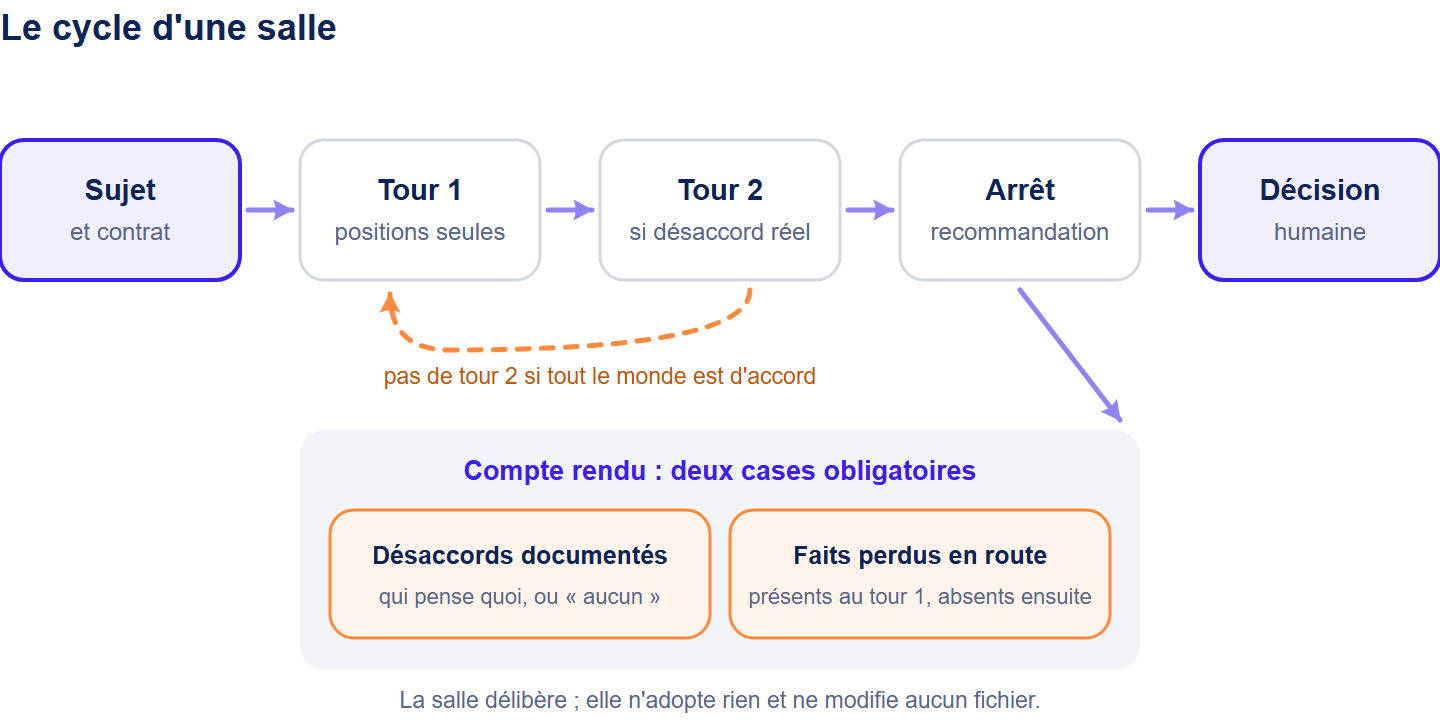
Chaque salle suit la même charpente, pour qu'on puisse les comparer et repérer celle qui dérive :
- Isolation : chaque voix tourne dans son propre contexte.
- Déroulé : qui parle à quel tour.
- Désaccord : ce qui n'est pas départagé remonte à l'humain, les deux positions intactes.
- Arrêt : la salle a fini quand une recommandation est nommée. Rendre trois options équivalentes, ce n'est pas fini.
- Interdits : une salle n'adopte rien et ne modifie aucun fichier. Elle délibère, point.
S'y ajoute un contrat, à la manière d'une demande écrite du point de vue de l'utilisateur : ce qui entre, ce qui sort, et les critères pour accepter ce livrable. Sans contrat, on obtient le compte rendu brillant dont personne ne sait quoi faire. Côté facture, chaque voix est une session d'agent à part entière, soit trois à cinq par salle : c'est le prix du vrai désaccord, à ne payer que sur un vrai choix.
Comment je m'en sers
Je ne rédige jamais le détail d'une salle. Je demande, en une phrase : « lance une salle sur tel sujet ». L'orchestrateur, l'agent qui compose le travail, choisit la salle et me propose un mode : classique (les voix confrontent leurs avis) ou comité (chaque voix doit apporter une preuve rejouable). Je peux le forcer en commençant ma demande par « comité : » ou « classique : ».
Ensuite je lis le compte rendu par la fin : d'abord les désaccords restés ouverts, puis la recommandation. Si un désaccord mérite d'être creusé, je dis « joue le tour 2 ». Sinon je tranche, et un autre agent exécute ma décision.
Un exemple du 9 octobre 2026 : je me demandais si je devais livrer mon kit d'agents aux projets sous forme de « plugin ». Quatre voix, positions séparées, une même conclusion : garder la copie de fichiers, mais mieux l'outiller. L'une a ajouté une variante que je n'avais pas vue, un fichier de version dans chaque projet. Je l'ai retenue, et l'idée du plugin attend.
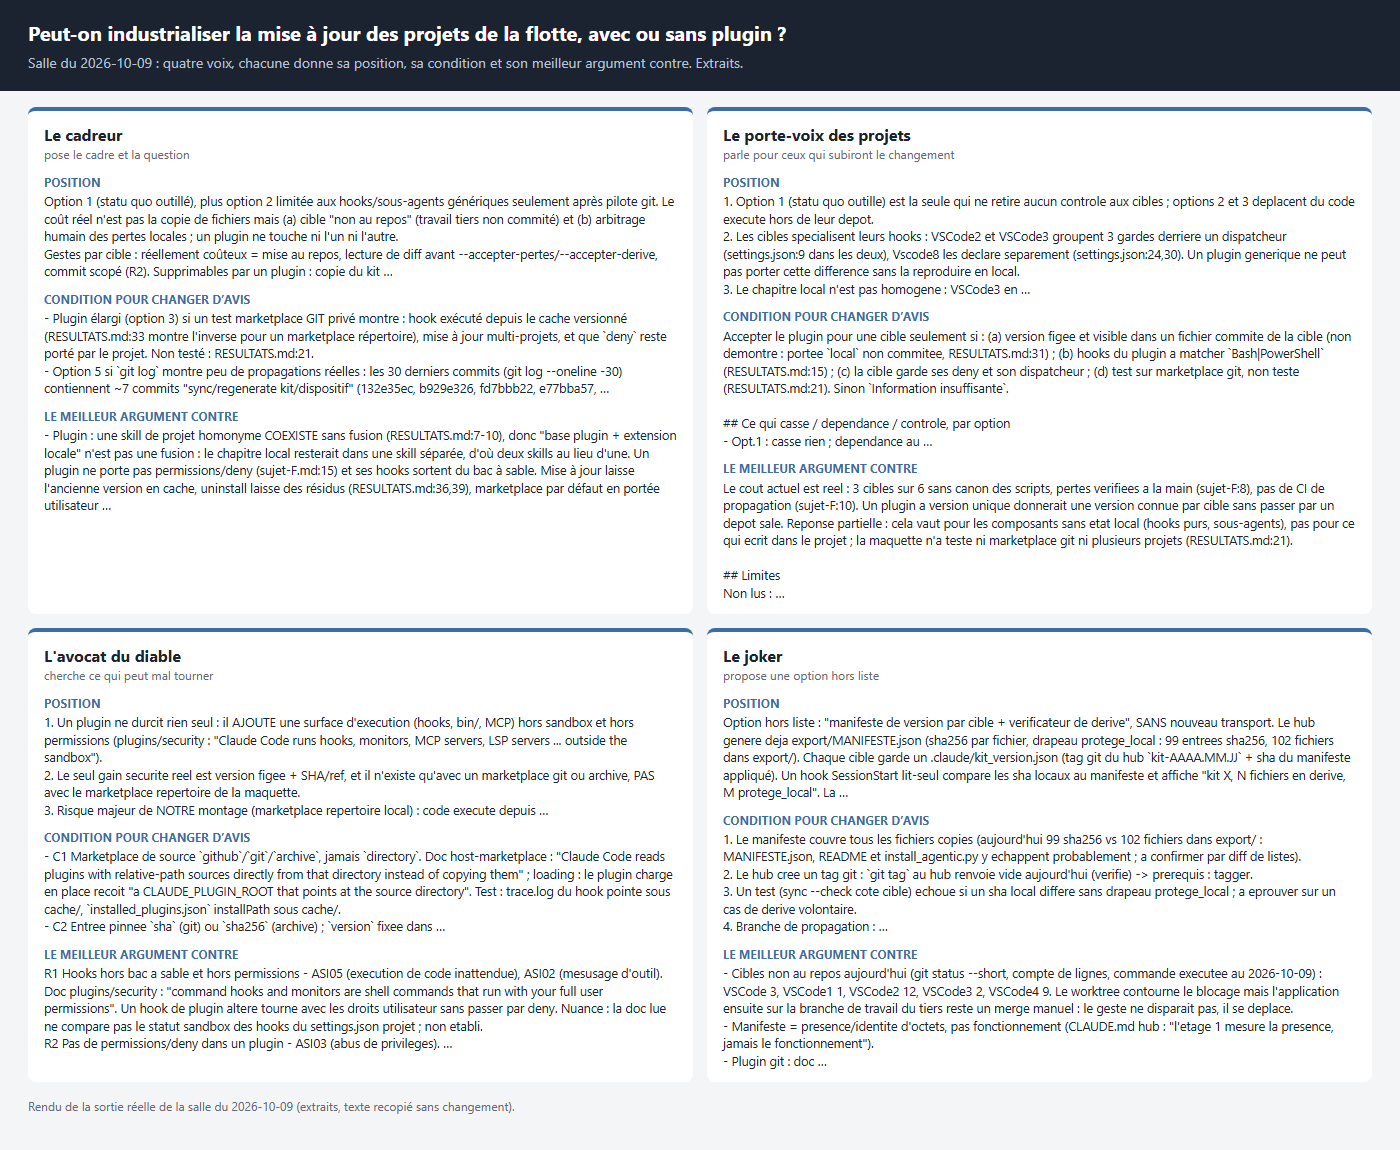
Extraits du compte rendu réel de la salle du 9 octobre 2026 : chaque voix dit ce qu'elle pense, à quelle condition elle changerait d'avis, et ce qui plaide contre elle.
Un second exemple, le 12 octobre 2026 : mes agents créent des « worktrees », des copies de travail du dépôt, et 78 s'étaient accumulées. Faut-il les nettoyer automatiquement ? Cinq voix, et aucune n'a recommandé de supprimer automatiquement : une alerte avec la commande prête, que je lance moi-même, suffit. L'une a relevé que « fusionné » ne protège rien tant que la branche principale n'est pas envoyée au serveur (elle avait 12 commits d'avance). Une autre a découvert que mon script de nettoyage ne voyait que 6 worktrees sur 78 et annulait au passage les modifications non enregistrées. J'ai retenu l'alerte et retiré cette annulation.
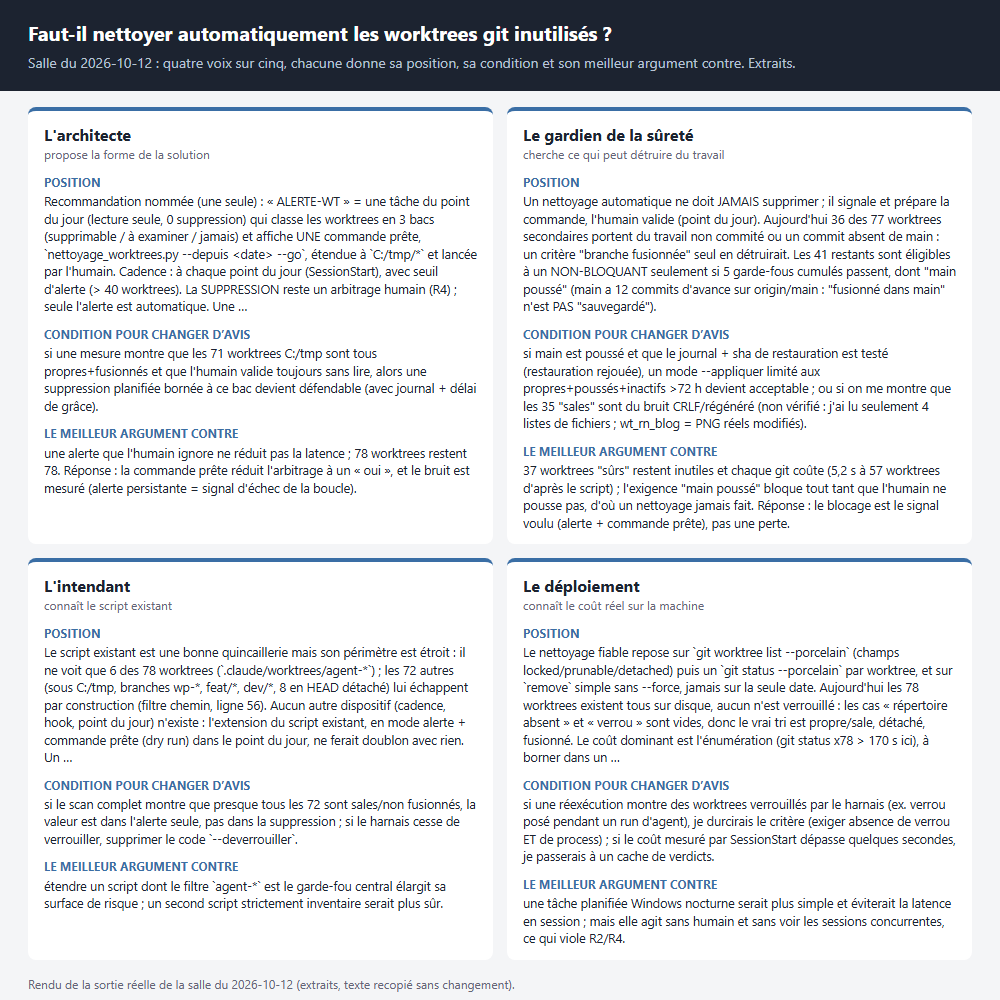
Extraits du compte rendu réel de la salle du 12 octobre 2026 (quatre voix sur cinq) : même présentation, une autre question, et la même règle : la salle conseille, je tranche.
Ce que la veille a changé dans les salles
J'ai un agent de veille : il lit la littérature scientifique sur les agents et propose des règles. Il n'adopte rien lui-même ; je tranche. Voici ce qui a façonné les salles, avec le statut de chaque travail (un préprint n'est pas relu par les pairs).
- Un seul agent capable d'abord. Kim, Gu, Park et al., Nature Machine Intelligence, 2026, relu par les pairs : au-delà d'un certain niveau de l'agent seul, ajouter des agents n'aide plus (https://www.nature.com/articles/s42256-026-01268-y). Tran et Kiela, 2026, préprint, vont dans le même sens à budget de tokens égal (https://arxiv.org/abs/2604.02460) ; ils m'ont fait mesurer le coût de mes salles.
- Rendre le désaccord visible. The Deliberative Illusion, Wan et al., juin 2026, préprint (https://arxiv.org/abs/2606.03032) : les positions s'homogénéisent et les faits du premier tour se perdent en route. D'où deux cases dans le compte rendu : « désaccords documentés » (qui défendait quoi, ou « aucun, et pourquoi ») et « faits du premier tour absents de la synthèse ».
- Ne confronter que s'il y a désaccord. Sequential Consensus, 2026, préprint d'un seul auteur (https://arxiv.org/abs/2605.19193) : arrêter le débat dès que les voix convergent divise les appels de modèle par près de 4 sur des problèmes de mathématiques, pour deux points de précision en moins. Il confirmait ma règle : le tour 2 n'a lieu que s'il reste un désaccord réel.
- Laisser une voix se taire. S²-MAD, NAACL 2025, relu par les pairs (https://arxiv.org/abs/2502.04790) : jusqu'à 94,5 % de tokens économisés si une voix peut répondre « RAS » (rien à signaler). Mon essai sur une salle pilote (12 septembre 2026) a été décevant le 21 : presque aucune économie, une voix ayant écrit « RAS. » puis un paragraphe complet. J'ai durci la clause (le mot seul) et gelé la généralisation.
- Exiger une preuve pour terminer. Evidence-Carrying Termination, août 2026, préprint (https://arxiv.org/abs/2608.23623) : quand chaque élément requis cite une preuve rejouable, 0 arrêt prématuré sur 66 contre 40 sur 66. C'est l'idée du mode comité : une voix sans preuve pèse zéro.
- Classer les pannes. Cemri et al. (UC Berkeley) : 14 modes d'échec en trois familles, sur plus de 1 600 traces annotées (https://arxiv.org/abs/2503.13657). C'est ma grille de lecture des pannes.
Ce que ça m'a appris : une trouvaille de la veille est une hypothèse, pas une consigne. Des trois règles que j'en ai tirées pour les salles (cases du compte rendu, tour 2 conditionnel, voix qui se tait), deux ont tenu à l'usage, la troisième attend encore sa preuve.
Ce que les salles ont apporté
Le 27 septembre 2026, une règle a été posée : tout travail de développement (un correctif, une fonctionnalité, une nouvelle garde de sécurité) passera désormais entre deux salles, sans exception décidée en silence.
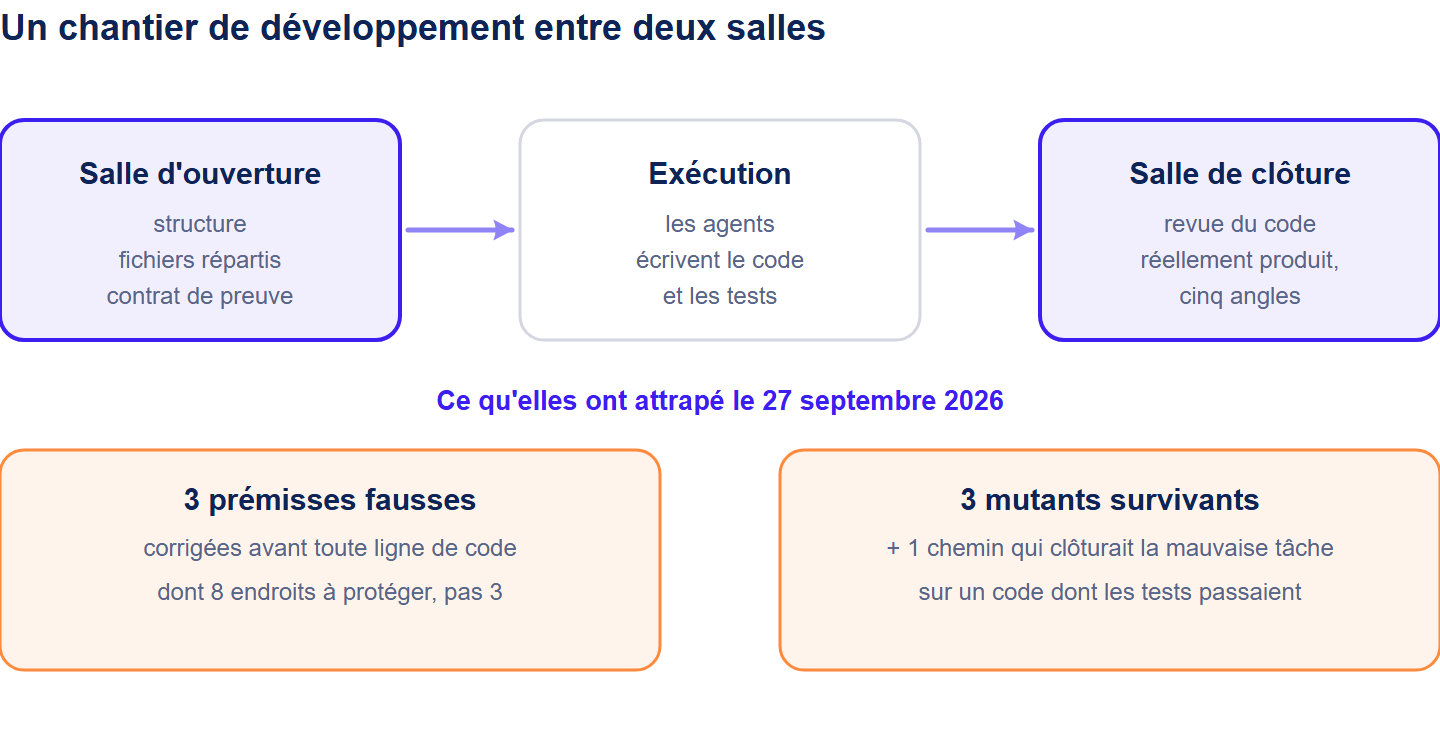
La salle d'ouverture siège avant la première ligne de code : elle répartit les fichiers pour que deux agents ne modifient jamais le même et écrit le contrat de preuve. La salle de clôture siège après, sur le code réellement produit, avec cinq angles d'attaque en parallèle (sécurité, adversaire, cas limites, qualité de facture, capacité à livrer).
À l'ouverture de la séance qui a motivé la règle, trois prémisses du plan se sont révélées fausses avant qu'une ligne soit écrite :
- une information censée signaler qu'une tâche était terminée s'écrit aussi au moment où elle commence : la garde bâtie dessus aurait refusé une clôture légitime ;
- un repère textuel qu'on croyait unique existait sous deux formes ;
- le plan prévoyait de protéger trois endroits de l'affichage. Il y en avait huit.
À la clôture, tous les tests passaient. La revue de code a pourtant trouvé trois « mutants survivants » : des erreurs glissées exprès dans le code, que les tests n'ont pas remarquées, donc des tests qui ne protégeaient pas ce qu'on croyait. Elle a aussi trouvé un chemin qui clôturait la mauvaise tâche tout en annonçant que tout s'était bien passé. Pour quelqu'un qui ne lit pas le code, ces défauts sont invisibles : tout est vert.
Deuxième épisode, le 1er octobre 2026. Cinq voix, une question : quand une garde plante, on laisse passer ou on bloque ?
Au premier tour, les positions se ressemblaient : « un jour, une commande piégée fera tomber la garde ; il faut prévoir le pire ». Toutes les voix cherchaient le danger au même endroit, dans le texte des commandes. Puis les essais que les voix ont faits sur la garde se sont recoupés, et le tableau a changé. Ce que j'ai pu refaire le 4 octobre 2026, et ce que je n'ai pas refait :
- 9 messages mal formés (une commande transmise comme un nombre ou une liste au lieu d'un texte, par exemple), envoyés à mes 11 gardes : 12 plantages, sur 2 gardes ;
- 25 commandes hostiles (caractères invalides, chaînes de plusieurs centaines de milliers de caractères, imbrications sans fin) : essai du 1er octobre, non rejoué depuis.
Le danger n'était pas là où tout le monde le cherchait. Avant d'arbitrer entre « tout laisser passer » et « tout bloquer », il fallait refuser proprement les messages mal formés.
La salle a aussi laissé deux désaccords réels écrits noir sur blanc, avec les arguments de chaque camp. C'est son meilleur livrable. Un compte rendu où tout le monde est d'accord sur une question difficile signale souvent une question mal posée.
Troisième exemple, le 8 octobre 2026, sur du code : la revue d'une évolution de mon dispositif qui ajoutait un mode de salle. Cinq voix, deux tours, trois défauts : une erreur d'exécution quand le champ « mode » du journal contenait autre chose qu'un texte, une documentation qui listait deux modes au lieu de trois, et la même liste de modes écrite à deux endroits. Les corrections tiennent en un commit (8976f15d), avec un test qui devient rouge quand on retire la protection ajoutée : celui-ci laisse des traces qu'on peut relire.
Que valent ces trois épisodes comme preuves ? Certains se rejouent par un script, d'autres ne reposent que sur ce que j'ai vu en séance.
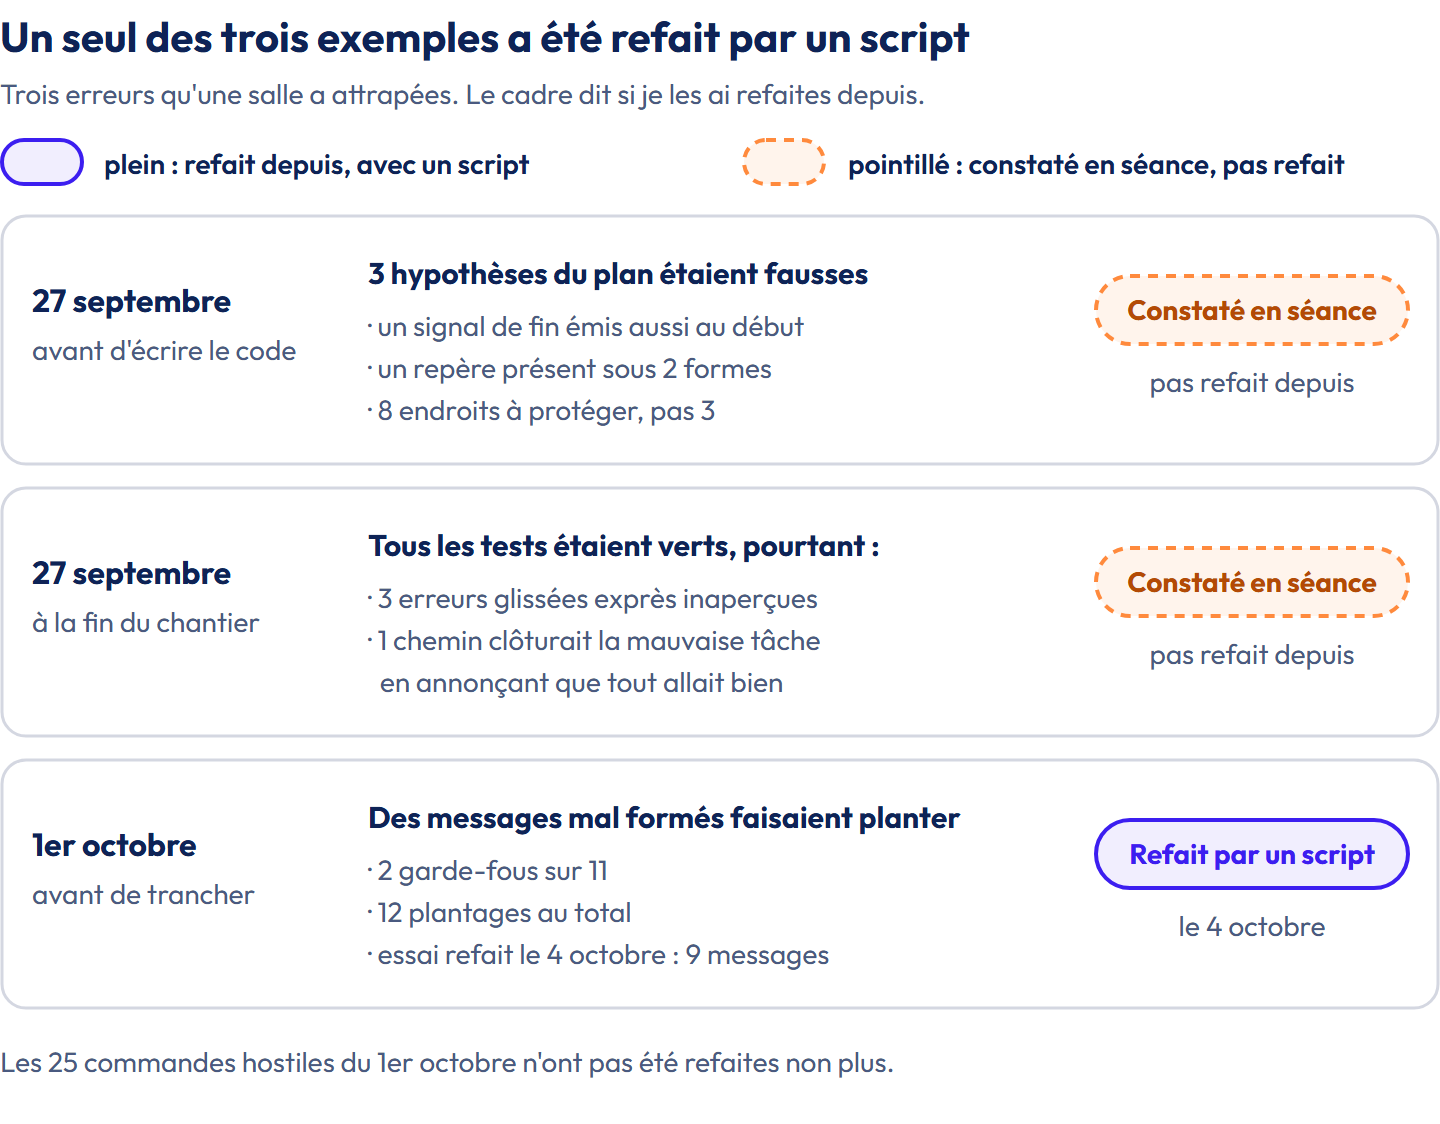
Seul le troisième exemple a été refait depuis par un script : les deux premiers ont été constatés pendant la séance.
Ce qui ne marche pas
Les salles ne sont pas une solution clé en main. Voici ce qui peut mal tourner.
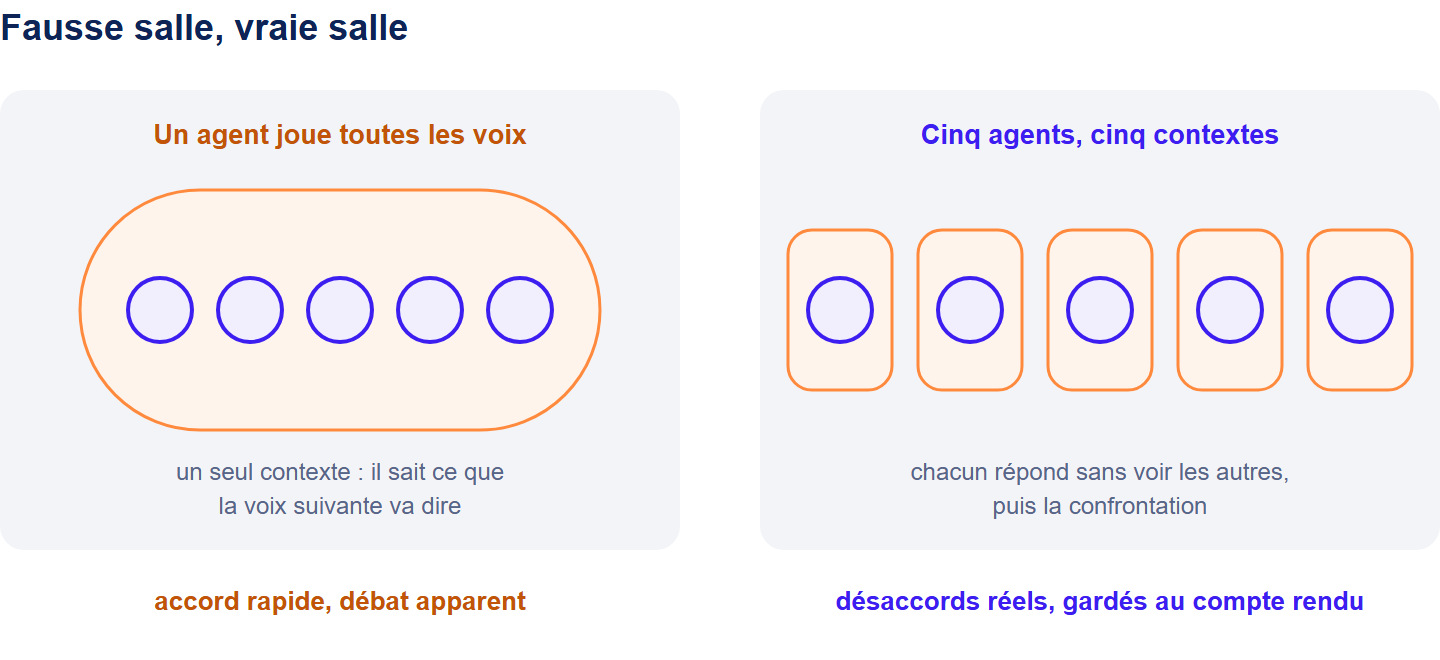
La fausse salle. Le matin, l'orchestrateur convoque quatre salles. Trois sont en réalité tenues par un seul agent qui joue toutes les voix à tour de rôle. Ce n'était pas une panne : les trois avaient l'outil sous la main, et l'un écrit même « j'ai fait la revue directement ». Or le comédien connaît déjà la réplique suivante : il ne se contredit pas, il se donne la réplique. Ma règle exigeait déjà un contexte par voix, mais une consigne écrite ne retient pas un agent pressé. J'ai donc ajouté un détecteur : à la fin de chaque séance, un programme vérifie que les voix ont réellement travaillé et signale la salle jouée par un seul acteur.
L'animateur pressé. La salle sur les gardes lance bien cinq vraies voix, mais l'agent qui l'anime revient sept fois avec un compte rendu avant que les voix aient répondu ; seul le huitième contient leurs positions. Un compte rendu remis trop tôt est pire qu'un compte rendu absent : il a l'air complet. Ma règle : toutes les voix sont lancées d'un coup, et on ne conclut qu'après avoir écrit « cinq voix lancées, cinq rendues ».
La salle qui traîne. Fin septembre, un atelier de développement dure environ deux heures, bien au-delà du nécessaire ; lors d'une autre séance, un agent reste bloqué plus de deux heures sur un programme orphelin (celui qui l'avait lancé a disparu), qui attend une saisie qui ne viendra jamais. J'en ai tiré trois règles : un programme de surveillance qui signale toutes les cinq minutes les agents encore en cours, un budget de temps écrit dans la consigne de chaque voix, et des voix sur un modèle plus léger, le modèle le plus puissant étant réservé au rôle qui structure la séance.
Le faux consensus. C'est le travers le plus discret : les faits nuancés s'effacent au fil des tours, puis les positions convergent sans que le désaccord de fond soit réglé. Je l'avais constaté avant de le lire dans le préprint cité plus haut. D'où les deux cases obligatoires du compte rendu ; pour remplir la seconde, il faut relire les positions indépendantes et nommer ce qui a disparu en route.
Combien de fois je les ai réunies
Chaque tâche confiée aux agents est journalisée avec sa demande, son plan et son résultat. Sur 234 tâches, entre le 31 juillet et le 28 septembre 2026, 22 citent au moins une salle dans leur plan. Ce compte dit peu : une salle prévue au plan ne s'est pas forcément tenue avec plusieurs vraies voix, ni changé la décision. Des salles se sont bien tenues et des décisions ont bien changé (les épisodes ci-dessus), mais je les ai relevés un par un. Le total des décisions qu'une salle a modifiées, je ne le tiens pas. Depuis le 11 octobre 2026, le journal enregistre pour chaque salle son mode et, après coup, un verdict : a-t-elle changé la décision ? Au 12 octobre, il compte 1 salle et aucun verdict : trop tôt pour un total.
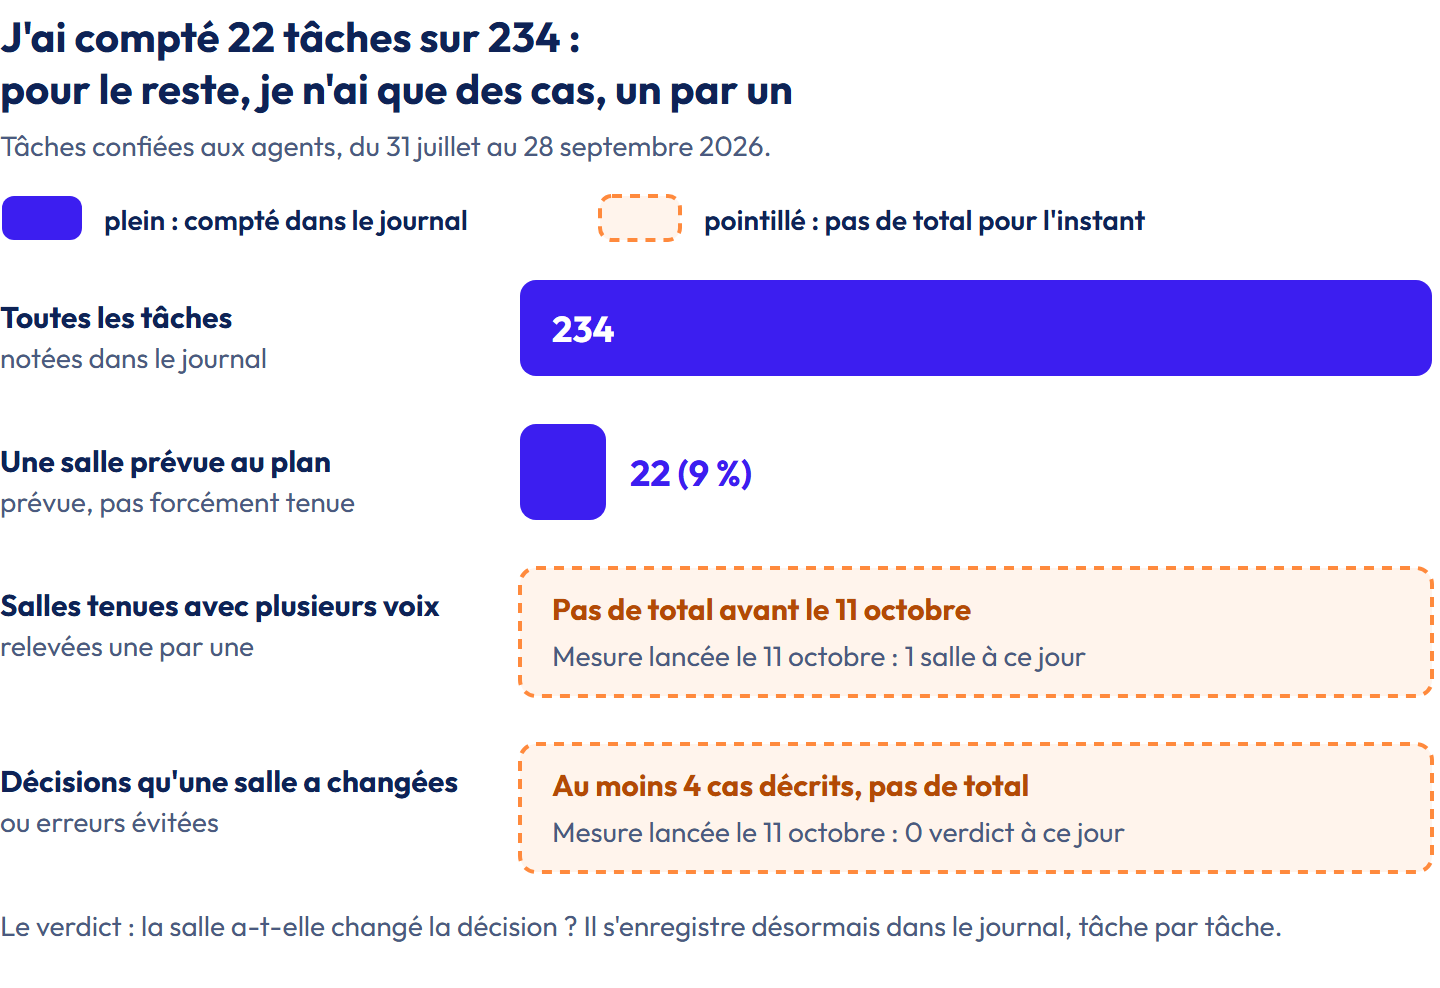
Ce que je sais compter (barres pleines) et ce que je n'ai que cas par cas (pointillés) : la mesure automatique a démarré le 11 octobre.
Ce que j'en retiens comme coach
Une salle d'agents a les mêmes pièges qu'un atelier humain : elle vaut par sa facilitation, pas par le nombre de chaises. Devant un compte rendu, je pose trois questions, les mêmes qu'à la sortie de n'importe quel atelier :
- Chaque voix a-t-elle vraiment parlé ? Un seul agent qui a joué tous les rôles, ce n'est pas une salle.
- Qu'est-ce qui a été perdu entre le premier tour et la synthèse ? Les faits nuancés partent les premiers.
- Quel désaccord reste ouvert ? Aucun, sur une question qui justifiait une salle ? Méfiance.
Deux choses ne se délèguent pas à une salle : le choix du sujet, et l'arbitrage, quand deux positions restent face à face et que je tranche avec un contexte que les agents n'ont pas, comme un utilisateur mécontent ou une échéance. Reste une exception à la règle des deux salles : pour un changement d'une ligne, c'est lourd. Un agent qui juge le chantier trop petit me demande en une phrase quelle salle sauter ; il ne s'exempte pas tout seul.
Les salles ne remplacent pas la parole des utilisateurs, que mon article précédent disait irremplaçable. Elles apportent autre chose : la contradiction, au moment où elle coûte le moins cher, avant que le code existe.
Conclusion
Faire délibérer des agents ne rend pas une décision juste. Cela rend visibles les erreurs qu'un agent seul aurait affirmées avec aplomb, à condition que la délibération soit réelle et que le compte rendu garde ce qui dérange.
Pour essayer, commencez petit : réservez les salles aux choix difficiles, donnez à chaque voix son propre contexte, exigez dans chaque compte rendu les désaccords qui restent et les faits perdus en route, et vérifiez qu'il y avait bien plusieurs voix autour de la table, même quand ce sont des agents.
La suite logique, je l'ai commencée : le mode comité. En mode classique, on croise des avis ; en mode comité, chaque voix doit apporter une preuve rejouable, et une voix sans preuve pèse zéro dans la synthèse. Ce n'est qu'un essai borné, sur une dizaine de tâches, au prix d'environ deux fois plus de sessions, et ses vérificateurs (les agents chargés de contrôler les preuves) se sont montrés trop accommodants. Les tâches de test avaient une réponse objective : on ignore ce que cela vaut sur une question ouverte.
Le prochain article, « Mes agents lisaient trop : ce que dix semaines de chasse aux tokens m'ont appris », regarde ce que coûtent tous ces agents : une salle se paie en sessions, et chaque session en tokens. Au programme : un agent qui relit un fichier de 584 Ko pour y chercher une date, et une facture qui fait plus de bruit que le débat. Venez avec votre calculette.
Note de l'auteur
Pour cet article, j'ai de nouveau boxé quelques rounds avec l'IA 🥊 : elle frappe vite, moi je réfléchis entre deux reprises. Les chiffres viennent du journal de mes tâches (31 juillet au 28 septembre 2026), de mes fichiers de configuration au 1er octobre 2026 et, pour la mesure lancée le 11 octobre, du journal au 12 octobre. Les messages mal formés ont été rejoués le 4 octobre, pas les 25 commandes hostiles ; deux faits du 1er octobre et les trois prémisses fausses du 27 septembre ont été relevés pendant les séances et n'ont pas pu être recomptés.