Le développement agentique est-il le fossoyeur de la modélisation métier ? - Part 1
Le développement agentique est-il le fossoyeur de la modélisation métier ? - Part 1
À l’ère des agents, notre avantage ne viendra peut-être plus de notre capacité à produire plus vite ce que nous savons déjà, mais de notre capacité à apprendre plus vite ce que nous devons réellement construire.
Nous explorerons progressivement cette tension afin de proposer une démarche permettant de concilier la richesse de la modélisation métier avec la vitesse et les capacités du développement agentique.
Dans la suite de mon propos, j’utiliserai le terme générique SDD (Spec-Driven Development). Il pourra cependant être remplacé par l’implémentation ou le framework le mieux adapté à votre contexte :
- GitHub Spec Kit
- OpenSpec
- Kiro
- Tessl
- CodeMySpec
- BMAD Method
L’important ici n’est donc pas l’outil choisi, mais le principe : faire de la spécification et du contexte partagé le point de départ du développement agentique.
Le contexte présenté ici est celui de la création d’un nouveau produit, avec une ambition forte : s’imposer comme une référence et devenir leader sur son marché.
Table des matières
- L’excellence du code à l’ère du développement agentique
- Comment naissent les modèles métier ?
- La contextualisation agentique inverse partiellement cette logique
- Le paradoxe de l’autonomie agentique
- Du mini-waterfall à la Micro-Learning Loop
- Le SDD comme support de la Micro-Learning Loop
- Du Time to Learn au Learning per Token
- De l’AI Software Factory à la Learning Factory
1 - L’excellence du code à l’ère du développement agentique
Pour les praticiens du TDD, les défenseurs du Clean Code et plus largement, celles et ceux qui considèrent le code comme une véritable matière de conception, l’arrivée du développement agentique peut susciter une certaine frustration.
Confier à l’IA la génération de l’essentiel du code, conception comprise, peut presque sembler sacrilège pour ceux qui ont passé des années à développer leur capacité à modéliser à travers le code. Car coder ne consiste pas simplement à traduire une solution déjà pensée. C’est aussi une manière d’explorer un problème, d’éprouver un modèle et d’en révéler progressivement les limites.
Une question se pose alors : cette révolution va-t-elle progressivement faire disparaître l’acte même de coder ? Au point que, dans quelques années, il devient difficile de trouver des développeurs capables d’identifier intuitivement un code smell, de percevoir une abstraction maladroite ou de sentir qu’un modèle traduit maladroitement le métier ?
Dans cette perspective, Eric Evans, à l’origine du Domain-Driven Design, a proposé de préserver la pratique directe du code, notamment dans le Bounded Context de type Core Domain, là où se concentrent la complexité et la différenciation métier. L’idée est séduisante : si nous devons continuer à exercer directement notre capacité de conception quelque part, autant le faire là où elle produit le plus de valeur.
Mais, aussi raisonnable soit-elle, cette proposition risque de se heurter à une réalité économique difficile à ignorer. Les organisations voient dans les agents une possibilité d’accélérer considérablement le développement tout en réduisant son coût. Dans ce contexte, réserver volontairement certaines parties du logiciel au développement humain pourrait rapidement apparaître comme un luxe difficile à défendre.
La complexité métier constitue un point d’attention majeur
Pourtant, la question prend une tout autre dimension dès lors que la complexité métier devient significative.
Lorsque plusieurs règles s’entrelacent, se contraignent mutuellement ou produisent ensemble des comportements difficiles à anticiper, comprendre le problème demande du temps. J’ai pu rencontrer ce type de situation dans les produits structurés en finance de marché : comprendre chaque règle indépendamment est nécessaire, mais insuffisant. La véritable difficulté consiste à comprendre ce qui se produit lorsque toutes ces règles interagissent.
C’est précisément dans ces situations que le code peut devenir autre chose qu’un simple livrable :
- Un instrument de raisonnement.
Excellence logicielle et IA agentique : sont-elles compatibles ?
Implémenter, tester, refactorer et observer les conséquences d’un choix de conception participent directement à la compréhension du domaine, en complément des ateliers de découverte tels que l’EventStorming Big Picture ou l’EventStorming Software Design. Le modèle et le code évoluent ainsi conjointement, au fil des expérimentations et des échanges avec les experts métier. L’implémentation ne constitue plus seulement l’aboutissement de la conception : elle devient un moyen d’éprouver le modèle, d’en révéler les limites et d’approfondir progressivement la connaissance du domaine.
Cela soulève une question essentielle pour le développement agentique. Les modèles d’IA sont particulièrement performants lorsqu’ils peuvent mobiliser des structures, des connaissances et des exemples déjà largement représentés. Mais la complexité métier propre à une entreprise est d’une autre nature : elle repose souvent sur des règles implicites, interdépendantes, parfois contradictoires, dont certaines ne sont pas encore connues lorsque nous commençons à modéliser le domaine. Elles émergent progressivement de l’exploration, de l’expérimentation et de la confrontation du modèle à des situations concrètes.
Le problème n’est donc peut-être pas de savoir si l’IA saura écrire le code à notre place. Elle le fera de mieux en mieux.
La véritable question est ailleurs : si nous abandonnons entièrement l’acte de coder, ne risquons-nous pas d’abandonner avec lui une partie de la boucle intellectuelle qui nous permet de découvrir, d’éprouver et, finalement, de comprendre profondément le métier ?
Les chefs-d’œuvre de la Renaissance
Prenons l’exemple de la sculpture. La comparaison entre la statuaire grecque et celle de la Renaissance permet d’observer comment une maîtrise technique héritée peut être réinterprétée pour produire une œuvre singulière. Le David de Michel-Ange l’illustre magistralement : la maîtrise de l’anatomie, des proportions et de la matière n’est qu’un point de départ. C’est la tension du corps, l’intensité du regard, la posture et l’intention insufflée au marbre qui donnent à l’œuvre sa puissance et lui permettent de traverser les siècles.
Cette quête d’excellence caractérise plus largement la Renaissance. Profondément nourri par l’humanisme et par la redécouverte de l’Antiquité, l’art ne cherche pas seulement à maîtriser ou reproduire des formes : il devient un moyen d’explorer l’humain, d’interroger le réel et de proposer de nouvelles représentations du monde.
Les œuvres de Sandro Botticelli, comme celles de nombreux artistes de cette époque, nous rappellent ainsi une idée essentielle : l’excellence ne réside pas nécessairement dans une sophistication supplémentaire, mais dans la capacité à dépasser la maîtrise technique pour donner à une œuvre une intention, une singularité et une profondeur qui la rendent exceptionnelle.
La naissance de vénus - Sandro Botticelli
Car une œuvre exceptionnelle ne se contente pas de répondre parfaitement à ce que nous attendions d’elle. Par sa beauté, sa singularité ou son expressivité, elle peut déplacer notre regard, nous interroger et faire émerger des possibilités que nous n’avions pas envisagées.
C’est peut-être là que réside une distinction essentielle : une réalisation maîtrisée apporte une excellente réponse à un problème connu ; une réalisation exceptionnelle peut nous conduire à reconsidérer le problème lui-même et à entrevoir ce que nous n’avions pas encore imaginé.
Cette distinction prend tout son sens dans un domaine métier complexe, où le problème à résoudre n’est souvent que partiellement connu au départ. Certaines règles restent implicites, certains concepts sont encore ambigus et certaines interactions ne se révèlent qu’au moment où nous cherchons à les modéliser et à les confronter à des situations concrètes.
La difficulté ne consiste donc pas seulement à transformer correctement une spécification en logiciel, mais à faire émerger progressivement la connaissance qui permettra de comprendre ce que cette spécification devrait réellement contenir.
2 - Comment naissent les modèles métier ?
Dans le développement logiciel, le Model-Driven Design est sans doute l’une des approches les plus adaptées pour explorer la complexité métier jusque dans le code. Il permet de prolonger la compréhension du domaine dans l’implémentation elle-même, en faisant du code non seulement la traduction d’un modèle, mais aussi un moyen de l’éprouver, de le questionner et de le faire évoluer.
Mais qu’est ce qu’un modèle ?
Un modèle est une représentation simplifiée d'une chose ou d'un
phénomène qui met intentionnellement en avant certains aspects tout en ignorant d'autres. Une abstraction conçue dans un but précis.
― Rebecca Wirfs-Brock
En d’autres termes, esquisser un modèle dans un domaine métier complexe exige une réflexion profonde. Adopter une démarche collaborative et itérative jusque dans la phase de codage prend alors tout son sens : le code devient lui-même un instrument d’exploration et de compréhension du domaine.
Vassily Kandinsky, ou la quête du spirituel à travers l’art.
Trouver une modélisation élégante suppose en effet de comprendre suffisamment finement le problème métier pour parvenir à décomposer sa complexité en concepts et comportements simples, cohérents et expressifs. Le code n’est donc pas seulement l’implémentation d’un modèle conçu en amont : il en constitue l’une des représentations et participe à son élaboration. En confrontant cette représentation aux situations métier, l’équipe éprouve ses hypothèses, en révèle les limites et affine progressivement sa compréhension du domaine.
C’est précisément cette dynamique que soutient le Model-Driven Design. Il s’appuie sur trois dimensions complémentaires qui permettent de transformer progressivement la compréhension du domaine en un modèle métier riche, puis de l’incarner dans un code qui en exprime fidèlement les concepts et les comportements.
L’approche Model-Driven Design repose sur trois dimensions complémentaires qui permettent de transformer progressivement la compréhension du domaine en un modèle métier riche, puis de l’incarner dans un code qui en exprime fidèlement les concepts et les comportements.
- Building Blocks — un ensemble de patterns tactiques — Entities, Value Objects, Aggregates, Repositories, Services, etc. — qui fournissent les briques nécessaires pour structurer le modèle et son implémentation de manière cohérente.
- Supple Design — un ensemble de principes et de patterns de conception visant à rendre le modèle et le code expressifs, explicites, composables et faciles à faire évoluer, afin que leur structure révèle aussi clairement que possible les intentions du domaine.
- Deep Modeling — une démarche itérative d’approfondissement du modèle métier, dans laquelle chaque nouvelle compréhension du domaine peut conduire à remettre en question les concepts existants et à faire évoluer conjointement le modèle et le code, dans une forme de refactoring guidé par le métier.
Face à la complexité d’un domaine métier, faire émerger un modèle capable d’en exprimer toute la richesse dans le logiciel reste une démarche délicate. Le modèle ne précède pas entièrement l’implémentation :
- il se construit aussi à travers elle.
Dès qu’une première représentation du domaine prend forme, même imparfaite, son implémentation permet de la rendre concrète, de l’éprouver et d’en révéler les limites.
Pourquoi utiliser un code prototype ?
Un prototype, aussi rudimentaire soit-il, devient alors un instrument d’apprentissage. En confrontant le modèle au code, aux scénarios métier et au regard des experts, l’équipe fait apparaître des ambiguïtés, des incohérences ou de nouveaux concepts. Ces découvertes enrichissent à leur tour le modèle, qui conduit à une nouvelle implémentation.
Le Model-Driven Design installe ainsi une boucle continue entre compréhension du métier, modélisation et code : nous implémentons pour comprendre, puis nous utilisons ce que nous avons appris pour mieux modéliser.
Le recours à un prototype est systématique dans cette approche, que le produit existe déjà ou qu’il soit encore à construire. Il permet d’explorer rapidement différentes pistes tout en s’appuyant sur une base de code volontairement réduite. Les cycles de compilation et d’exécution deviennent ainsi quasi immédiats, offrant un feedback rapide sur les hypothèses formulées et les règles métier à valider. Le prototype devient alors moins un démonstrateur qu’un instrument d’apprentissage, conçu pour confronter rapidement le modèle à la réalité du domaine.
Comment le modèle s’affine et s’enrichit ?
Le modèle et le logiciel commencent alors à se nourrir mutuellement au fil des itérations. La compréhension du domaine s’affine dans l’esprit des personnes impliquées, tandis que le prototype donne une incarnation concrète aux concepts qui émergent de leurs échanges.
L’implémentation devient ainsi un moyen de mettre le modèle à l’épreuve. Elle permet d’en tester la pertinence, d’en révéler les ambiguïtés, de confronter les hypothèses à des situations concrètes et de faire émerger de nouvelles questions. En retour, les apprentissages issus de cette expérimentation enrichissent le modèle, remettent en cause certaines hypothèses et conduisent progressivement à le transformer.
Pour rendre cette approche plus concrète et en exprimer visuellement la dynamique, Eric Evans propose la métaphore du « Whirlpool », le tourbillon.
Le schéma présenté ci-dessous formalise une démarche qu’il a expérimentée pendant plusieurs années auprès de différents clients, sous diverses formes et dans des contextes variés.
Le choix du tourbillon n’est pas anodin. Il souligne le caractère profondément itératif et non linéaire de l’exploration du modèle métier. L’équipe ne progresse pas selon une succession figée d’étapes : elle revient continuellement sur sa compréhension du domaine, confronte ses hypothèses, expérimente différentes représentations et affine progressivement son modèle.
Le Whirlpool ne constitue donc pas un processus de développement à proprement parler. Il s’agit plutôt d’une démarche d’exploration et d’apprentissage, susceptible de s’intégrer à la plupart des processus de développement reposant sur une conception itérative.
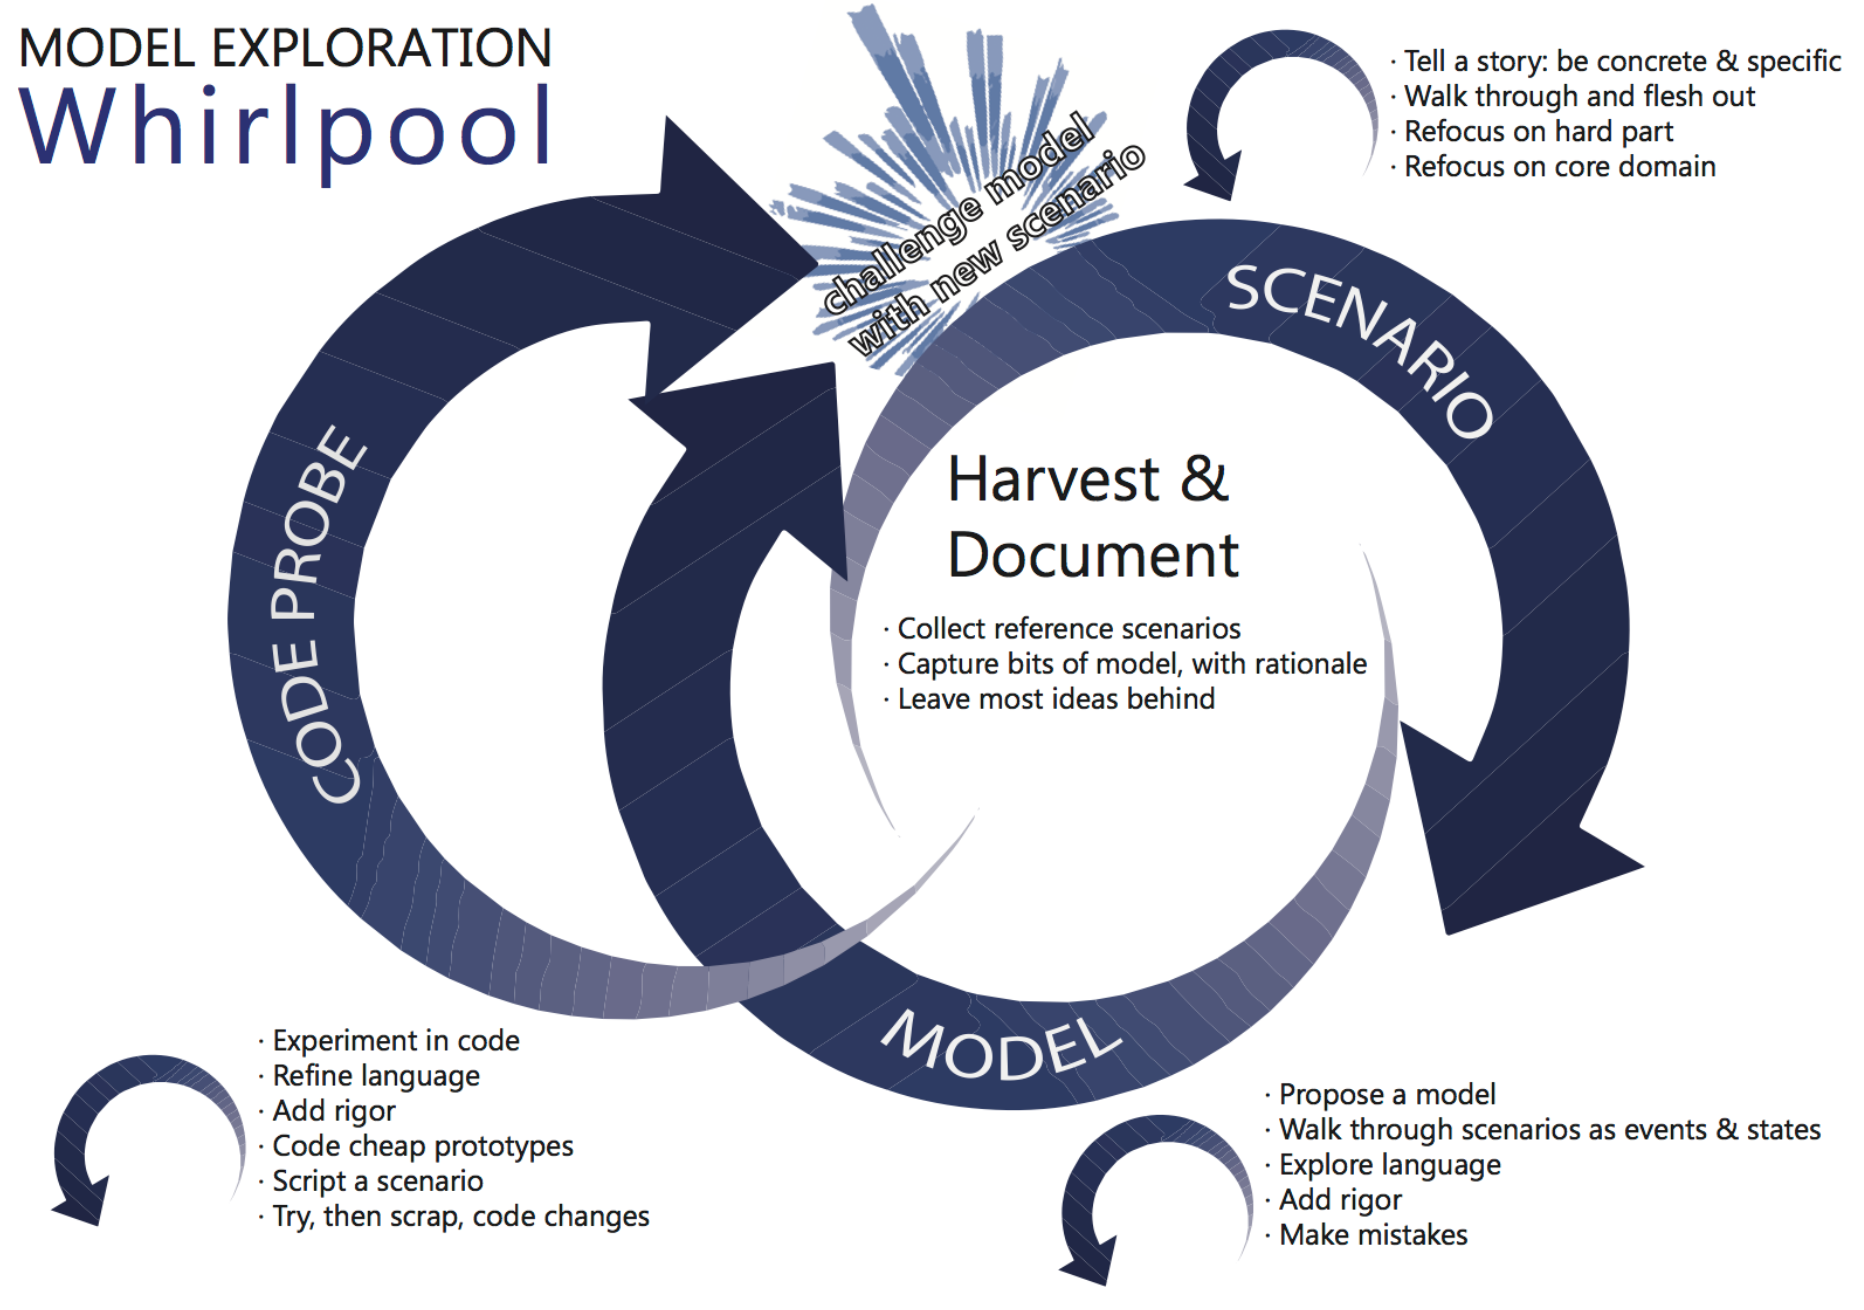
Eric Evans - Model Exploration Whirlpool
Les échanges entre experts métier et développeurs jouent un rôle essentiel dans cette dynamique. Discussions, séances de brainstorming, exploration de scénarios et expérimentation autour du logiciel contribuent à construire une compréhension partagée du domaine. Le langage ubiquitaire évolue avec cette compréhension et se retrouve progressivement dans le modèle puis dans le code.
Le modèle métier ne précède donc pas entièrement son implémentation. Il émerge et s’affine dans la confrontation permanente entre notre compréhension du domaine et son incarnation dans le logiciel. Chaque incrément devient une occasion d’apprendre, de questionner les hypothèses existantes et, parfois, de découvrir une représentation profondément différente du problème.
La construction du logiciel ne constitue donc pas seulement l’aboutissement de la modélisation : elle participe elle-même à la découverte du modèle.
La modélisation comme boucle d’apprentissage
Toute la connaissance nécessaire à la conception du logiciel n’est jamais disponible au début d’un projet. Elle est fragmentée entre les experts, les utilisateurs, les documents, les systèmes existants et les expériences passées. Plus fondamentalement encore, une partie de cette connaissance n’existe pas encore : elle émerge des discussions, des désaccords, des expérimentations et de la confrontation du modèle à des situations que personne n’avait encore envisagées.
La modélisation ne peut donc pas être considérée comme une activité préalable au développement, qui consisterait à comprendre entièrement le problème avant de commencer à coder. Elle constitue au contraire une boucle d’apprentissage continue, dans laquelle chaque étape produit de nouvelles connaissances :
- Comprendre → Modéliser → Implémenter → Observer → Apprendre → Reconsidérer le modèle
À chaque passage dans cette boucle, notre représentation du domaine peut gagner en précision. Un concept peut être renommé, une responsabilité déplacée, une règle reformulée, un agrégat redessiné ou une abstraction entière abandonnée au profit d’une représentation plus pertinente.
Le Deep Modeling prend alors tout son sens : approfondir le modèle ne consiste pas simplement à lui ajouter davantage de détails. Il s’agit de rechercher, itération après itération, une représentation plus juste, plus expressive et parfois plus simple du domaine.
C’est dans cette capacité à remettre en question le modèle existant que se situe une part essentielle de l’apprentissage. Nous ne cherchons pas seulement à mieux implémenter ce que nous savons déjà ; nous utilisons l’implémentation pour découvrir ce que nous ne savions pas encore.
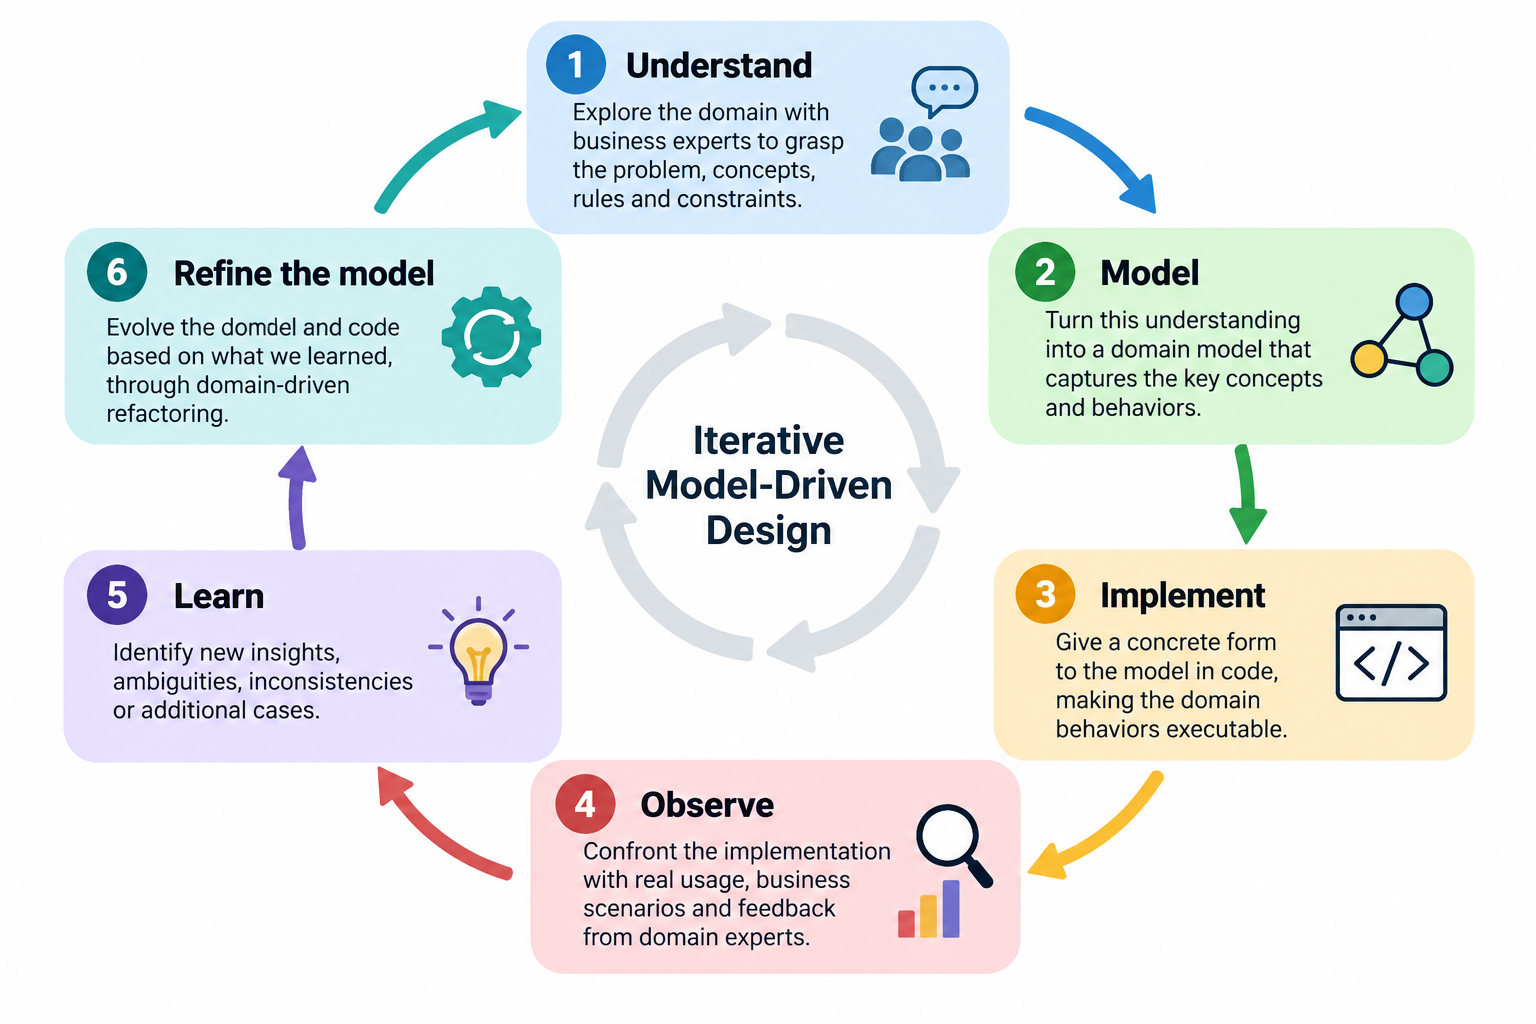
- Comprendre → Modéliser → Implémenter → Observer → Apprendre → Réviser le modèle ↺
Les étapes de la modélisation d’un problème métier complexe
- Comprendre le domaine consiste à explorer le problème avec les experts métier afin d’en saisir les enjeux, les concepts, les règles et les contraintes. Cette compréhension reste nécessairement partielle : elle constitue un premier état de notre connaissance du domaine.
- Modéliser consiste à transformer cette compréhension en une représentation capable d’exprimer les concepts et les comportements essentiels du domaine. Le modèle n’est pas considéré comme définitif, mais comme une hypothèse que l’implémentation permettra d’éprouver.
- Implémenter donne une incarnation concrète au modèle dans le logiciel. L’objectif n’est pas seulement de produire du code, mais de vérifier que le modèle peut effectivement porter les comportements métier que nous cherchons à représenter.
- Observer consiste à confronter cette incarnation aux scénarios métier, aux usages et au regard des experts du domaine. Le prototype rend les concepts manipulables et fait apparaître des ambiguïtés, des incohérences ou de nouveaux cas difficiles à percevoir lors des discussions initiales.
- Apprendre consiste à transformer ces observations en nouvelles connaissances. Certaines hypothèses sont confirmées, d’autres remises en question, tandis que de nouvelles règles ou de nouveaux concepts peuvent émerger.
- Réviser le modèle, enfin, consiste à intégrer ces apprentissages : préciser un concept, déplacer une responsabilité, formuler une règle ou, parfois, remettre en cause une partie entière de notre représentation du domaine. Ce nouveau modèle nourrit alors l’itération suivante et relance la boucle.
Le prototype n’est donc pas seulement le résultat du modèle. Il devient à son tour un instrument de découverte du domaine.
Le Model-Driven Design se pratique au sein d’un Bounded Context, en particulier lorsque celui-ci porte une forte complexité métier. Le langage ubiquitaire y façonne progressivement les modèles mentaux partagés par l’équipe et devient un puissant accélérateur de la modélisation.
Dans cette démarche, le code n’est plus simplement l’implémentation d’un modèle conçu en amont : il en devient le miroir. En donnant une forme concrète aux concepts, aux règles et aux comportements métier, il permet à l’équipe de manipuler le modèle, d’en révéler les ambiguïtés et d’en éprouver la cohérence.
Une boucle courte s’installe alors entre métier, modèle et code. Chaque modification du modèle peut être expérimentée dans le logiciel ; chaque difficulté rencontrée dans l’implémentation peut, en retour, questionner le modèle. La confrontation régulière avec les experts métier fait émerger de nouvelles questions, affine la compréhension du domaine et peut révéler des opportunités jusque-là invisibles.
C’est le principe même du Deep Modeling : il ne s’agit pas simplement d’enrichir progressivement le modèle en accumulant toujours davantage de détails, mais de rechercher une représentation plus juste, plus expressive et parfois radicalement plus simple du domaine.
Au fil de cette exploration peut survenir, plus rarement, une véritable percée conceptuelle (Breakthrough). Après plusieurs itérations, une compréhension nouvelle du métier vient bouleverser le modèle que l’équipe avait progressivement construit. Des concepts que l’on pensait indispensables disparaissent, certaines responsabilités se réorganisent et de nouvelles abstractions émergent.
Le progrès ne vient alors plus d’un raffinement supplémentaire du modèle existant, mais d’un changement de perspective : un problème jusque-là perçu comme complexe peut soudain être exprimé par un modèle plus simple, plus juste et plus puissant.
Cette manière de développer reste pourtant relativement rare. Deux obstacles l’expliquent en grande partie.
D’abord, l’apprentissage du DDD est un long chemin. Maîtriser ses patterns tactiques ne suffit pas : expérimenter réellement le Model-Driven Design demande du temps, de la pratique et l’occasion de travailler sur des domaines suffisamment complexes pour en percevoir toute la valeur.
Ensuite, cette approche suppose une collaboration étroite et continue avec les experts métier pendant le développement. Or cette proximité reste inhabituelle dans de nombreuses organisations. Elle apparaît davantage dans certaines pratiques collaboratives, comme le mob programming, lorsque développeurs et experts métier peuvent observer ensemble les conséquences d’un choix de modélisation et faire évoluer immédiatement leur compréhension du problème.
C’est pourtant précisément dans cette boucle courte entre métier, modèle et code que réside une grande partie de la puissance du Model-Driven Design : le code ne sert plus seulement à construire le logiciel ; il devient un moyen d’apprendre ce que le logiciel devrait réellement être.
3. La contextualisation agentique inverse partiellement cette logique
Le développement agentique introduit une dynamique sensiblement différente. Pour qu’un agent puisse travailler efficacement et avec un degré élevé d’autonomie, nous devons lui fournir suffisamment de contexte pour comprendre ce qu’il doit construire, pourquoi il doit le construire et quelles contraintes il doit respecter.
L’agentique déplace le curseur vers la contextualisation
Intention produit, modèle métier, règles et exemples, architecture, conventions de développement, contraintes techniques, critères d’acceptation ou décisions antérieures constituent autant d’éléments susceptibles d’orienter son travail. La qualité de ce que produit l’agent dépend alors fortement de la qualité, de la cohérence et de la précision du contexte qui lui est fourni.
Cette exigence nous incite naturellement à déplacer une part importante de l’effort en amont de la génération du code. Nous cherchons d’abord à comprendre le problème, à expliciter les connaissances disponibles et à les organiser dans un contexte suffisamment précis pour permettre ensuite à l’agent de prendre en charge une part croissante de l’exécution.
La dynamique tend alors à devenir :
- Comprendre → Formaliser → Contextualiser → Générer → Valider
Pris isolément, chacun de ces cycles peut être extrêmement court. Nous sommes évidemment très loin du waterfall traditionnel, dans lequel plusieurs mois pouvaient séparer la rédaction des spécifications de la livraison du logiciel. Avec les agents, cette chaîne peut désormais être parcourue en quelques heures, voire parfois en quelques minutes.
Pourtant, malgré cette accélération spectaculaire, la structure intellectuelle du processus peut rester étonnamment similaire. Nous pourrions parler d’une forme de mini-waterfall agentique.
À chaque incrément, nous sommes en effet tentés de constituer un contexte aussi complet, cohérent et précis que possible avant de laisser l’agent prendre le relais. Plus ce contexte est explicite, plus nous pouvons espérer accroître son autonomie, réduire les ambiguïtés et limiter les interactions humaines nécessaires pendant l’exécution.
Le risque apparaît lorsque nous commençons à considérer cette contextualisation comme une connaissance qu’il faudrait stabiliser avant d’implémenter, plutôt que comme une hypothèse destinée à être éprouvée par l’implémentation.
Accélérer sans figer notre compréhension du problème
C’est précisément là que la dynamique peut s’éloigner du Model-Driven Design. Dans sa boucle d’apprentissage, le modèle nourrit le code, mais le code nourrit en retour le modèle. Dans un mini-waterfall agentique, nous risquons au contraire de privilégier une circulation essentiellement descendante :
Connaissance → Contexte → Spécification → Code
Le code devient alors principalement le résultat de notre compréhension, alors qu’il pouvait auparavant constituer l’un des instruments permettant de la remettre en question et de l’approfondir.
Le véritable enjeu n’est donc pas de renoncer à la contextualisation — elle est indispensable au développement agentique — mais d’éviter qu’elle ne fige prématurément notre compréhension du problème. Le contexte transmis aux agents devrait rester une représentation provisoire de ce que nous savons, destinée à être continuellement enrichie, contestée et parfois profondément remise en cause par ce que l’implémentation nous permet de découvrir.
La durée a changé. L’échelle s’est réduite. La production s’est considérablement accélérée.
Mais la connaissance peut, à nouveau, se mettre à circuler principalement dans une seule direction :
- Humains → Contexte → Agent → Code
Feedback de conformité ou feedback d’apprentissage ?
C’est ici qu’apparaît une différence fondamentale avec la boucle de modélisation du Model-Driven Design décrite précédemment.
Dans une démarche de modélisation du domaine, nous considérons notre modèle comme provisoire. Nous savons que notre compréhension est incomplète et nous construisons précisément pour la confronter à quelque chose de concret. L’implémentation n’est donc pas seulement le résultat du modèle : elle devient un moyen de l’éprouver, d’en révéler les limites, de faire émerger de nouvelles questions et, parfois, de découvrir que nous nous représentons mal le problème.
Dans un mini-waterfall agentique, la tentation est différente. Pour rendre l’agent aussi autonome que possible, nous cherchons à lui fournir un contexte suffisamment complet pour qu’il puisse exécuter sa tâche sans revenir constamment vers les humains. Nous sommes alors naturellement incités à lever les ambiguïtés, à préciser les décisions et à stabiliser la connaissance avant la génération.
Ce qui n’était initialement qu’une hypothèse de travail peut ainsi progressivement acquérir le statut d’une vérité à implémenter.
La différence paraît subtile, mais elle transforme profondément la dynamique du développement.
Dans la boucle du Model-Driven Design :
- Modèle → Implémentation → Apprentissage → Révision du modèle
Le modèle guide l’implémentation, mais ce que nous découvrons en implémentant peut, en retour, transformer le modèle.
Dans le mini-waterfall agentique :
- Contexte → Implémentation → Validation du contexte
Le contexte guide l’implémentation et celle-ci sert principalement à vérifier que l’agent a correctement produit ce qui lui avait été demandé.
Le feedback existe donc toujours, mais sa nature change.
- Le premier est un feedback de conformité :
L’agent a-t-il correctement implémenté ce que nous avions spécifié ?
- Le second est un feedback d’apprentissage :
Ce que nous venons de construire nous apprend-il quelque chose qui remet en question ce que nous pensions avoir compris du problème ?
Passer du Time to Code au Time to Learn
Cette distinction est essentielle. Un agent peut produire une implémentation parfaitement conforme à sa spécification alors même que cette spécification repose sur une compréhension incomplète, approximative ou erronée du domaine.
Nous pouvons donc réduire considérablement le temps nécessaire pour passer de la spécification au logiciel sans améliorer dans les mêmes proportions notre capacité à déterminer si nous construisons le bon logiciel.
Le risque du développement agentique n’est alors pas seulement de produire plus vite une mauvaise réponse. Il est plus subtil : nous pouvons construire une boucle de conformité extraordinairement efficace, capable de transformer presque instantanément nos hypothèses en logiciel, sans accélérer pour autant la boucle qui permet de remettre ces hypothèses en question.
Or, dans un domaine complexe, c’est précisément cette seconde boucle qui produit une grande partie de la valeur. L’enjeu n’est donc plus seulement de réduire le temps nécessaire pour produire du code, mais celui qui sépare une première compréhension du problème de la découverte d’une compréhension meilleure.
Accélérer le développement ne suffit plus. Il faut désormais chercher à accélérer l’apprentissage.
C’est ce déplacement qui nous conduit du Time to Code au Time to Learn.
4. Le paradoxe de l’autonomie agentique
Il existe ici un autre paradoxe du développement agentique. Nous cherchons légitimement à rendre les agents toujours plus autonomes. Pour cela, nous enrichissons leur contexte afin qu’ils puissent prendre davantage de décisions par eux-mêmes, poursuivre leur travail sans interruption et solliciter le moins possible les humains.
Au-delà de la fascination pour les agents autonomes
L’autonomie devient alors une mesure implicite de performance : plus un agent est capable d’aller loin sans intervention humaine, plus le dispositif paraît efficace.
Mais cette recherche d’autonomie peut avoir un effet inattendu : chaque interaction que nous cherchons à supprimer peut aussi être une occasion d’apprentissage.
Dans une équipe traditionnelle, une ambiguïté rencontrée par un développeur peut provoquer une discussion avec un expert métier. Cette discussion peut révéler une règle jusque-là implicite, faire apparaître un cas jamais envisagé ou remettre en question un concept du modèle. Ce qui semblait initialement être une interruption du développement devient alors un moment de production de connaissance.
Si notre objectif consiste à fournir suffisamment d’informations à l’agent pour qu’il n’ait plus besoin de poser de questions, nous risquons paradoxalement de supprimer certaines des situations dans lesquelles naissent les meilleures questions.
L’ambiguïté ne doit donc pas toujours être considérée comme un défaut du contexte qu’il faudrait éliminer avant de commencer à construire. Elle peut être le symptôme d’une connaissance qui manque encore au modèle.
Une question posée par un agent peut alors avoir autant de valeur que le code qu’il produit : elle révèle précisément l’endroit où notre compréhension collective doit encore progresser.
Le danger d’une validation expéditive
Un second risque apparaît si nous nous contentons de diriger les agents puis de valider rapidement leurs propositions, sans consacrer suffisamment de temps à l’exploration, à la créativité et à la remise en question de nos hypothèses.
Les mêmes modèles, confrontés à des problèmes comparables et guidés par des contextes similaires, peuvent naturellement nous conduire vers des solutions elles-mêmes similaires. Nous pourrions alors construire beaucoup plus rapidement des applications parfaitement fonctionnelles, mais dont la différenciation deviendrait de moins en moins perceptible par les utilisateurs.
C’est peut-être l’un des dangers de la validation expéditive : confondre notre capacité à vérifier rapidement qu’une solution est acceptable avec notre capacité à découvrir une solution réellement originale, pertinente et différenciante.
Dans ce contexte, la créativité, l’exploration et l’apprentissage ne deviennent pas moins importants avec l’IA. À mesure que la production se banalise, ils pourraient au contraire devenir les principales sources de différenciation.
Autonomie d’exécution et autonomie de compréhension
L’enjeu n’est donc pas de renoncer à l’autonomie des agents, mais de distinguer l’autonomie d’exécution de l’autonomie de compréhension.
Nous pouvons souhaiter qu’un agent soit extrêmement autonome pour écrire du code, lancer des tests, refactorer, analyser une base de code ou réaliser des transformations mécaniques, tout en conservant des points de contact avec les humains dès qu’une décision suppose de produire du sens, de lever une ambiguïté métier ou de remettre en question une hypothèse du modèle.
Le principe même des boucles agentiques pourrait pourtant sembler remettre en cause cette nécessité. Une fois l’objectif, le contexte et les contraintes définis, plusieurs agents peuvent collaborer, produire une solution, l’évaluer, détecter des écarts, la corriger puis recommencer jusqu’à satisfaire les critères attendus. L’intervention humaine peut alors devenir très limitée.
Il existe bien, dans cette boucle, une forme d’apprentissage par itération : chaque résultat intermédiaire fournit de nouvelles informations permettant aux agents d’ajuster leur travail, d’explorer d’autres solutions et de converger progressivement vers une réponse plus satisfaisante.
Mais cet apprentissage doit être distingué de l’apprentissage humain du domaine.
Les agents peuvent parcourir des dizaines d’itérations, confronter plusieurs implémentations et améliorer progressivement leur réponse. Pourtant, si les humains restent à l’extérieur de cette boucle, les découvertes réalisées pendant ces itérations ne transforment pas nécessairement leur propre modèle mental du domaine.
Le paradoxe apparaît alors clairement : la boucle agentique peut progresser tandis que l’humain reste spectateur de cette progression.
Nous pouvons ainsi obtenir un logiciel de plus en plus pertinent sans nécessairement comprendre pourquoi il l’est devenu. Or, dans un domaine métier complexe, une partie essentielle de la valeur réside précisément dans cette compréhension : découvrir une nouvelle règle, identifier une abstraction plus juste, remettre en question une hypothèse ou faire émerger une représentation entièrement nouvelle du problème.
L’enjeu n’est donc pas simplement d’introduire un Human in the Loop chargé de valider ponctuellement le travail des agents. Il faut concevoir des boucles capables de ramener vers les humains les découvertes, les contradictions et les ambiguïtés susceptibles de transformer leur compréhension du domaine.
Autrement dit, il ne suffit pas que les agents améliorent leurs réponses au fil de leurs itérations. Leurs boucles doivent également devenir des boucles d’apprentissage pour les humains.
Nous pourrions presque en faire un principe du développement agentique :
Maximiser l’autonomie d’exécution des agents, sans supprimer les interactions qui produisent de la connaissance.
Lorsqu’une ambiguïté métier apparaît, la bonne réponse n’est donc pas nécessairement d’ajouter suffisamment de contexte pour permettre à l’agent de décider seul. Elle peut être, au contraire, de faire remonter cette ambiguïté dans la boucle d’apprentissage, afin qu’elle devienne une occasion de questionner le modèle avec les humains.
L’autonomie ne devrait donc pas se mesurer uniquement au temps pendant lequel un agent peut travailler sans nous solliciter. Elle devrait aussi se mesurer à sa capacité à reconnaître le moment où continuer seul ferait perdre une occasion d’apprendre.
Conclusion — Préserver ce qui nous permet d’apprendre
Le développement agentique transforme profondément notre rapport au logiciel. Lorsque le coût de génération diminue et que la vitesse d’exécution augmente, le code cesse progressivement d’être la principale contrainte du développement. Une part croissante de notre attention se déplace alors vers ce qui précède la génération : comprendre le problème, construire un modèle, expliciter les règles, organiser le contexte et formuler suffisamment précisément nos intentions pour permettre aux agents d’agir.
Ce déplacement constitue une formidable opportunité. Mais il porte également un risque : confondre une meilleure capacité à exprimer ce que nous savons avec une meilleure capacité à découvrir ce que nous ne savons pas encore.
Dans un domaine métier complexe, notre compréhension initiale reste nécessairement incomplète. Le Model-Driven Design nous rappelle que le modèle n’est pas une vérité qu’il suffirait ensuite d’implémenter. Il constitue une hypothèse que nous confrontons au logiciel, aux scénarios métier et aux experts afin de la faire évoluer. C’est précisément cette circulation entre modèle, implémentation, observation et apprentissage qui permet parfois de dépasser la solution attendue et de découvrir une représentation plus juste du problème.
L’enjeu du développement agentique n’est donc pas de préserver artificiellement l’acte de coder parce que nous l’avons longtemps pratiqué. Il est de préserver — et si possible d’accélérer — la boucle d’apprentissage dont le code était jusqu’ici l’un des instruments.
Cela conduit à reconsidérer ce que nous attendons réellement des agents. Leur autonomie ne devrait pas seulement se mesurer à la quantité de travail qu’ils peuvent accomplir sans intervention humaine. Elle devrait également se mesurer à leur capacité à participer à notre apprentissage : faire émerger une contradiction, signaler une ambiguïté, confronter plusieurs hypothèses, provoquer une discussion ou reconnaître qu’une décision nécessite de revenir vers les experts du domaine.
Autrement dit, nous ne devons pas seulement mettre l’humain dans la boucle ; nous devons mettre l’apprentissage dans la boucle.
La question n’est alors plus simplement :
Comment utiliser les agents pour produire plus vite ?
Elle devient :
Comment utiliser leur vitesse pour apprendre plus vite ce que nous devons réellement construire ?
C’est à cette condition que l’accélération offerte par l’agentique pourra devenir autre chose qu’une accélération de la production. Elle pourra devenir une accélération de la découverte.
La seconde partie explorera précisément cette voie : transformer la vitesse de génération des agents en boucles courtes d’expérimentation, d’observation et d’apprentissage, afin de passer progressivement du Time to Code au Time to Learn.