Le développement agentique est-il le fossoyeur de la modélisation métier ? - Part 2
Le développement agentique est-il le fossoyeur de la modélisation métier ? - Part 2
Transformer la vitesse des agents en capacité d’apprentissage
Dans la première partie, nous avons vu que le développement agentique ne remet pas seulement en question notre manière de produire du code : il transforme aussi la manière dont nous construisons notre compréhension du problème. En cherchant à fournir aux agents un contexte toujours plus complet afin d’accroître leur autonomie, nous risquons de transformer progressivement nos hypothèses en vérités à implémenter et de privilégier un feedback de conformité au détriment d’un feedback d’apprentissage.
Salvador Dali, La Persistance de la mémoire
Or, dans un domaine métier complexe, le modèle ne peut pas être entièrement défini en amont. Il se construit par itérations, à travers la confrontation entre les hypothèses, le modèle, l’implémentation, l’observation et les échanges avec les experts métier. Le véritable enjeu n’est donc plus seulement d’utiliser les agents pour réduire le Time to Code, mais de mettre leur vitesse au service d’une boucle capable de réduire le Time to Learn.
Cette seconde partie explore comment organiser le développement agentique autour d’une ambition centrale : générer moins pour apprendre davantage. Il s’agit de tirer parti de l’IA pour consacrer moins de temps à la production de code et davantage à la compréhension du domaine métier, tout en maintenant les humains au cœur de la boucle d’apprentissage. Dans cette perspective, les spécifications évoluent progressivement pour devenir une mémoire vivante et structurée des connaissances acquises par l’équipe, enrichie au fil des expérimentations, des observations et des découvertes sur le domaine.
5. Du mini-waterfall à la Micro-Learning Loop
La vitesse des agents peut pourtant transformer radicalement cette dynamique.
La vitesse des agents élargit le champ des possibles
Un agent capable de produire en quelques minutes une première incarnation de ce qui nécessitait auparavant plusieurs jours réduit considérablement le coût de l’expérimentation. Une hypothèse peut désormais être rendue concrète presque immédiatement, puis confrontée au regard des experts métier.
Nous pouvons alors adopter une stratégie différente.
Au lieu de rechercher :
- Plus de contexte → Plus d’autonomie → Plus de code
nous pouvons rechercher :
- Une hypothèse → Juste assez de contexte → Une incarnation → Du feedback → Une meilleure hypothèse
La différence est fondamentale. Dans le premier cas, nous cherchons à maximiser la quantité de travail que l’agent peut accomplir avant de revenir vers les humains. Dans le second, nous cherchons à minimiser le temps nécessaire pour apprendre quelque chose de significatif sur le problème.
Le contexte n’a alors plus besoin d’être exhaustif avant de commencer. Il doit simplement être suffisamment riche pour permettre la prochaine expérience utile.
La vitesse de génération prend ainsi une tout autre valeur. Elle ne sert plus seulement à produire plus rapidement : elle permet d’expérimenter plus souvent.
Accélérer le passage de l’hypothèse à l’apprentissage
Une hypothèse issue du modèle peut être incarnée presque immédiatement dans un prototype. Les experts métier peuvent alors l’observer, le manipuler, le confronter à des situations concrètes et, surtout, réagir à quelque chose qui existe plutôt qu’à une représentation abstraite de ce qui pourrait exister. Cette confrontation peut révéler une règle implicite, une incohérence, une mauvaise abstraction ou faire émerger une possibilité que personne n’avait encore envisagée.
Ces découvertes enrichissent à leur tour le modèle et le contexte. L’agent peut alors produire une nouvelle incarnation quelques minutes ou quelques heures plus tard, provoquant une nouvelle confrontation et de nouveaux apprentissages.
La vitesse des agents ne réduit donc plus seulement le temps qui sépare une spécification de son implémentation. Elle réduit le temps qui sépare une hypothèse de ce que sa mise à l’épreuve nous permet d’apprendre.
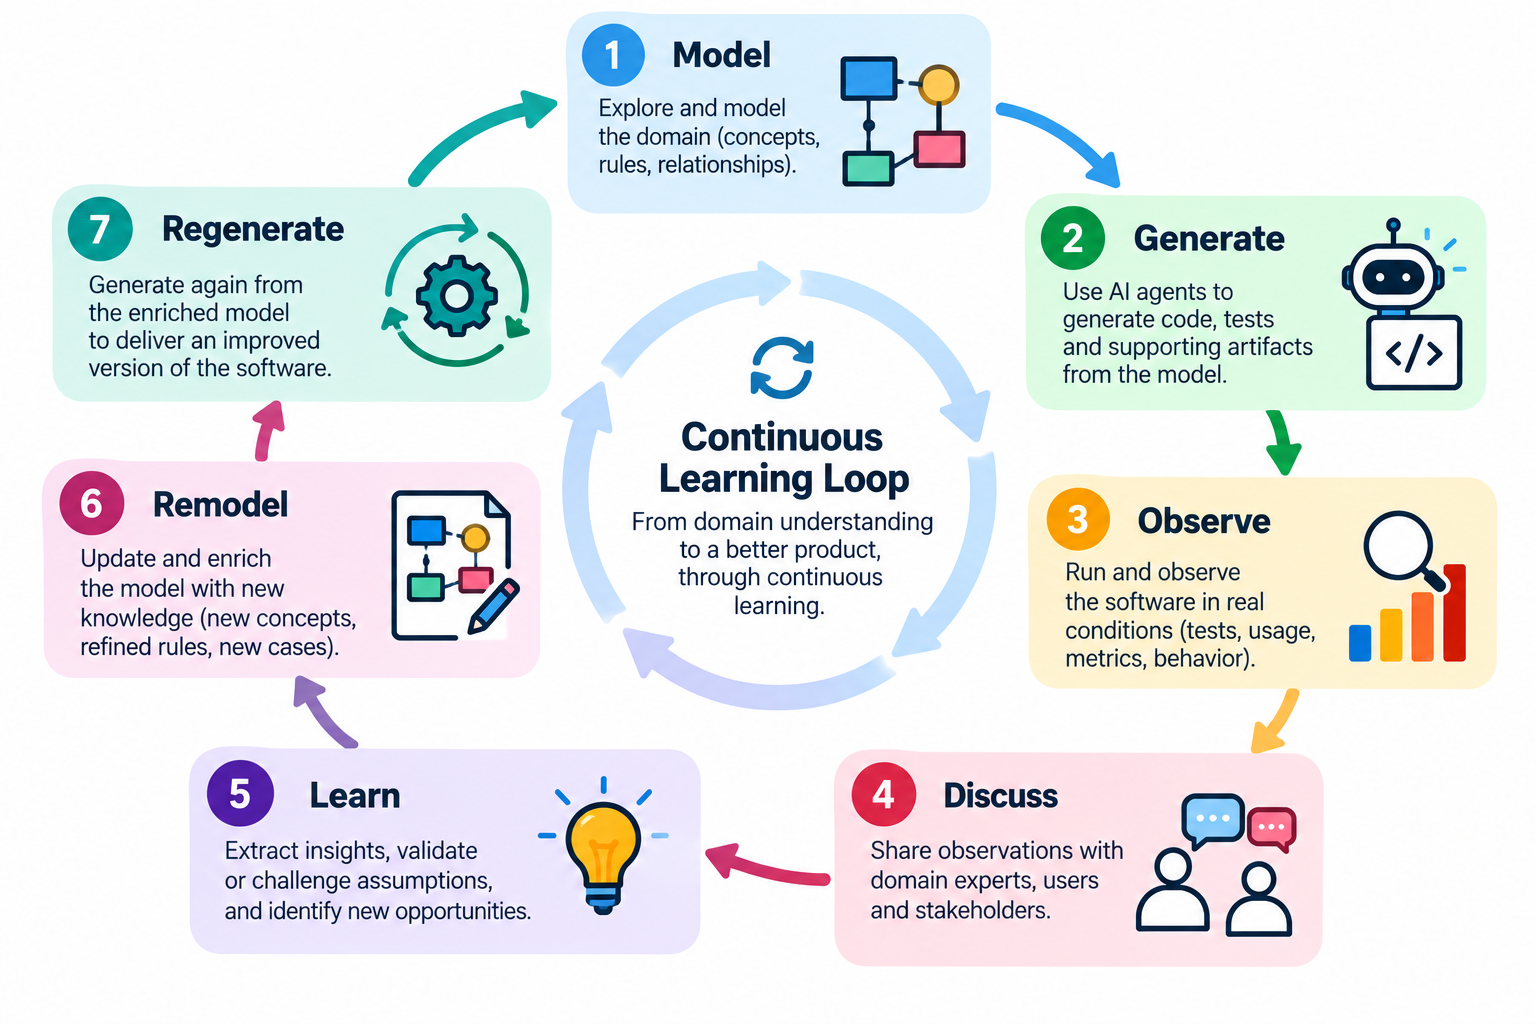
Modéliser → Générer → Observer → Discuter → Apprendre → Remodeler → Régénérer ↺
L’IA ne remplace alors pas la boucle de modélisation. Elle la compresse.
Deux manières d’utiliser la vitesse des agents
C’est probablement ici que se situe l’un des choix les plus importants dans la manière d’organiser le développement agentique : que voulons-nous réellement accélérer ?
Nous pouvons utiliser les agents pour accélérer une logique essentiellement séquentielle :
- Spécifier → Générer → Vérifier
Chaque incrément devient extrêmement rapide, mais la connaissance continue principalement à circuler de la spécification vers l’implémentation. Nous obtenons une succession de mini-waterfalls, certes beaucoup plus courts, mais toujours orientés vers l’exécution d’une connaissance supposée acquise.
La vitesse des agents sert alors principalement à réduire le temps de production.
Mais nous pouvons exploiter exactement la même vitesse pour raccourcir radicalement la boucle de découverte :
- Hypothèse → Modéliser → Générer → Observer → Apprendre → Nouvelle hypothèse ↺
La génération rapide permet alors de confronter presque immédiatement une hypothèse à une incarnation concrète. Ce que nous observons nourrit les échanges avec les experts métier, transforme notre compréhension du problème et produit une nouvelle hypothèse qui peut, à son tour, être rapidement expérimentée.
Nous obtenons ainsi des Micro-Learning Loops : de petites boucles dans lesquelles une quantité limitée de connaissance est formalisée, rapidement incarnée dans le logiciel, confrontée à la réalité du métier, puis enrichie par ce que cette confrontation nous apprend.
La différence entre les deux approches tient finalement à ce que nous cherchons à optimiser :
- Mini-waterfall agentique → réduire le temps nécessaire pour produire.
- Micro-Learning Loop → réduire le temps nécessaire pour apprendre.
Dans les deux cas, les agents vont vite. Mais dans le second, leur vitesse devient un accélérateur de compréhension du domaine.
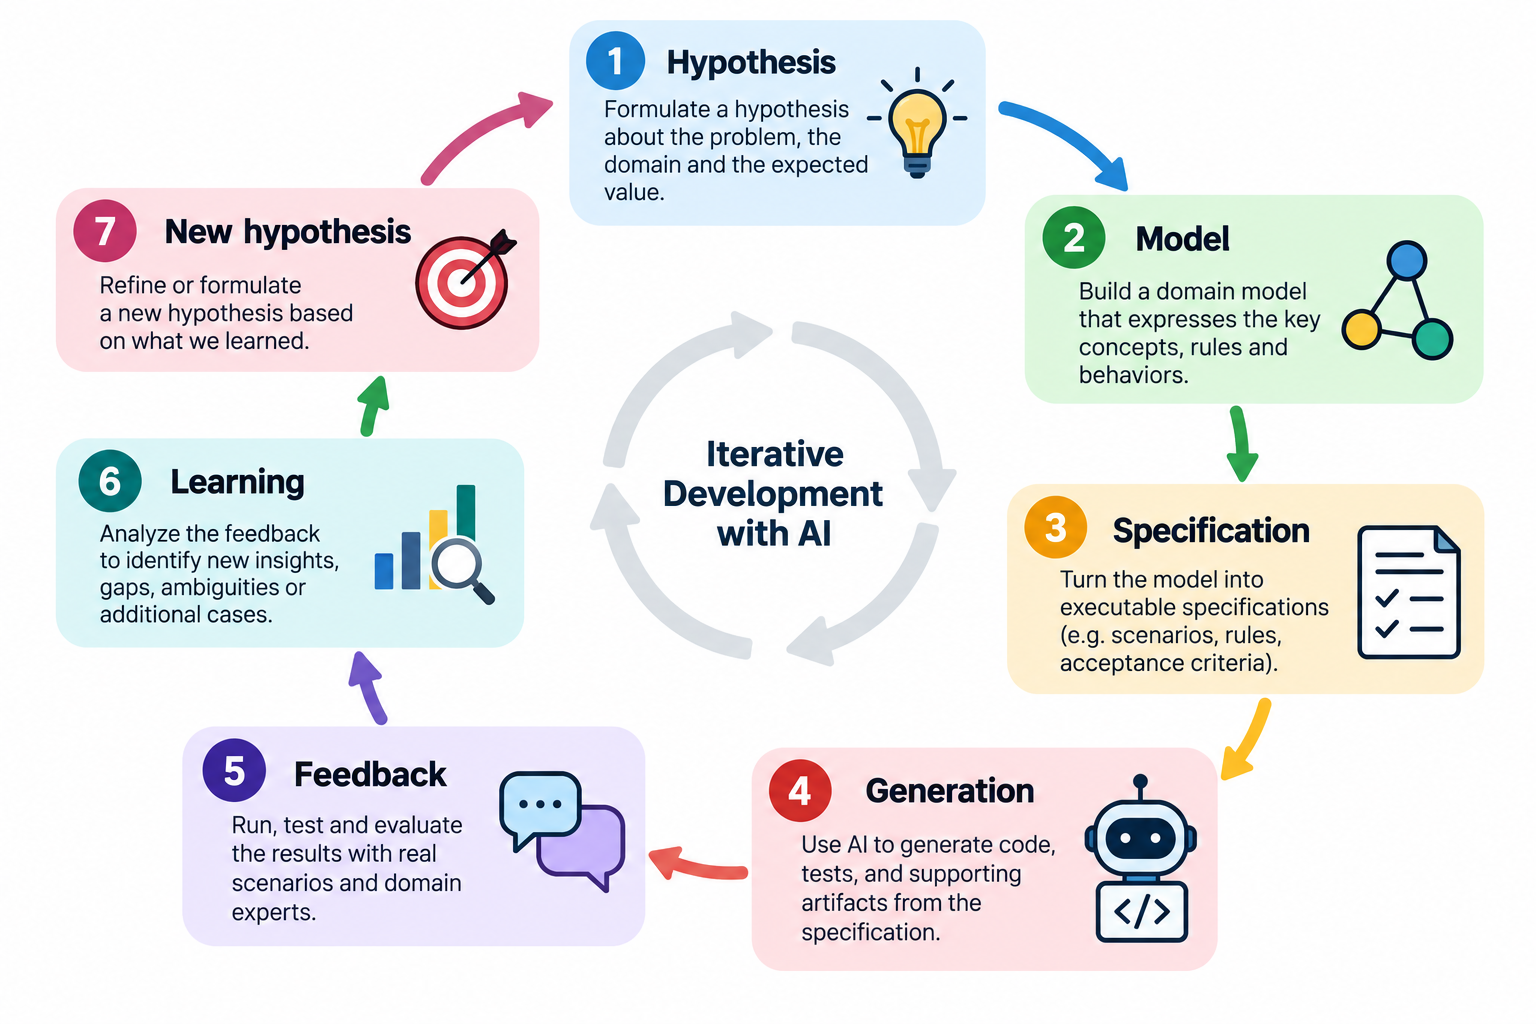
Micro-Learning Loops
Chaque itération produit alors deux résultats : une nouvelle version du logiciel et une meilleure compréhension de ce qu’il faut réellement construire.
La différence entre les deux approches est fondamentale. Le mini-waterfall agentique cherche principalement à réduire le coût et le temps nécessaires pour transformer une connaissance existante en logiciel. La Micro-Learning Loop cherche également à réduire le coût et le temps nécessaires pour produire de nouvelles connaissances sur le problème à résoudre.
Si les agents rendent progressivement la production de code plus rapide, plus accessible et moins coûteuse, cette seconde capacité pourrait devenir déterminante. Lorsque produire devient facile, la valeur se déplace vers notre capacité à apprendre rapidement ce qu’il est réellement pertinent de produire.
L’enjeu du développement agentique ne serait alors plus seulement d’optimiser le Time to Code, mais de réduire le Time to Learn.
6. Du Time to Code au Time to Learn
Ce changement de perspective nous conduit naturellement à reconsidérer ce que nous cherchons réellement à optimiser avec le développement agentique.
Temps pour transformer une intention métier en une implémentation
Une grande partie des gains attendus de l’IA est aujourd’hui exprimée en Time to Code ou en Time to Delivery : combien de temps faut-il pour transformer une intention en implémentation, puis pour mettre une nouvelle fonctionnalité entre les mains des utilisateurs ?
Ces mesures restent importantes, mais elles ne racontent qu’une partie de l’histoire lorsque nous travaillons sur des domaines métiers complexes. Produire plus rapidement ne garantit ni que nous comprenions mieux le problème, ni que nous construisions le bon logiciel.
Une autre variable devient alors essentielle : le Time to Learn.
Le Time to Learn peut être défini comme le temps qui s’écoule entre la formulation explicite d’une hypothèse et l’obtention d’un apprentissage suffisamment significatif pour confirmer, infirmer ou faire évoluer cette hypothèse.
Son point de départ doit être identifiable : une question métier, une règle supposée, une hypothèse sur le comportement d’un utilisateur, un choix de modèle ou une décision de conception que nous souhaitons éprouver.
Son point d’arrivée ne correspond pas simplement au moment où le code est produit, ni même à celui où le prototype est disponible. Il correspond au moment où le feedback obtenu permet effectivement de modifier notre état de connaissance : confirmer une hypothèse avec suffisamment de confiance, la réfuter, la préciser, faire émerger une nouvelle règle, reconsidérer un concept ou prendre une décision qui n’était pas possible auparavant.
Le Time to Learn devient ainsi une mesure de la vitesse de la boucle d’apprentissage :
- Hypothèse → Expérimentation → Feedback → Apprentissage
Avec les agents, l’enjeu n’est donc plus seulement de réduire le temps nécessaire pour produire une expérimentation. Il est de réduire l’ensemble du temps qui sépare une question de la connaissance nouvelle permettant d’avancer.
Car une implémentation produite en cinq minutes mais qui attend trois jours avant d’être confrontée à un expert métier ne produit pas un Time to Learn de cinq minutes.
Au-delà du Time to Learn : apprendre mieux, pas seulement plus vite
Accélérer le code n’accélère l’apprentissage que si toute la boucle d’apprentissage est accélérée.
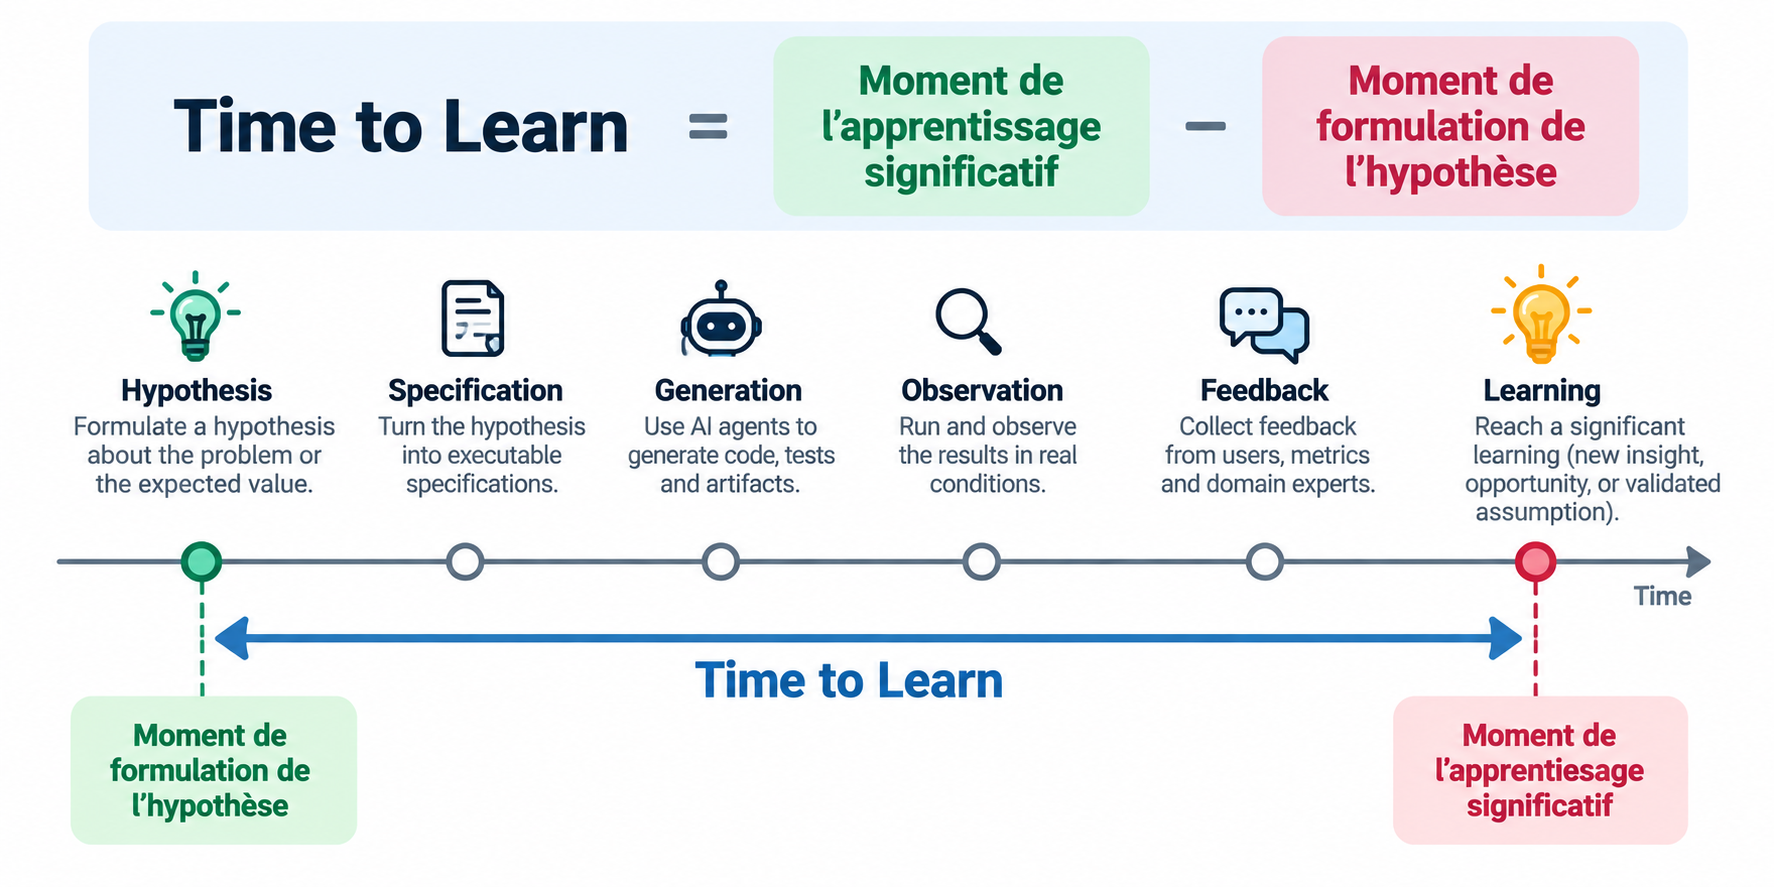
Time to Learn = Moment de l’apprentissage significatif − Moment de formulation de l’hypothèse
Cette distinction est importante, car obtenir du feedback ne signifie pas nécessairement apprendre. Une validation indiquant simplement que l’implémentation correspond à la spécification constitue avant tout un feedback de conformité.
Pour fermer véritablement la boucle d’apprentissage, le feedback doit modifier notre état de connaissance : confirmer une hypothèse encore incertaine, en invalider une, préciser notre compréhension ou faire émerger une nouvelle question susceptible de modifier la suite du travail.
Clarifions avec un exemple concret
Prenons une équipe qui formule lundi matin l’hypothèse suivante :
- « Un client fidèle est un client actif depuis plus de trois ans. »
Cette hypothèse est intégrée à la spécification et un agent en produit rapidement une première incarnation.
Présentée aux experts métier quelques heures plus tard, celle-ci révèle que l’ancienneté ne suffit pas : le nombre d’achats réalisés au cours des douze derniers mois doit également être pris en compte.
L’équipe vient d’apprendre quelque chose qui modifie sa compréhension du domaine. Son Time to Learn est de quelques heures.
Imaginons maintenant une seconde organisation. La même hypothèse est spécifiée et implémentée tout aussi rapidement, mais le résultat n’est confronté aux experts métier que lors d’une démonstration organisée deux semaines plus tard.
Dans les deux organisations, le Time to Code est pratiquement identique.
Le Time to Learn, lui, passe de quelques heures à deux semaines. La vitesse de génération n’est donc qu’une composante de la vitesse d’apprentissage. Le Time to Learn mesure la durée nécessaire pour parcourir une Micro-Learning Loop complète :
- Hypothèse → Spécification → Génération → Observation → Feedback → Apprentissage
Réduire le Time to Learn consiste à raccourcir cette boucle afin de confronter plus rapidement nos hypothèses à une incarnation concrète et d’en tirer un apprentissage actionnable.
Un agent peut donc produire du code dix fois plus vite, mais si nous devons toujours attendre plusieurs semaines avant de découvrir qu’une hypothèse métier était incorrecte, nous n’avons accéléré qu’une partie du système. Nous avons réduit le Time to Code, mais pas nécessairement le Time to Learn.
À l’inverse, si la vitesse de génération nous permet de confronter une hypothèse à une incarnation concrète quelques heures seulement après sa formulation, puis d’obtenir rapidement le regard des experts métier ou des utilisateurs, la valeur de l’IA change de nature.
Elle ne sert plus seulement à produire plus vite. Elle permet de réduire le coût de l’expérimentation, d’apprendre plus tôt et de multiplier les occasions d’apprentissage.
L’enjeu n’est donc pas d’opposer Time to Code, Time to Delivery et Time to Learn. Réduire les deux premiers peut précisément contribuer à réduire le troisième, à condition que le temps gagné sur la production soit réinvesti dans des boucles de feedback plus courtes, plutôt que dans la seule accumulation de nouvelles fonctionnalités.
Dans cette perspective, la meilleure organisation agentique n’est pas nécessairement celle qui maximise l’autonomie des agents ou la quantité de code qu’ils peuvent produire sans intervention humaine.
C’est celle qui minimise le temps entre la formulation d’une hypothèse et l’apprentissage significatif qui permet de la confirmer, de la préciser, de la transformer ou de l’abandonner.
La performance d’une organisation agentique pourrait alors se mesurer selon deux dimensions complémentaires : la vitesse à laquelle elle transforme une connaissance en logiciel, et la vitesse à laquelle ce logiciel lui permet de produire une nouvelle connaissance.
Autrement dit, après avoir longtemps cherché à réduire le Time to Code et le Time to Delivery, le développement agentique nous donne peut-être l’occasion d’optimiser une variable encore plus fondamentale : le Time to Learn.
7. Du Time to Learn au Learning per Token
Aller audelas du Time to Learn
Le Time to Learn introduit une première évolution dans notre manière de mesurer la performance du développement agentique : il ne s’agit plus seulement de savoir à quelle vitesse nous produisons du logiciel, mais à quelle vitesse ce logiciel nous permet d’apprendre.
Mais si les capacités de calcul, l’énergie et les ressources nécessaires aux agents deviennent elles-mêmes des ressources à arbitrer, une seconde question apparaît naturellement :
Combien de ressources IA devons-nous mobiliser pour produire un apprentissage réellement utile ?
- Nous pourrions appeler cette notion Learning per Token.
L’objectif ne serait évidemment pas de considérer chaque token comme une unité homogène de calcul ou d’impact environnemental. Le token constitue ici avant tout une approximation simple de la ressource consommée par l’activité agentique. Selon les besoins, cette mesure pourrait être complétée par le coût financier, le temps de calcul ou, lorsque les données sont disponibles, la consommation énergétique.
L’idée fondamentale reste cependant la même : tous les tokens consommés ne produisent pas la même valeur.
L’excellence agentique et frugalité
Un million de tokens mobilisés pour générer davantage de code à partir d’un problème déjà parfaitement compris peut apporter relativement peu de connaissance nouvelle. Les mêmes ressources consacrées à explorer plusieurs modèles, générer différents prototypes, rechercher des contre-exemples ou confronter une hypothèse aux experts métier peuvent au contraire provoquer un apprentissage déterminant.
Nous pourrions alors considérer deux dimensions complémentaires :
- Time to Learn → Combien de temps nous faut-il pour apprendre quelque chose de significatif ?
- Learning per Token → Quelle quantité de ressources IA devons-nous mobiliser pour obtenir cet apprentissage ?
Une Micro-Learning Loop ne serait donc plus seulement évaluée par sa durée, mais également par son rendement d’apprentissage.
- Hypothèse → Expérience → Feedback → Apprentissage
↳ Temps consommé : Time to Learn
↳ Ressources IA consommées : coût de la boucle
↳ Valeur obtenue : apprentissage actionnable
Cette perspective pourrait modifier profondément notre manière d’orchestrer les agents. L’objectif ne serait plus nécessairement de les faire travailler continuellement jusqu’à épuiser toutes les possibilités, mais de déterminer où une itération supplémentaire a encore une chance raisonnable de produire une connaissance nouvelle.
Un agent qui génère dix variantes presque identiques n’est pas nécessairement plus utile qu’un agent qui, après deux itérations, identifie une ambiguïté fondamentale et la fait remonter aux experts métier.
La performance d’une Learning Factory pourrait ainsi être observée selon deux axes :
- apprendre le plus tôt possible — Time to Learn ;
- apprendre avec le moins de ressources nécessaires — Learning per Token.
Nous passerions alors progressivement d’une logique cherchant à maximiser la production par unité de calcul à une logique cherchant à maximiser l’apprentissage utile par unité de ressource mobilisée.
Cette évolution est importante, car elle réintroduit une notion souvent absente des promesses d’automatisation : la sobriété.
La meilleure organisation agentique ne serait pas nécessairement celle qui mobilise le plus d’agents, génère le plus de code ou consomme le plus de tokens. Elle pourrait être celle qui sait utiliser ses capacités d’IA au moment où elles produisent le plus de connaissance et arrêter d’itérer lorsque le rendement d’apprentissage devient marginal.
Ainsi, après avoir cherché pendant des décennies à augmenter notre capacité à produire du logiciel, nous pourrions entrer dans une période où deux nouvelles questions deviennent centrales :
- À quelle vitesse apprenons-nous ?
et
- Combien de ressources devons-nous consommer pour apprendre ?
Le véritable enjeu d’une Learning Factory serait alors de trouver le meilleur équilibre entre vitesse d’apprentissage, valeur de l’apprentissage et ressources mobilisées.
Frank van Hulst - unsplash
Le véritable enjeu ne serait donc plus de maximiser la quantité de code produite par les agents, ni même de minimiser uniquement le temps nécessaire pour produire ce code. Il serait de trouver le meilleur équilibre entre vitesse d’apprentissage, valeur de l’apprentissage et ressources mobilisées.
Le Time to Learn nous indique à quelle vitesse une organisation transforme une hypothèse en connaissance. Le Learning per Token nous invite à nous demander avec quelle efficacité elle mobilise ses ressources d’IA pour produire cette connaissance.
Ces deux perspectives convergent finalement vers une même idée : si produire du logiciel devient progressivement plus rapide et moins coûteux, l’enjeu se déplace de notre capacité à produire vers notre capacité à apprendre ce qu’il est pertinent de produire.
C’est précisément ce déplacement qui pourrait nous conduire à repenser l’AI Software Factory comme une Learning Factory.
8. De l’AI Software Factory à la Learning Factory
Le développement agentique bouleverse profondément l’économie de la production logicielle. Ce qui nécessitait hier plusieurs jours peut parfois être généré, testé et refactoré en quelques heures, voire quelques minutes. À mesure que cette capacité progresse, produire du code devient progressivement moins coûteux et moins différenciant.
Préserver la compréhension profonde
Mais dans les domaines métier complexes, le code n’a jamais été seulement un livrable. Il constitue aussi un instrument de raisonnement : nous implémentons pour éprouver un modèle, révéler ses limites, faire émerger de nouvelles questions et approfondir notre compréhension du métier.
C’est précisément cette fonction qu’il faut préserver dans le développement agentique.
Car nous pourrions utiliser la puissance des agents pour construire une succession de mini-waterfalls extrêmement rapides :
- Spécifier → Générer → Vérifier
Nous produisions alors beaucoup plus vite des logiciels conformes à ce que nous pensions devoir construire.
Mais nous pouvons aussi utiliser cette même puissance pour multiplier les Micro-Learning Loops :
- Hypothèse → Expérience → Feedback → Apprentissage → Nouvelle hypothèse ↺
L’agentique peut accélérer la boucle de modélisation
La vitesse des agents change alors de fonction. Elle ne sert plus seulement à raccourcir le temps entre une spécification et son implémentation. Elle raccourcit le temps entre une hypothèse et ce que sa confrontation à une incarnation concrète nous permet d’apprendre.
L’IA ne remplace alors pas la boucle de modélisation. Elle la compresse.
Cette perspective modifie également ce que nous cherchons à mesurer. Le Time to Code et le Time to Delivery restent importants, mais ils ne suffisent plus. Une troisième métrique devient essentielle : le Time to Learn, c’est-à-dire le temps nécessaire pour transformer une hypothèse en un apprentissage suffisamment significatif pour la confirmer, la remettre en question ou la faire évoluer.
La performance d’une organisation agentique ne devrait donc peut-être plus se mesurer uniquement à la quantité de travail que ses agents peuvent accomplir sans intervention humaine. Elle devrait aussi se mesurer à la vitesse avec laquelle les humains et les agents parviennent ensemble à améliorer leur compréhension du problème.
Cela conduit à reconsidérer également la notion d’autonomie. Nous voulons des agents extrêmement autonomes lorsqu’il s’agit d’écrire du code, lancer des tests, refactorer ou explorer des solutions. Mais l’agent le plus utile n’est pas nécessairement celui qui ne pose jamais de questions. Dans un domaine complexe, il peut être celui qui sait reconnaître qu’une ambiguïté n’est plus un problème d’exécution à résoudre seul, mais une occasion d’apprentissage à faire remonter aux humains.
Construire une approche responsable de l’agentique
À cette recherche de vitesse s’ajoute enfin une autre contrainte : les ressources mobilisées par l’IA ne sont pas nécessairement illimitées. Calcul, énergie, coûts et impacts environnementaux pourraient progressivement nous conduire à arbitrer plus finement l’usage des agents.
La question ne serait alors plus seulement :
- « À quelle vitesse pouvons-nous apprendre ? »
mais également :
- « Combien de ressources devons-nous mobiliser pour produire cet apprentissage ? »
Le Time to Learn pourrait ainsi être complété par une notion de Learning per Token : non pas considérer naïvement le token comme une unité d’énergie, mais chercher à comprendre quelle quantité de connaissance utile nous produisons au regard des ressources d’IA mobilisées.
Cette perspective introduit une forme de sobriété dans le développement agentique. La meilleure organisation ne serait pas nécessairement celle qui mobilise le plus d’agents, génère le plus de code ou consomme le plus de tokens, mais celle qui sait mobiliser l’IA là où elle produit le plus de valeur et le plus d’apprentissage.
C’est peut-être là que se situe le véritable changement de paradigme.
Une AI Software Factory optimise notre capacité à transformer efficacement ce que nous savons déjà en logiciel.
Une Learning Factory optimise votre capacité à utiliser le logiciel, les agents et les interactions humaines pour découvrir rapidement ce que nous ne savons pas encore.
Lorsque produire devient facile, apprendre ce qu’il est réellement pertinent de produire devient la compétence déterminante.
À l’ère du développement agentique, l’avantage ne viendra peut-être plus seulement de notre capacité à coder plus vite que les autres, mais de notre capacité à apprendre plus vite qu’eux — tout en mobilisant nos ressources avec discernement.
Pour certains, ce déplacement du Time to Code vers le Time to Learn constitue un changement radical dans notre manière de concevoir et de développer des produits. Pourtant, il ne représente probablement qu’une première étape.
Nous ne sommes qu’au début du chemin.