Le Context Engineering pour les Product people
Oui le titre prête à sourire. Encore des anglicismes… Mais avouons-le, difficile d’y échapper quand on veut parler Produit et IA aujourd’hui. Et puis, avouez que “L'ingénierie du contexte pour les rôles produit” c’est tout de suite moins parlant et moins sexy…
Alors pourquoi cet article ? Parce que le context engineering est devenu une notion clé de l’IA, souvent présentée avec un vocabulaire très “tech” alors qu’elle repose avant tout sur des principes simples et ne concerne pas que les rôles techniques. En tant que PM j’ai réalisé que mon rôle était tout aussi important pour créer des réponses à la fois qualitative et responsable, et c’est ce que je souhaite partager ici.
L’objectif est donc de remettre l’église au milieu du village “Produit” en espérant que l’initiative serve un plus grand nombre : comprendre jusqu’où l’on peut — et doit — aller pour maximiser notre impact, mieux comprendre ce qui a réellement de la valeur dans nos interactions avec l’IA et nous responsabiliser dans notre manière de l’utiliser.
Avant d’aller plus loin - nous nous accorderons ici sur une mise en garde : cet article ne prétend pas à l’exhaustivité du sujet et n’a aucune vocation à la postérité. Soyons humbles, il est même fort probable qu’une partie soit périmée d’ici quelques … semaines, mois tout au mieux. Oui, mais l’intention ici est moins de partager des tips qu’une logique, assez cruciale pour utiliser l’IA : celui du bon sens et de la responsabilité ; et cet état d’esprit - lui, doit s’ancrer dans la durée.
Mais, qu’est-ce que le Context Engineering ?
Trève de galéjade, de quoi parle-t-on concrètement ? Si l’on s’en réfère à la définition d’Anthropic - il s’agit de :
“Toutes les stratégies de sélection et de maintenance de l'ensemble optimal de tokens (informations) lors de l'inférence LLM, incluant toutes les autres informations susceptibles d'y figurer en dehors des prompts”
Anthropic
J’en conviens ce n'est pas des plus limpides … Comprenez qu’il s’agit de toutes les façons d’optimiser l’information qui sera utilisée par votre modèle IA dès qu’il tournera, indépendamment du prompt lui-même (travaillé via le prompt engineering - branche cousine du context engineering, mais que nous aborderons tout de même à la marge dans cet article).
Le token, l’unité de valeur de l’IA
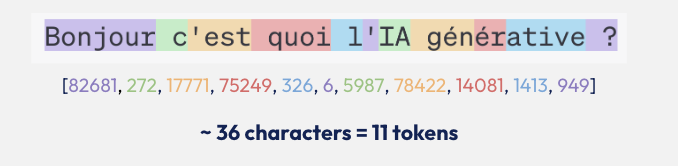
Il faut ici bien comprendre que ce que nous entendons par “information”, le modèle de GenAI le traduit sous forme de “token”.
Procédons ici à un petit rappel car cette notion est essentielle pour comprendre le context engineering. Le fonctionnement de la GenAi est de découper ce qu’on lui transmet en tokens, qui désignent la plus petite unité de texte (incluant la ponctuation, numéros, etc.) des informations partagées avec votre modèle IA préféré.
Pour vous répondre, le modèle va simplement calculer l'enchaînement des tokens par voie de probabilité. Chaque token est calculé comme étant le plus probable après le token qui le précède. Le principe est le même pour les autres contenus échangés - tout est transformé en tokens qui sont en quelque sorte **l’unité de valeur de l’**IA. Et c’est cette unité qui est comptabilisée pour évaluer votre consommation.
La fenêtre de contexte : tout ce que l’IA a sous les yeux
Maintenant poussons un cran plus loin : aujourd’hui quand on parle de consommation de tokens on parle aussi bien des tokens en input (entrée) - comprendre tous les éléments qui alimentent le modèle ; qu’en output (sortie) -ceux que le modèle produit lui-même en réponse, c’est bien cet ensemble de tokens en input et en output qui sera comptabilisé pour chacune de vos sessions par le provider IA que vous utilisez et non juste ce que vous tapez.
Plus précisément du côté de l’input nous allons retrouver ce que l’on appelle la fenêtre de contexte, qui rassemble :
- A minima le prompt de la fenêtre de chat et l’historique de votre conversation en cours mais aussi selon vos usages …
- Le prompt système, les documents partagés de votre Assistant (ex: les Projets Claude, chat GPT ou Perplexity) et l’accès ponctuel à d’autres conversations que vous auriez eu avec cet assistant.
- Pour les agents - tous les fichiers d'instruction et de mémoire lus par défaut avant même de démarrer la moindre conversation. Puis tous les fichiers qui seront consultés au cours de votre session.
Du côté de l’output, nous retrouverons simplement les réponses produites par le modèle au cours de votre échange ainsi que tous les éléments produits : fichiers, images, vidéos, etc.
Il y a donc une part de contexte invisible qu’il va falloir apprendre à gérer.
Pourquoi est-ce important de gérer son contexte ?
Et pourquoi tout le monde a les yeux rivés sur sa consommation de tokens ?
D’abord pour des raisons évidentes de coûts…
Les tokens forment un volume important de données que les modèles doivent digérer. Or, plus il y en a, plus les modèles tournent et nécessitent des capacités de calcul importantes, raison pour laquelle les providers de GenAI (Open AI ; Anthropic ; Google; Mistral ; Meta, etc.) ont défini le token comme unité de coût de leur business model.
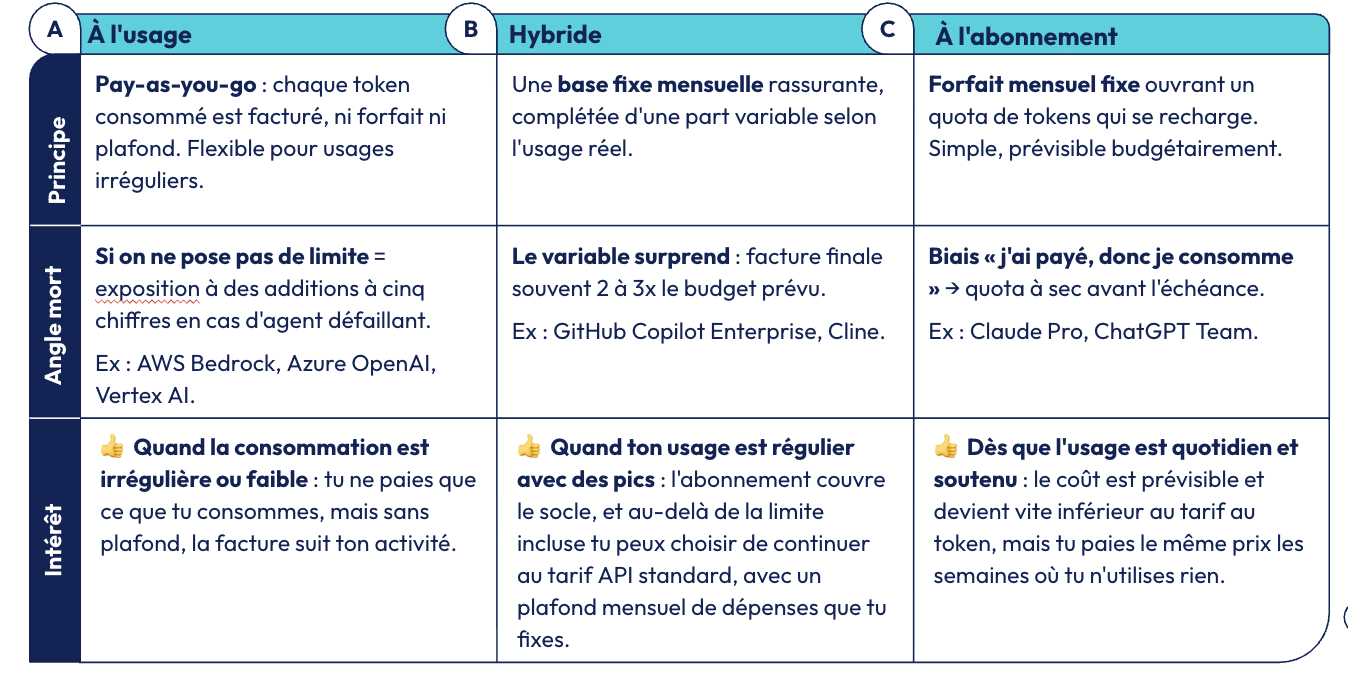
Vous pourrez ainsi trouver sur le marché 3 types de facturation :
Avec le mouvement mondial d’adoption de l’IA, vous imaginez la puissance de calcul qui est nécessaire pour soutenir et accompagner cette croissance. D’ailleurs, selon une étude de Goldman Sachs Research (mai 2026),
“l'IA agentique devrait multiplier par 24 la consommation de tokens d'ici 2030, à mesure que les consommateurs et les entreprises adopteront cette technologie”.
Notons également que le business model des providers se cherche entre rentabilité et adoption et qu’aujourd’hui, avec l’arrivée des systèmes agentiques, on assiste à une migration vers des tarifications à l’usage (au détriment des licences) - bcp moins avantageux pour les organisations qui ne peuvent plus aussi facilement anticiper leurs budgets.
Sortez les billets !
… Ensuite pour des raisons de performance…
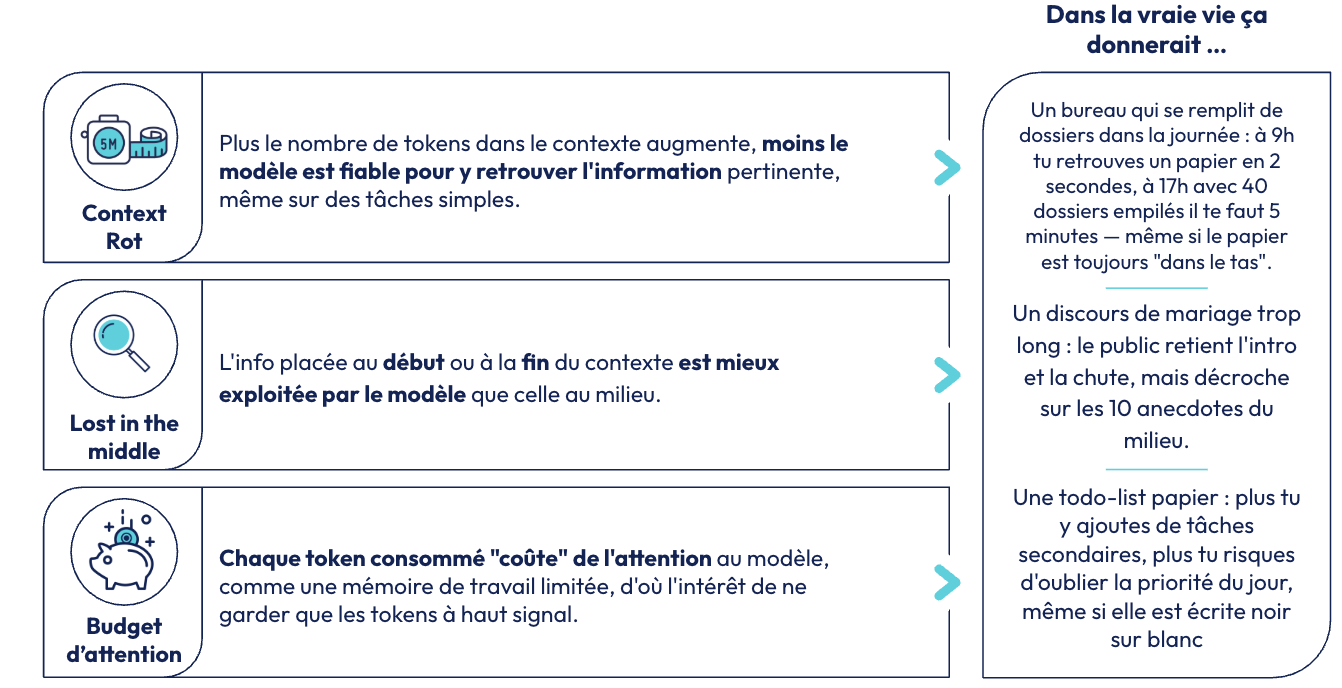
Soyons honnête, avec la course à l'échalote que se livrent les Providers IA qui élargissent sans cesse la taille de la fenêtre de contexte de leur modèle (plus de 1M de tokens pour les plus gros modèles à l’heure où j’écris ces lignes), ce point est sans doute moins prégnant qu’il y a quelques mois. Mais gardons en tête l’essentiel : plus vous donnez d’informations à un modèle, plus son travail d’analyse s'accroît ce qui peut engendrer 2 types de problèmes :
- Un problème de qualité dans les réponses fournies, votre modèle s’est tout simplement noyé dans la multitude d’informations que vous lui avez fournie. A partir de là, c'est la porte ouverte - au mieux, aux réponses médiocres, - au pire, aux hallucinations. Vous perdez du temps à rectifier le tir.
- Un problème de délais : plus il y a de choses à analyser ou à faire, plus la demande est complexe, plus la réponse peut prendre du temps.
Quelques illustrations ici :
…Enfin pour l’impact environnemental associé à votre usage.
Nous savons tous aujourd’hui que l’usage de l’IA a un impact non négligeable sur notre environnement ; bien plus important que l’usage d’internet, les chiffres évoluent sans cesse du fait de l’évolution de la technologie mais aussi au gré des méthodologies utilisées et de l’indépendance des auteurs qui produisent ces chiffres… j’ai souhaité donné quelques chiffres ici mais je vous invite à consulter les liens en bas de cet article pour creuser le sujet :
- En termes d'électricité : En 2025, selon une étude du laboratoire IA de l’université du Rhode Island, une réponse moyenne sur GPT-5 consomme 18 à 40 Wh - l’équivalent de 30 à 45 minutes de chargement d’un ordinateur portable)
- En termes d’Eau : en 2025, Mistral a démontré - en s’appuyant sur des instituts indépendants, qu’une réponse type de 400 tokens (~1 page) via l'assistant "Le Chat" de Mistral consomme 45 ml d'eau - soit l'équivalent de l'eau nécessaire à la pousse d'un petit radis.
Ce qui est intéressant ici c’est de projeter ces consommations à l’aune de la massification des usages de l’IA : avec les 900 millions d'utilisateurs hebdomadaires et les 2,5 milliards de requêtes par jour rien que sur ChatGPT — sans compter Gemini, Claude, Le Chat, Copilot etc. — l'addition change d'échelle.
Sans compter que la baisse du coût unitaire par requête -du fait d’éventuels progrès futurs, n'empêchera pas l'empreinte totale de grimper avec l'explosion des usages (c’est le principe du paradoxe de Jevons, plus c’est économique, plus on en consomme).
A notre échelle cela veut dire quoi ?
- Aujourd'hui l**’IA coûte bien plus cher à produire que ce que l’on nous facture sur abonnement**.
- Ces tarifications sont basses pour favoriser l’adoption (et garantir la rétention future) de l’outil … C’est un mécanisme classique de “penetration pricing”, une fois ancré dans nos usages, les Providers pourront augmenter leurs prix avec un risque minime de perte d’utilisateurs, devenus …dépendants.
- Les providers IA se financent dès lors via leurs levées de fonds qui comblent aujourd'hui l’écart. C’est pour cela qu’on parle d’une bulle spéculative de l’IA générative.
- Notons que les externalités environnementales sont à ce stade portées par les collectivités, (CO2, eau, métaux rares) c’est un peu comme un billet d’avion sans taxe carbone : quelqu’un d’autre paiera l’addition mais pas l'utilisateur final à date.
- En tant que Rôles Produit, mieux gérer son contexte est une manière de rationnaliser sa consommation et son impact : faire mieux avec moins.
Comment sait-on que l’on fait face à une dégradation de contexte ?
Plusieurs éléments peuvent vous mettre sur la piste :
- Le modèle repose une question déjà tranchée plus tôt dans la session, ou reformule une décision que vous pensiez actée.
- Il ignore une instruction donnée en début de session (dans le prompte system , un CLAUDE.md, par exemple avec une contrainte de format) alors qu'il la respectait au tour précédent.
- Les réponses deviennent plus génériques / moins précises à mesure que la session avance, sur un sujet où il était pourtant pointu au début.
- Spécifique à Claude Code : il ré-explore un fichier ou une partie du repo qu'il a déjà lu, comme s'il n'avait plus le souvenir de l'avoir fait.
Quelques leviers pour optimiser et mieux gérer sa consommation de tokens et son contexte.
Le premier réflexe à avoir c’est le choix du modèle. Les modèles ne se valent pas tous, vous retrouvez en général chez tous les providers, 3 types de modèles :
- les petits pour les tâches simples (ex Haiku chez Claude),
- les modèles intermédiaires pour les tâches nécessitant un raisonnement modéré (ex: Sonnet chez Claude)
- et les modèles pour les tâches complexes nécessitant un raisonnement avancés ( Opus-5 ou Fable chez Claude).
Nous pouvons avoir le réflexe de choisir par défaut “ce qu’il y a de mieux”pour parer toute éventualité mais cela revient à surconsommer pour … rien. C’est comme si l’on allait chercher son pain en Ferrari - vous allez consommer 2 fois plus qu’une petite citadine qui aurait aussi bien fait le job.
Pour les utilisateurs d’outils de chats (ex :Claude.ai ; chat gpt, Perplexity, Gemini etc.)
- Demander des réponses moins longues : vous avez souvent la possibilité dans les paramètres de votre compte de personnaliser le comportement de votre IA - c’est là que vous pourrez lui demander des réponses courtes.
- Outre le recours aux techniques de prompt engineering, je trouve particulièrement intéressante celle du “chain of thought” : demandez lui de raisonner par étape pour éviter qu’il déroule tout un raisonnement complexe qui nécessitera plusieurs A/R d’ajustement et alourdira votre session. Personnellement sur des tâches longues ou complexes je lui impose carrément mon rythme en lui donnant une séquence à respecter - il ne doit pas passer à l’étape suivante si je n’ai pas validé l’étape précédente.
- S’imposer une rigueur dans les fichiers ajoutés au contexte de vos projets/assistants et faire un travail de curation. Qu’est-ce que ça veut dire ? Outre le fait de rester dans la logique d’un prompt système raisonnable qui se concentre sur une tâche simple et répétitive, vous devrez apporter un point d’honneur à trier et ajuster régulièrement les documents que vous ajouter à son contexte en :
- Utilisant une nomenclature claire qui parlera au modèle, par exemple : type-sujet-AAAA-MM.md → ref-glossaire-2026-07.md, ex-synthese-validee-2026-05.md
- Utilisant des fichiers simples et plus exploitables pour le modèle, notamment en privilégiant le format markdown qui est plus facile à lire pour une IA. Si vous pouvez transformer des documents dans ce format, faites-le, vous gagnerez en performance.
- Évitant de mettre des documents qui “pourront peut-être utiles ou intéressants on ne sait jamais” > triez ces documents, identifiez les slides ou éléments vraiment intéressants à partager parce qu’ils seront régulièrement utilisés pour la tâche que vous demandez.
- Retirant les documents qui ne sont plus pertinents - ex : pour un assistant chargé d’analyser des retours utilisateurs, les entretiens déjà analysés peuvent être retirés du contexte.
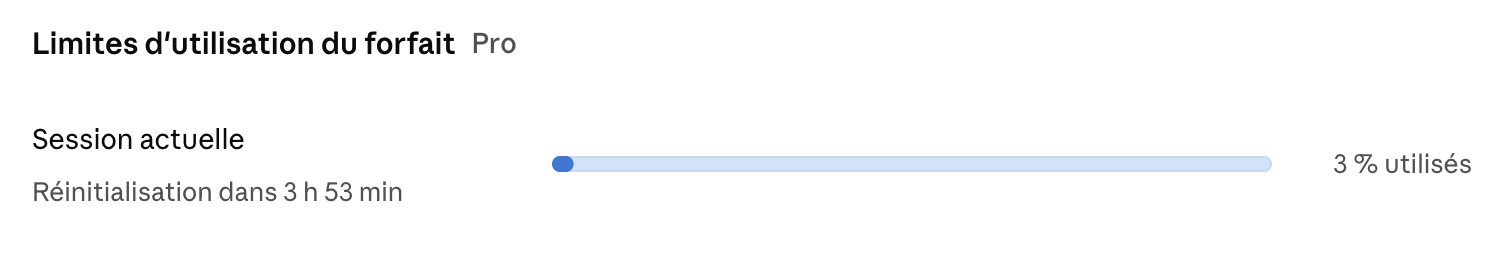
Tips : comment suivre sa consommation de tokens ? Tous les providers n’ont pas la même transparence. Vous retrouverez souvent dans les paramètres de votre compte un suivi de votre utilisation de l’abonnement ou des crédits supplémentaires que vous avez achetés. Si votre usage devient trop important sur un délai donné, votre provider vous bloquera jusqu’à réinitialisation de la période de décompte. Notez qu’avec ce type d’usage vous aurez rarement un suivi plus précis
Ex sur Claude dans vos réglages/paramètres :
NB : Vous pourrez aussi noter que si vous utilisez des forfaits Entreprise, le suivi est souvent moins évident car se fait à l’échelle de l’administrateur de votre organisation.
Pour les utilisateurs d’agents de code dans un IDE ou le Terminal
- Mieux calibrer votre fichier d’instruction CLAUDE.md ou AGENT.md ( selon vos usages) : il est permanent et est chargé au début de chaque conversation.
- Double conséquence : chaque ligne inutile est payée à toutes les sessions et, à l’inverse, chaque ligne utile évite un comportement coûteux. Le calibrer, c'est n'y garder que ce que l'agent ne peut pas déduire du code : votre intention, votre cadre, vos règles.
- La bonne pratique : le relire régulièrement pour s’assurer qu’il n’a pas dévié ou grossi inutilement. Pour un démarrage projet : partagez votre brief (intention, cadre, type de produit , cible etc.) et demandez à l’IA de vous proposer un fichier d’instruction sur cette base, relisez-le, amendez-le.
- Utilisez les commandes pour mieux piloter votre session ou mieux maîtriser votre contexte
- Piloter sa session
| Commande | Fonction | Quand l'utiliser (product people) |
|---|---|---|
| Taper "/" | Affiche les commandes disponibles dans ton environnement | En début de session : ce que tu vois fait référence |
| /model | Change le modèle de la session | Modèle rapide pour reformuler des tickets, modèle profond pour arbitrer un découpage |
| /usage | Affiche la fenêtre de quota en cours | Avant une analyse longue : vérifier le temps restant |
| /context | Affiche la répartition des tokens et le contexte restant | L'agent devient vague : vérifie s'il est saturé avant de reformuler |
| /init | Génère un premier CLAUDE.md depuis le code existant | Tu reprends un projet déjà démarré |
| /memory | Affiche les fichiers d'instructions chargés | Une règle semble ignorée : vérifie d'abord qu'elle est lue |
- Maîtriser son contexte
| Commande | Fonction | Quand l'utiliser (product people) |
|---|---|---|
| /compact | Résume la conversation et poursuit | Même tâche, fenêtre pleine : "/compact garde les critères de priorisation" |
| /clear | Repart sur un contexte vide | Tu passes de l'analyse du backlog à la revue de sprint |
| /resume | Retrouve une conversation antérieure | Tu reprends lundi le cadrage laissé vendredi |
| /btw | Pose une question de côté, sans trace dans l'historique | C'était quoi le nom du composant ? pendant que l'agent travaille |
| /fork | Copie la session dans une tâche en arrière-plan | Tu délègues une vérification de cohérence et tu continues à rédiger |
| /branch | Duplique la session et te bascule dans la copie | Deux options de découpage à comparer depuis le même cadrage |
A titre perso la commande /btw est ma préférée, elle permet de ne pas polluer sa session avec des questions ou remarques subsidiaires.
- Pour aller plus loin, il existe des plugins pour automatiser l’optimisation des tokens consommés par votre IA, on peut ici citer :
- Caveman qui - comme son nom l’indique, va simplifier les échanges et tendre vers un langage plus “homme des cavernes” en supprimant les éléments superflus comme les formules de politesse, les intros, le verbiage inutile. Il garantit de ne pas dénaturer vos instructions et notamment les consignes de développement.
- Rtk est un autre plugin qui lui s'intercale entre votre agent et le terminal. Il filtre la sortie des commandes avant qu'elles n'entrent dans le contexte. Elle a un intérêt si vous utilisez des commandes terminal dans votre contexte d’usage. Aujourd’hui le gain réel de ce type de plugin est challengé (source ici).
Personnellement je ne suis pas fan parce que l’on ne maîtrise pas ce que font ces plugins et que leur impact réel est soumis à débat, mais si vous êtes gros consommateur de tokens il peut être intéressant de tester leur impact.
Ce qu’il faut retenir
- Le context Engineering c’est la maîtrise des informations que vous partagez avec l’IA. Ces informations ne sont pas que dans votre fenêtre de conversation, loin de là, il y a une partie immergée de l’iceberg sur laquelle il faut avoir un œil.
- Gérer, organiser, structurer ce contexte est clé pour maximiser votre impact sur 3 choses : la consommation de tokens (et donc les coûts), la performance de vos outils IA et l’environnement.
- L’accès aux outils IA ne sera pas toujours aussi favorable aux utilisateurs. Maîtriser les données que vous partagez, savoir dans quel but et le faire avec responsabilité dans une logique économe sera un atout pour la suite.
- Le mieux est souvent l’ennemi du bien, ne cherchez pas la surperformance, c’est souvent contre-productif, adaptez vos choix de modèles selon des règles simples de bon sens.
- Différents leviers existent et vous permettront de jouer sur la vitesse ou la qualité des réponses des modèles que vous utilisez. Ce faisant, vous éviterez des A/R en trop, des réponses médiocres, des lenteurs de raisonnement.
Sources
- Anthropic, Effective context engineering for AI agent .
- Goldman Sachs Research, AI Agents Forecast to Boost Tech Cash Flow as Usage Soars , mai 2026.
- Deloitte, AI tokenomics: A CFO's guide to governing the AI P&L, avril 2026
- University of Rhode Island AI Lab, How Hungry is AI? Benchmarking Energy, Water, and Carbon Footprint of LLM Inference, mai 2025.
- Mistral AI, Our contribution to a global environmental standard for AI*, * juillet 2025 - étude ACV réalisée avec Carbone 4 et l'ADEME, normes ISO 14040/44.
- Open AI, Communiqué “Rendre l’IA accessible à tous”, février 2026
- Blog Octo, Les tokens, le nouveau pétrole que vous brûlez sans le savoir, juin 2026
- Blog Octo, IA générative et réchauffement climatique, comment réduire la facture, février 2026
- School of Product, l’humanité a-t-elle les moyens de s’offrir l’IA ?, novembre 2025