L'agentic sur le divan du coach : 24 questions, huit projets
En bref — Nous avons évalué nos huit projets menés avec des agents IA. La grille compte 24 questions, dont onze portent sur le travail avec les agents. Chaque note s'appuie sur une preuve lue dans le dépôt de code (l'espace qui stocke le code et son historique), jamais sur une impression. Les résultats nous ont surpris, à commencer par ceux de nos propres pratiques. Le hub, le projet qui pilote les sept autres, indiquait à quelle demande répondait une modification dans 2 % seulement de ses commits (les enregistrements successifs du code). Et aucun des huit projets ne gardait la trace d'une relecture faite par quelqu'un d'autre que l'auteur.
Ces résultats m'ont fait réfléchir à mon métier de coach. Un diagnostic d'organisation porte sur plusieurs équipes, et ses quatre sources classiques (entretiens, ateliers, réunions, outils) se paient en jours pour chaque équipe supplémentaire. Je propose d'y ajouter une cinquième source, lue avant mes rencontres : une évaluation agentic du travail agentic. Cet article raconte ce que la grille a montré chez nous, puis comment un coach peut s'en servir dans sa prise de contexte, avant toute recommandation, sans jamais remplacer l'écoute.
Le premier jour d'une mission
Tout coach qui a mené un diagnostic d'équipe connaît la scène. On arrive, on pose des questions, on écoute. L'équipe dit qu'elle teste, qu'elle relit, qu'elle documente ses décisions. Parfois c'est vrai. Parfois c'est vrai « en général ». Et parfois c'est ce qu'elle aimerait faire.
La prise de contexte est la phase où le coach découvre l'équipe. Classique, elle s'appuie sur quatre sources : les entretiens individuels, les ateliers d'équipe, quelques réunions auxquelles j'assiste et, parfois, l'observation d'un outil. Chacune est précieuse. Aucune ne dit ce qui se passe entre deux réunions, dans le travail lui-même.
Et je suis rarement devant une seule équipe. Un diagnostic d'organisation couvre plusieurs équipes, et je ne peux pas toutes les rencontrer aussi longtemps qu'il le faudrait. Je choisis, donc je passe à côté de quelque chose.
Avec l'arrivée des agents IA dans les équipes de développement, l'écart entre ce qu'on dit et ce qui se fait s'accentue. Qui a écrit ce code ? Qui l'a vérifié ? En amont, qui a écrit les user stories ? Ont-elles été relues, estimées ? Les consignes données à l'agent sont-elles partagées, où chacun a-t-il les siennes ? Les réponses sont souvent floues, y compris pour l'équipe elle-même.
Nous nous sommes retrouvés dans cette situation avec nos propres projets. Dans un précédent article, nous avons décrit le hub : le projet de pilotage qui suit sept autres projets menés avec des agents IA. Dans la suite, « projet » désigne ce que la grille évalue, et « équipe » ce que le coach accompagne. Il nous manquait une réponse à une question simple : où en est chaque projet, et sur quoi fonde-t-on cette réponse ? Nous avons construit une grille d'évaluation, et elle ressemble beaucoup à ce que fait un coach lors d'une évaluation.
Ce que l'agentic change pour le coach
Le coach n'est pas remplacé, il est augmenté. Jusqu'ici, en tant que coach produit, j'allais rarement sur le terrain du code. J'écoutais, je regardais le produit livré ; la fabrication restait une boîte noire. Une prise de contexte augmentée l'ouvre : des agents lisent pour moi les spécifications, le code et les tests, que l'équipe travaille avec des agents IA ou sans. L'exploration devient plus large, à 360°, et compte d'autant plus quand ces trois matériaux sont produits par des agents, que personne n'a écrits ligne à ligne. Je propose de changer ma façon de mener une prise de contexte sur quatre points.
Je lirais avant de rencontrer. Les traces du travail se liraient avant le premier entretien. J'arriverais avec une photographie factuelle et datée, au lieu de découvrir en réunion ce que le dépôt m'aurait appris en dix minutes.
Mes questions seraient plus justes. L'écart entre ce que l'équipe dit et ce que le dépôt montre deviendrait le sujet de la conversation, jamais une accusation. Au lieu de « relisez-vous chaque changement ? », je demanderais : « vous dites relire chaque changement ; qu'est-ce qui permettrait de le voir ? »
Je garderais mon temps pour l'écoute. Je le consacrerais à ce que l'agent ne voit pas : les tensions, les habitudes, la confiance.
Je changerais d'échelle. La même grille lirait les traces de chaque équipe, sans allonger le temps d'entretien, et donnerait pour toutes un relevé de même forme. Je m'en servirais pour choisir où creuser, pas pour classer.
Cette lecture s'appelle une évaluation agentic du travail agentic : des agents lisent les traces du travail que des équipes mènent avec des agents. Elle s'adresse à ce que j'appelle une usine agentic, où des équipes font spécifier, développer, tester et déployer par des agents IA. La grille l'évalue sur deux plans : la production (référentiel A) et la façon de produire (référentiel B).
La même évaluation sert deux fois. À l'équipe, elle montre quoi améliorer : la qualité de ce qu'elle produit et ses pratiques agentic. Au coach, elle montre comment l'équipe produit avec ses agents, ce qu'un entretien capte mal parce que l'équipe elle-même le connaît mal. C'est là que le coach devient augmenté : il n'évalue plus ce que l'équipe dit de son travail, mais la façon dont elle le fait.
L'instrument : 24 questions, deux référentiels
La grille compte deux référentiels, appliqués à chaque projet de la même façon : c'est ce qui permet de lire plusieurs équipes avec la même échelle. Chaque critère est une question en langage courant, pour qu'un non-développeur puisse s'en servir.
Le référentiel A, « Pratiques de développement », rassemble 13 critères. Il demande si le projet a en place les pratiques de base d'une équipe qui développe. Ses critères sont rangés en trois familles, dont voici les questions principales :
- Besoin et conception : le besoin est-il écrit en user stories exploitables ? Chaque story dit-elle à quoi on reconnaît qu'elle est finie ? Les choix d'architecture sont-ils écrits, datés, versionnés ? La grille lit la forme des stories, pas leur histoire : qui les a écrites, une personne ou un agent, qui les a relues, si l'équipe les a estimées. L'historique du dépôt en donne un début ; le reste se demande en atelier.
- Développement : peut-on remonter d'un changement à la demande qu'il sert ? Le code dit-il ce qu'il fait ? Un changement est-il approuvé par une autre personne que son auteur ? Les secrets restent-ils hors du dépôt ?
- Tests et livraison : existe-t-il des tests qu'une machine peut rejouer ? Évoluent-ils avec le code ? Au moins un test vérifie-t-il le résultat tel que l'utilisateur le reçoit ? Une chaîne automatique vérifie-t-elle chaque envoi ?
Le référentiel B, « Pratiques agentic », rassemble 11 critères. Il demande si le travail confié aux agents est cadré, borné, tracé et vérifié par un humain. Ses six familles suivent le cycle de vie d'une demande en cinq étapes (cadrer, borner, exécuter, livrer et valider, améliorer), plus la structure des agents. Le tableau placé plus bas, à côté de l'évaluation du hub, pose chaque question en clair avec la preuve que la grille regarde.
Comment une note est fabriquée
Nous avons posé quatre règles, sans doute la partie la plus transposable de notre démarche.
Une note s'appuie sur une preuve, et nomme sa preuve. Chaque critère est mesuré par un détecteur qui porte son nom et qui lit le dépôt du projet : fichiers présents, historique des versions, journal des exécutions. La note affichée cite toujours le critère et le détecteur qui l'ont produite. Personne ne peut dire « c'est un 6 parce que j'en ai l'impression ».
L'échelle est ancrée. Les notes vont de 2 à 10 par paliers de 2, et chaque palier est décrit. Prenons le niveau d'organisation du travail des agents :
- 2 si au plus un cadre d'instructions est écrit ;
- 4 si des agents spécialisés sont définis ;
- 6 si un orchestrateur est déclaré ;
- 8 si des procédures types existent ;
- 10 si un journal d'exécution est tenu.
La plupart des critères (21 sur 24) n'ont que deux états, présent (10) ou absent (2). La grille ne fabrique pas une nuance qu'elle ne mesure pas.
« Non mesuré » n'est pas zéro. Quand le projet ne permet pas de conclure, le critère s'affiche « non mesuré » et n'entre pas dans la moyenne. Un critère qui ne s'applique pas (le contrôle des appels à une IA, dans un produit sans IA) est « sans objet ». Une absence devinée pénaliserait une équipe pour ce que l'outil ne sait pas voir.
La sécurité verrouille. Si un problème de sécurité prioritaire est ouvert sur un projet, sa note globale devient « bloquant », jamais un nombre. Aucune moyenne ne doit pouvoir masquer une fuite de secrets. Seule une correction acceptée par une personne, puis appliquée, le lève.
Chaque critère documente ce que sa note permet de conclure et ce qu'elle ne permet pas de conclure. Constater qu'un fichier de consignes existe ne dit pas qu'il est respecté ; la grille l'écrit noir sur blanc. Et une note à une date : au-delà de sept jours sans nouvelle mesure, elle redevient « non mesuré ».
Cette honnêteté conditionne l'adhésion. Une équipe accepte une note basse si elle comprend d'où elle vient et ce qu'elle ne dit pas. Elle rejette une note, haute ou basse, dont elle ne voit pas la source.
Ce que la grille a montré chez nous
Quatre épisodes, chacun avec sa leçon pour un coach.
D'abord, le hub, mesuré le 29 septembre 2026. La moyenne est flatteuse, 9,2 sur 10. Ce sont les barres courtes qui comptent, et deux d'entre elles ont donné les épisodes 2 et 4 ci-dessous.
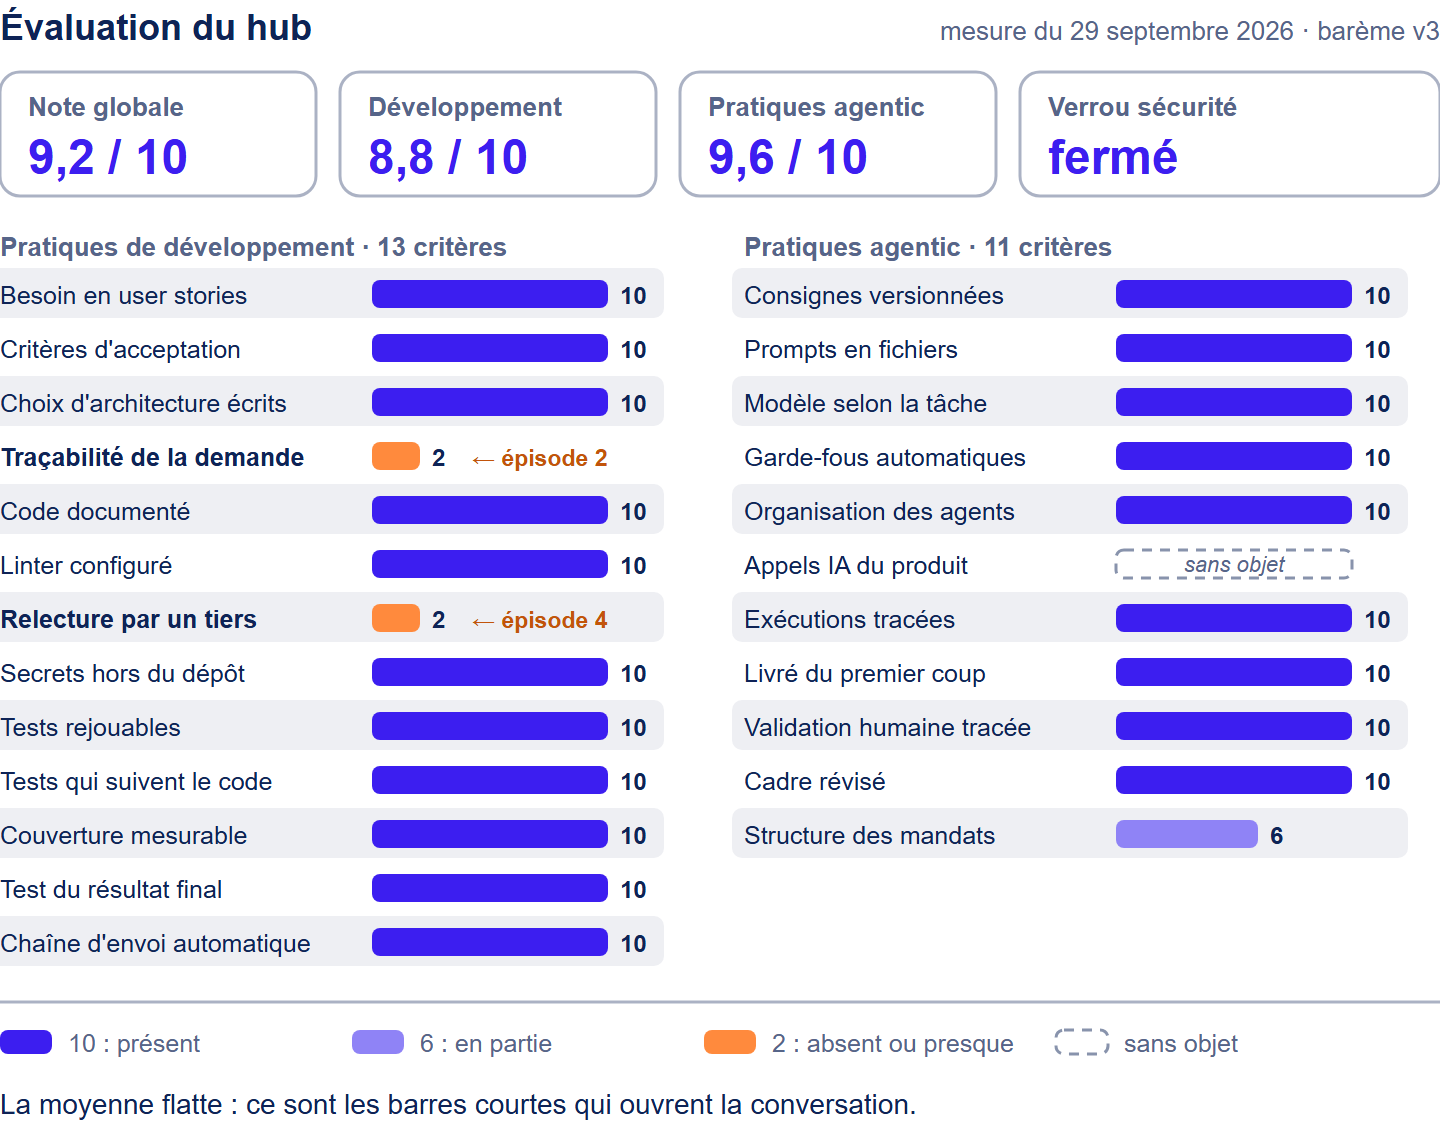
Le hub au 29 septembre 2026 : 20 critères sur 24 à 10, un à 6, deux à 2 (traçabilité de la demande, relecture par un tiers) et un sans objet.
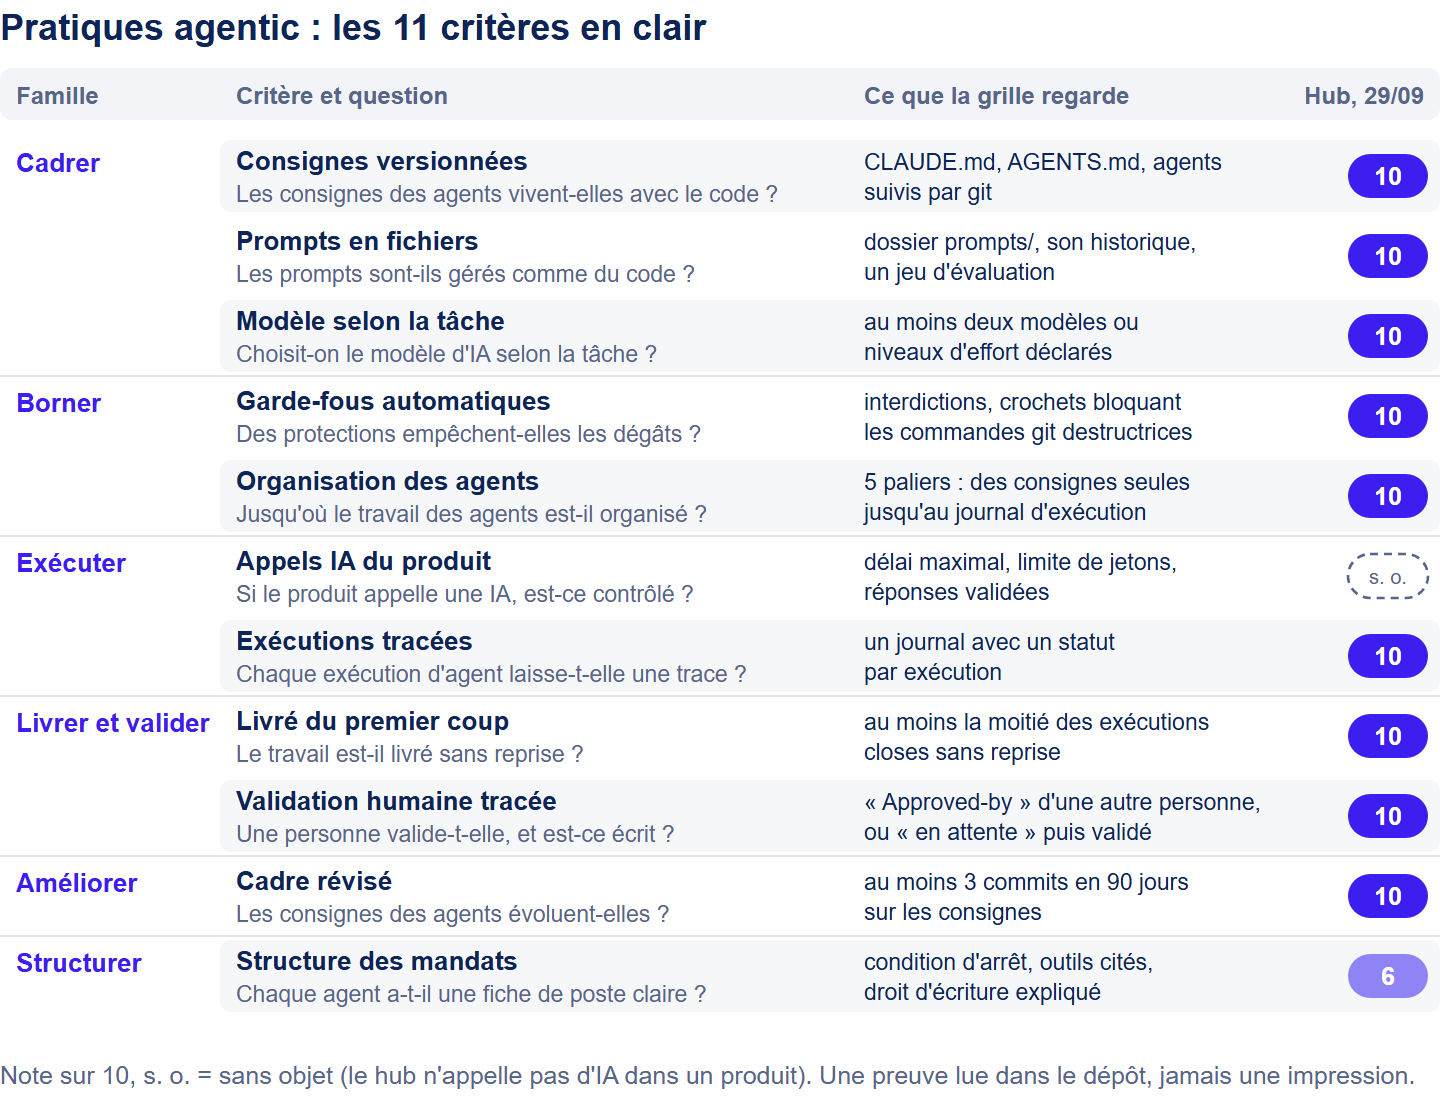
Derrière « Pratiques agentic » : onze questions, onze preuves, et la note du hub.
Épisode 1 : notre première grille ne servait qu'à nous
Notre première version notait des éléments propres à notre hub. Inutilisable ailleurs : un projet sans notre dispositif ne pouvait pas être évalué.
Nous avons donc réécrit la grille autour d'un détecteur générique, capable de lire n'importe quel dépôt. Les anciens indicateurs du hub restent affichés à part, sans entrer dans une note. Leçon : une grille qui ne mesure que votre propre méthode ne mesure pas l'équipe, elle mesure sa ressemblance avec vous.
Épisode 2 : le cordonnier mal chaussé
En notant le hub lui-même, nous avons obtenu 2 sur 10 en traçabilité : seuls 2 % de nos enregistrements de version (des commits) citaient la demande qu'ils servaient. Nous passions pourtant nos journées à travailler à partir de demandes écrites. La grille a mis le doigt sur un écart que nous ne voyions plus.
Nous avons adopté une convention (chaque commit cite sa demande dans une ligne finale) et ajouté un rappel automatique, qui n'est jamais bloquant. La note remontera avec la pratique réelle, pas avec un maquillage de l'historique. Leçon : le premier écart que la grille révèle est souvent chez celui qui la construit.
Épisode 3 : cinq façons d'allumer un voyant sans la pratique
En cherchant à tromper notre détecteur, nous avons trouvé cinq cas où un signal s'allumait sans que la pratique existe. Par exemple, un fichier de relecteurs comptait comme « relecture par un tiers » même quand l'auteur s'y désignait seul. Nous avons corrigé les cinq cas, en reproduisant chaque défaut par un test qui échouait avant la correction. Aucune note globale n'a changé, mais deux signaux sont passés de « présent » à « non mesuré ». Une grille moins flatteuse, plus fiable : c'est ce que nous voulions. Leçon : un outil de mesure se relit comme on relit un diagnostic, en cherchant comment il pourrait se tromper.
Épisode 4 : ce que la grille dit de l'ensemble
À cette même mesure, deux constats sautent aux yeux. La relecture par un tiers est notée 2 sur 10 sur nos huit projets. Et la validation humaine tracée est « non mesuré » sur sept des huit projets : la pratique existe peut-être, mais rien dans le dépôt ne permet de le prouver.
Un de nos huit projets est moins bien noté que le hub sans être le dernier : 7,1 sur 10, septième sur huit. On y retrouve les deux constats.
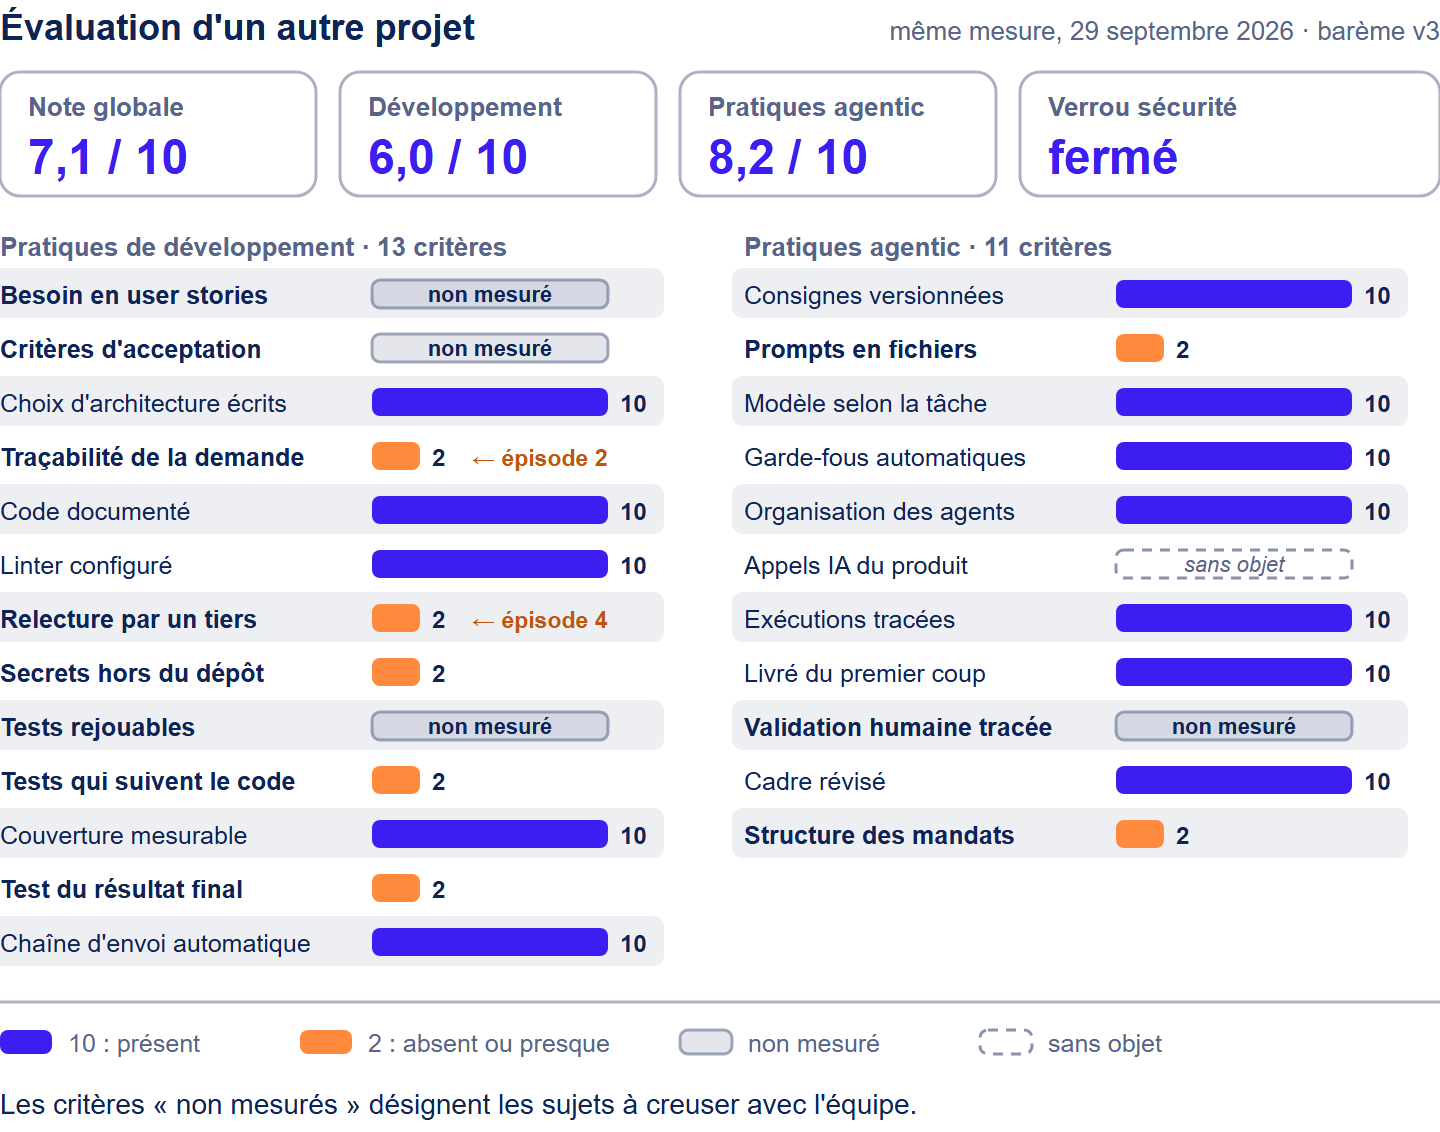
Un autre projet à la même mesure : 12 critères à 10, sept à 2, quatre non mesurés et un sans objet.
Notre lecture, que la grille ne fait pas à notre place : nos projets sont menés en grande partie par une seule personne avec ses agents. Ces deux constats ouvrent une conversation précise : qui relit ? Qui valide ? Où est-ce écrit ?
C'est ce que l'échelle d'une organisation permet de voir. Leçon : un motif qui traverse plusieurs équipes ne se règle pas équipe par équipe, mais au niveau de l'organisation.
Une prise de contexte augmentée, pas à pas
Voici comment je compte transposer cette démarche à une mission de diagnostic d'organisation, qui compte plusieurs équipes. La grille a tourné sur nos projets ; cette transposition est une proposition de méthode, à éprouver devant des équipes réelles.
0. Obtenir l'accord des équipes avant de lire quoi que ce soit. Lire les traces d'une équipe est un acte qui se dit et se consent. J'explique ce que je lis, pourquoi, et ce que je ne lis pas. Sans cette transparence, la meilleure mesure détruit la confiance dont l'entretien a besoin.
1. Une photographie de chaque équipe, pour choisir où creuser. La mesure automatique donne un état factuel et daté, avant même la première rencontre. Elle me dit où l'écart entre le discours et la pratique est le plus probable. J'y place mes ateliers et mes visites de réunions, et je garde quelques entretiens ailleurs, pour ne pas chercher seulement là où la grille m'a envoyé.
2. Des entretiens et des ateliers guidés par les 24 questions. Les 24 questions forment une trame d'entretien. Selon la casquette du coach, l'accent change. Le coach produit s'attarde sur les stories et leurs critères d'acceptation, mais aussi sur la fabrication : l'équipe est-elle efficace, sa production est-elle de qualité, répond-elle aux attentes de ses utilisateurs ? Le coach agile, sur la relecture, la validation et l'amélioration continue. Le coach de transformation, sur la façon dont l'organisation encadre l'usage de l'IA et en suit le coût.
3. Une restitution à deux niveaux, qui distingue le mesuré du non mesuré. Pour chaque équipe, elle sépare ce qui est établi, ce qui est absent et ce qui reste « non mesuré », le sujet à creuser. Pour l'organisation, elle fait ressortir les motifs communs.
4. Des recommandations tirées des écarts et du référentiel. La mesure produit, pour chaque projet, une page web à plusieurs onglets ; deux servent à recommander. L'onglet « Écarts » part de ce qui manque : pour chaque critère sous la note maximale, il montre ce que la détection a trouvé et l'action qui ferait monter la note. Par exemple : citer dans chaque commit la demande qu'il sert. Cet onglet transforme une note en liste de travail. L'onglet « Référentiel » dit d'où vient chaque critère : sa définition, sa source publique, ce que la note ne permet pas de conclure. L'équipe peut ainsi vérifier sur quoi repose une recommandation, et la discuter. J'en tire des recommandations argumentées ; chaque équipe en retient deux ou trois, en commençant par la sécurité.
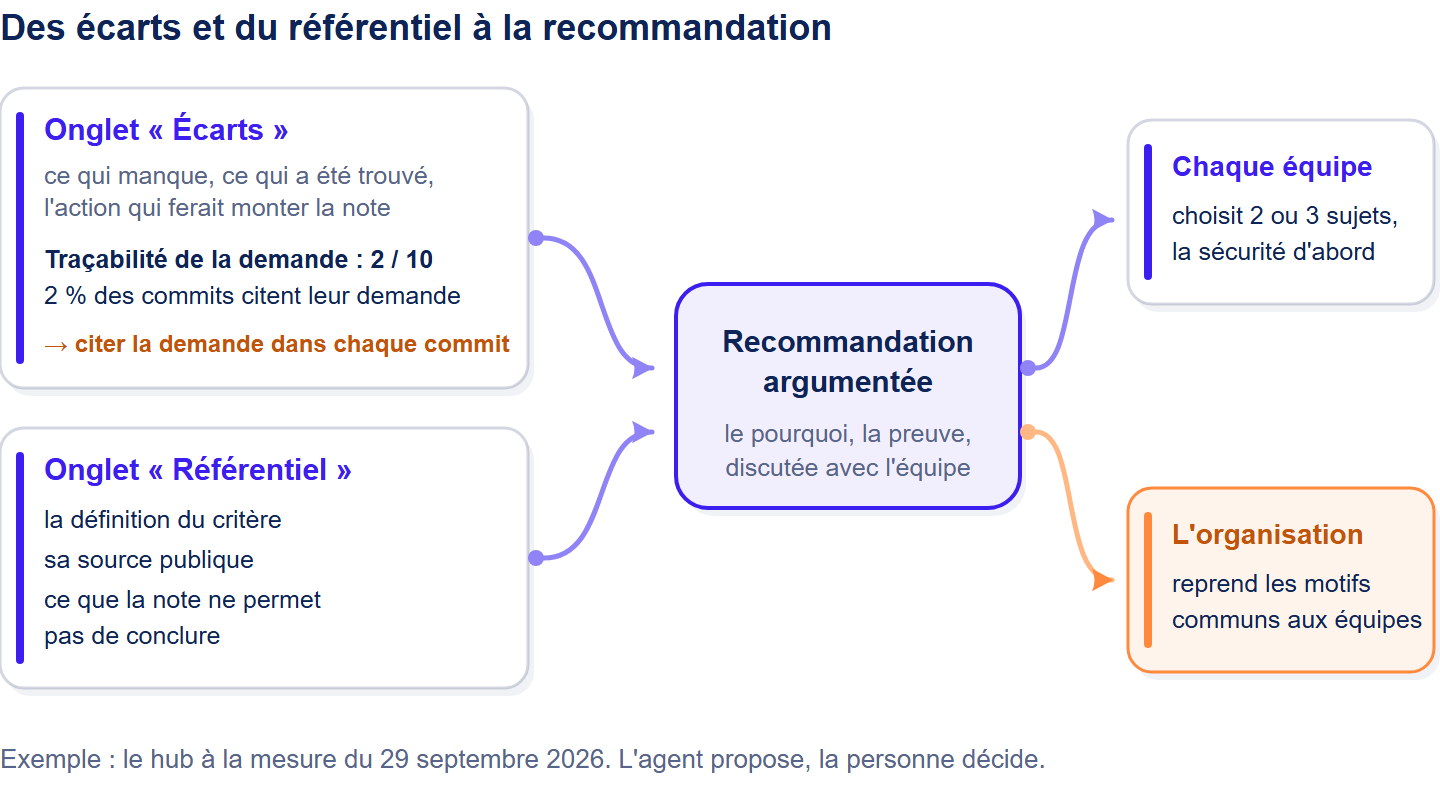
Des écarts et du référentiel à la recommandation : l'exemple est celui du hub.
Exemple d'une pratique agentic à note basse : « Prompts en fichiers », à 2 sur 10 sur six de nos huit projets, donc aussi un motif d'organisation.
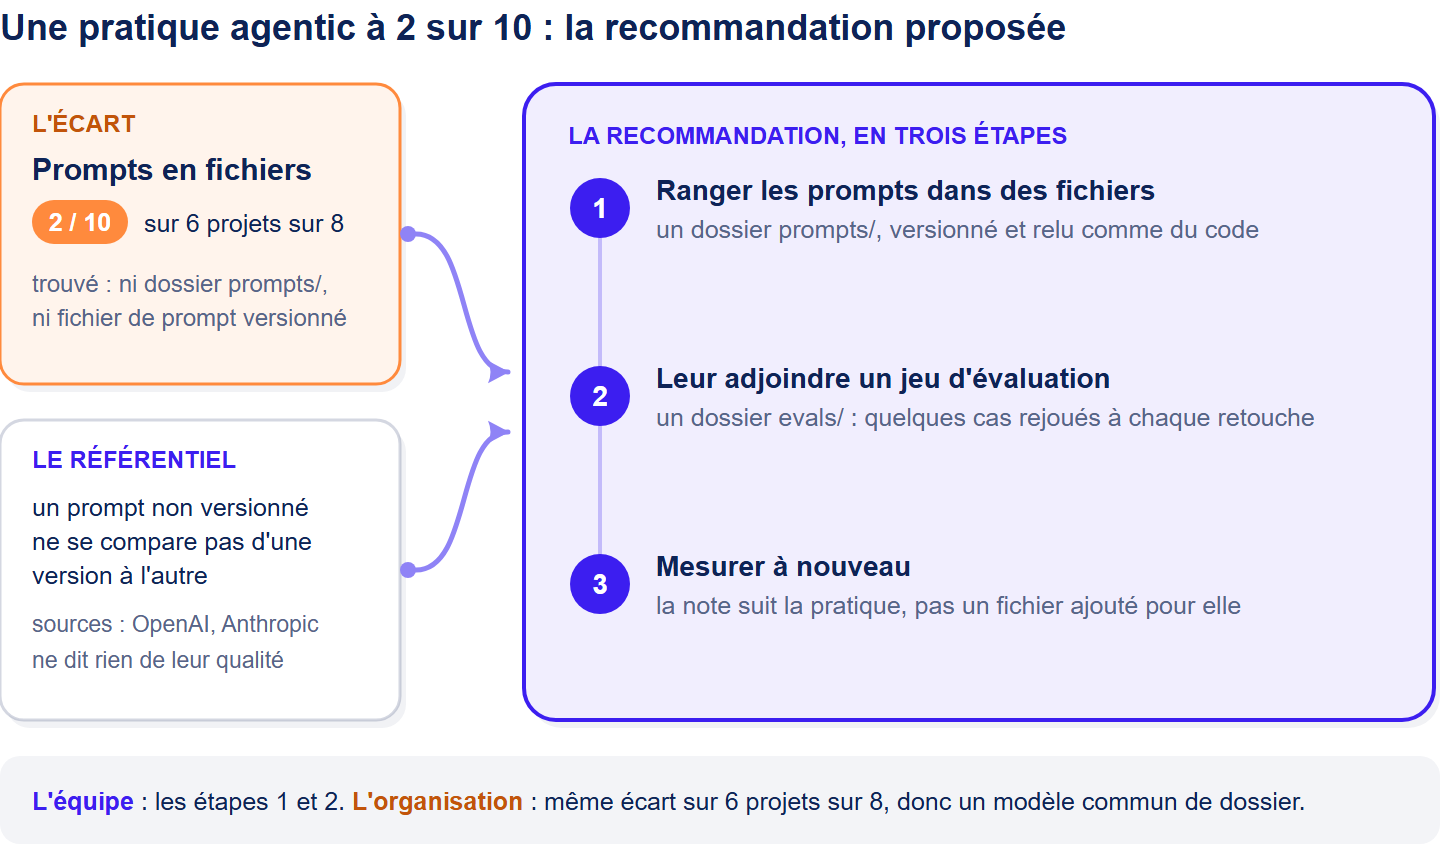
De l'écart à trois étapes concrètes.
5. Une nouvelle mesure pour constater les progrès. La note est datée : je mesure à nouveau après quelques itérations. Le progrès devient visible, ou son absence devient un sujet.
Ce que la grille ne permet pas de conclure
La note est un point de départ, pas un verdict. Comparer les projets est tentant (l'exemple plus haut en donne même le rang), mais trompeur. Les critères « non mesurés » sortent de la moyenne, dont la base varie donc d'un projet à l'autre. Un palmarès des équipes serait pire encore : une note lue comme un classement pousse à soigner la note plutôt que le travail.
La grille reste utile quand elle permet à une équipe de dire « ah, ça, on ne le fait pas » ou « si, on le fait, mais ce n'est écrit nulle part ».
Une trace n'est pas un comportement. La grille voit qu'un fichier de consignes existe ; elle ne voit pas s'il est lu, ni comment l'équipe se parle et décide. C'est une limite assumée : là, l'entretien, l'observation et l'écoute reprennent la main.
Elle ne voit que les équipes qui laissent des traces. Une équipe qui ne travaille pas dans un dépôt de code reste hors de son champ. Pour celle-là, les entretiens, les ateliers et les visites de réunion restent les seules sources.
Conclusion
Cette grille est née pour piloter nos projets. En chemin, nous avons retrouvé des principes que les coachs connaissent bien : partir des faits, rendre visible sans juger, laisser l'équipe choisir ses priorités, mesurer à nouveau pour apprendre. L'agentic ajoute une chose au métier : la possibilité de lire, avant de rencontrer, ce que le travail de plusieurs équipes laisse derrière lui. La façon de les accompagner reste humaine.
Le coach n'est pas seul à pouvoir se servir de cette grille. Un product owner (PO) qui fait développer son produit par des agents à besoin de repères pour ne pas dériver. La même grille lui donne un cap : le besoin est-il écrit, le code testé et relu, les agents cadrés ? Remesurée, elle dit s'il le tient.
Si vous accompagnez une organisation qui découvre l'IA, posez d'abord une question simple, issue de notre grille : les consignes données aux agents sont-elles écrites et versionnées avec le code ? La réponse peut en dire plus long qu'une heure de présentation.
Note de l'auteur
Pour structurer mon récit, j'ai boxé quelques rounds avec l'IA 🥊 : elle frappe vite, moi je réfléchis entre deux reprises. Pour la relecture finale, des collègues en chair et en os ont répondu là où j'avais noté mes doutes.
Ces articles m'ont aussi conduit à créer un agent scribe. Il relit mon français comme un correcteur attentif et propose ses corrections dans ma voix. Je tranche ; le fond reste le mien.