Je ne code pas, BMAD code pour moi avec ses agents : sur parole ou sur preuves ?
En bref — J'accompagne des équipes sur le produit et l'agilité, et je ne code pas. Pourtant, depuis des mois, des agents IA écrivent et testent le code de huit projets. Une méthode nommée BMAD cadre leur travail (je l'explique plus bas). Ces huit projets, je suis seul à m'en être servi, le plus souvent en essai. Moi, je demande, je tranche et je valide. Mes deux premiers articles décrivaient le dispositif qui pilote ces agents, puis la grille qui l'évalue. Celui-ci pose la question qui restait : mes projets sont équipés, mais sont-ils bons ? J'ai donc ajouté à l'évaluation un étage « Qualité du produit », en quatre questions, et je l'ai fait tourner le 1er octobre 2026 sur les huit projets. Résultat : deux questions sur quatre restent sans réponse, pour chaque projet. Les deux autres donnent des chiffres honnêtes, mais partiels. Voici ce que je lis à la place du code, comment je m'en sers, et ce qu'aucune mesure ne remplace.
Un accompagnateur d'équipes qui ne code pas
J'ai été développeur il y a très longtemps. Ce code-là n'est plus celui que je saurais lire aujourd'hui. Mon métier, c'est le besoin, les utilisateurs, la valeur. Et je fais pourtant écrire du code par des agents.
Voici ce que je fais : je formule la demande, je choisis quand un agent me propose deux options, je relis ce qu'il me rend et je dis « c'est bon » ou « recommence ». Voici ce que je ne fais pas : écrire le code, le déboguer, lire chaque modification. Mon rôle ressemble à celui d'un product owner (la personne qui porte le besoin et décide de ce qui est livré), sauf que mon équipe de développement est faite d'agents.
Un développeur fonde sa confiance sur le code qu'il a écrit et relu. Moi, je ne sais plus le lire. Alors, quand je valide un incrément (un lot de travail livré), qu'est-ce qui me dit qu'il est bon, et pas seulement livré ?
Quelques mots de jargon
- Le dépôt est l'espace où sont rangés le code d'un projet et tout son historique.
- Un commit est une version enregistrée dans cet historique : une modification datée, avec un intitulé d'une ligne.
- Un test automatique est un petit programme qui vérifie que le code fait ce qu'on attend. On le rejoue à chaque modification.
- Un linter (ici ruff) est un correcteur d'écriture du code, comme un correcteur orthographique. Il compte les infractions à des règles. Le seuil de lint est ce nombre, relevé à une date : un test interdit de le dépasser.
- La dette technique est ce qu'on a laissé en moins bon état pour aller plus vite. Comme un emprunt, elle coûte tant qu'on ne la rembourse pas.
- BMAD est la méthode que suivent mes agents. Elle leur donne des rôles d'équipe produit (analyste, architecte, développeur, testeur…) et leur fait écrire, avant le code, un cahier des charges puis des user stories. Je décide à chaque étape.
- Une user story décrit un besoin du point de vue de l'utilisateur. Ses critères d'acceptation disent, avant le développement, à quoi on reconnaîtra qu'elle est finie.
Les preuves que je lis à la place du code
Je ne lis pas le code, mais je ne valide pas à l'aveugle. Chaque demande passe par des étapes, et chaque étape laisse une preuve lisible par quelqu'un qui ne code pas.
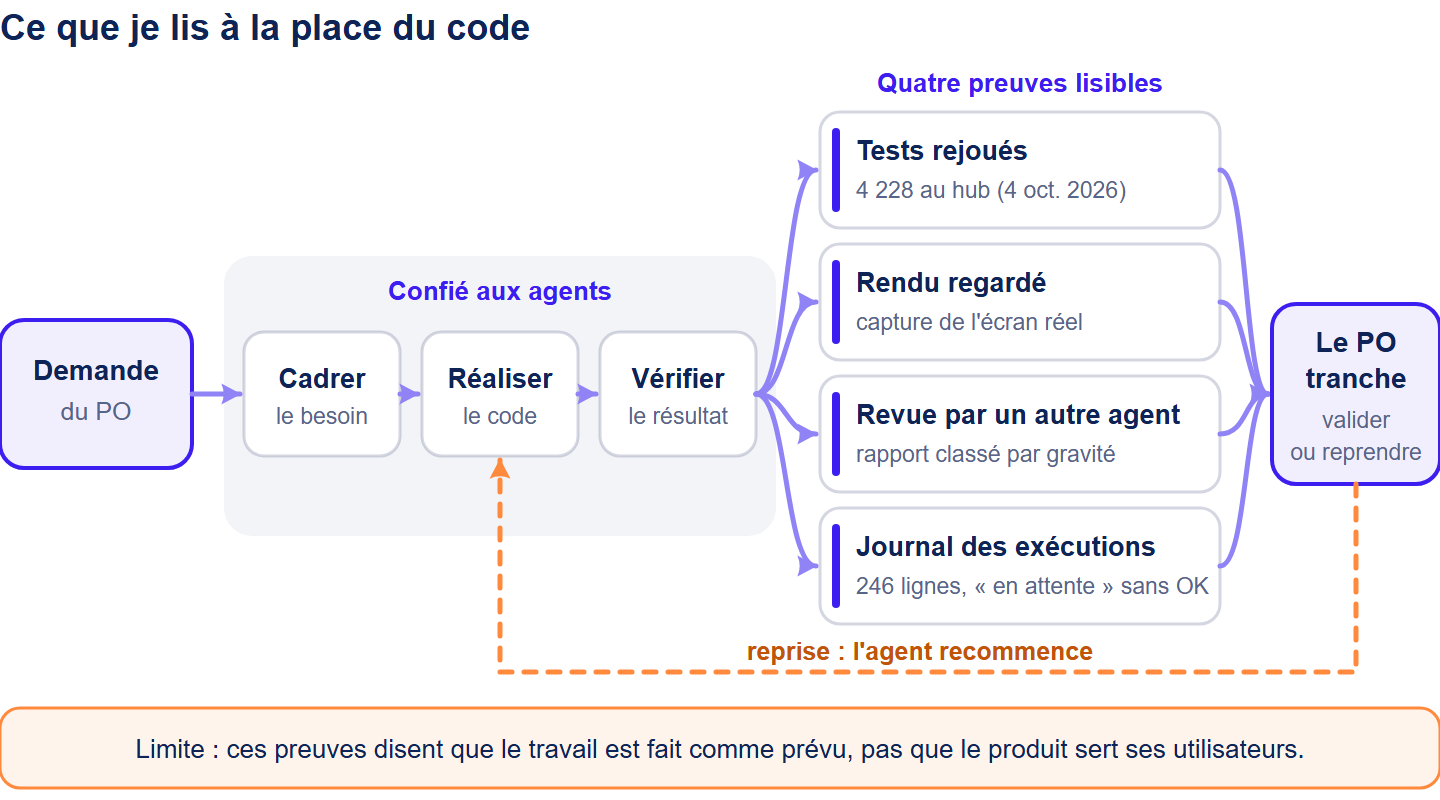
Les tests rejoués. Un agent qui modifie le code doit faire passer les tests avant de rendre la main. Le hub, le projet qui pilote les sept autres, en compte 4 228 au 4 octobre 2026.
Le rendu regardé. Un test peut passer sur une page qui s'affiche mal. Avant de dire « c'est fait », l'agent ouvre le résultat tel que l'utilisateur le recevra et en prend une capture d'écran. Cette capture, je la regarde moi-même.
La revue par un autre agent. Un agent qui relit le travail d'un autre trouve des erreurs que l'auteur ne voit plus. Je lis son rapport, classé par gravité, pas le code.
Le journal des exécutions. Chaque demande menée à bien laisse une ligne : ce qui était demandé, ce qui a été fait, comment c'était vérifié, combien de reprises. Une règle interdit à l'agent d'y écrire « succès » sur un livrable que je dois valider. Tant que je n'ai pas dit « OK », la ligne reste « en attente de validation ».
Ce journal comptait 234 exécutions au 1er octobre 2026 (246 au 4 octobre) : 195 en succès, 39 en succès partiel. Il sert aussi à me surveiller : un script a relevé que 44 de ces 195 succès, soit 23 %, ne citent aucune vérification dans leurs notes. Ils ne sont pas forcément mauvais, mais la trace de la vérification n'est pas restée.
Ces quatre preuves disent que le travail a été fait comme prévu. Elles ne disent pas que c'était la bonne chose à faire.
Comment je m'en sers au quotidien
Ces preuves ne servent à rien si je dois les chercher. Voici ma routine.
Une seule porte d'entrée. Je n'appelle pas les agents un par un. Je tape ma demande dans une seule commande. Un agent chef d'équipe, l'orchestrateur, la découpe, choisit les agents, lance en parallèle ce qui peut l'être et me rend une synthèse en français.
Une liste de décisions à l'ouverture. À chaque session, le dispositif (l'ensemble des agents, règles et scripts qui encadrent mes projets) m'affiche ce qui attend mon arbitrage : des constats signalés par les agents, des nouveautés repérées dans la veille technique, des tâches finies qu'il me reste à clôturer. Je réponds en une ligne par point : « applique », « refuse », « adopte », « écarte ». Chaque réponse est tracée avec sa date.
Un site de pilotage. C'est une page web locale, mon tableau de bord. Elle met en haut ce qui demande une décision, et les explications en dessous. Un jour, elle annonçait « 11 sujets à décider », dont plusieurs déjà tranchés. J'ai fait corriger le compteur. Une jauge qui ment est pire que pas de jauge.
Une synthèse avant chaque décision. Quand un sujet est technique, je ne tranche pas sur un intitulé. Je demande d'abord une vue d'ensemble : à quoi ça sert, quel résultat j'en attends, ce que ça coûte. Puis je réponds « OK » point par point.
Le dernier mot m'appartient. Un agent ne clôt jamais seul un livrable qui me concerne. C'est moi qui passe une exécution de « en attente » à « succès ».
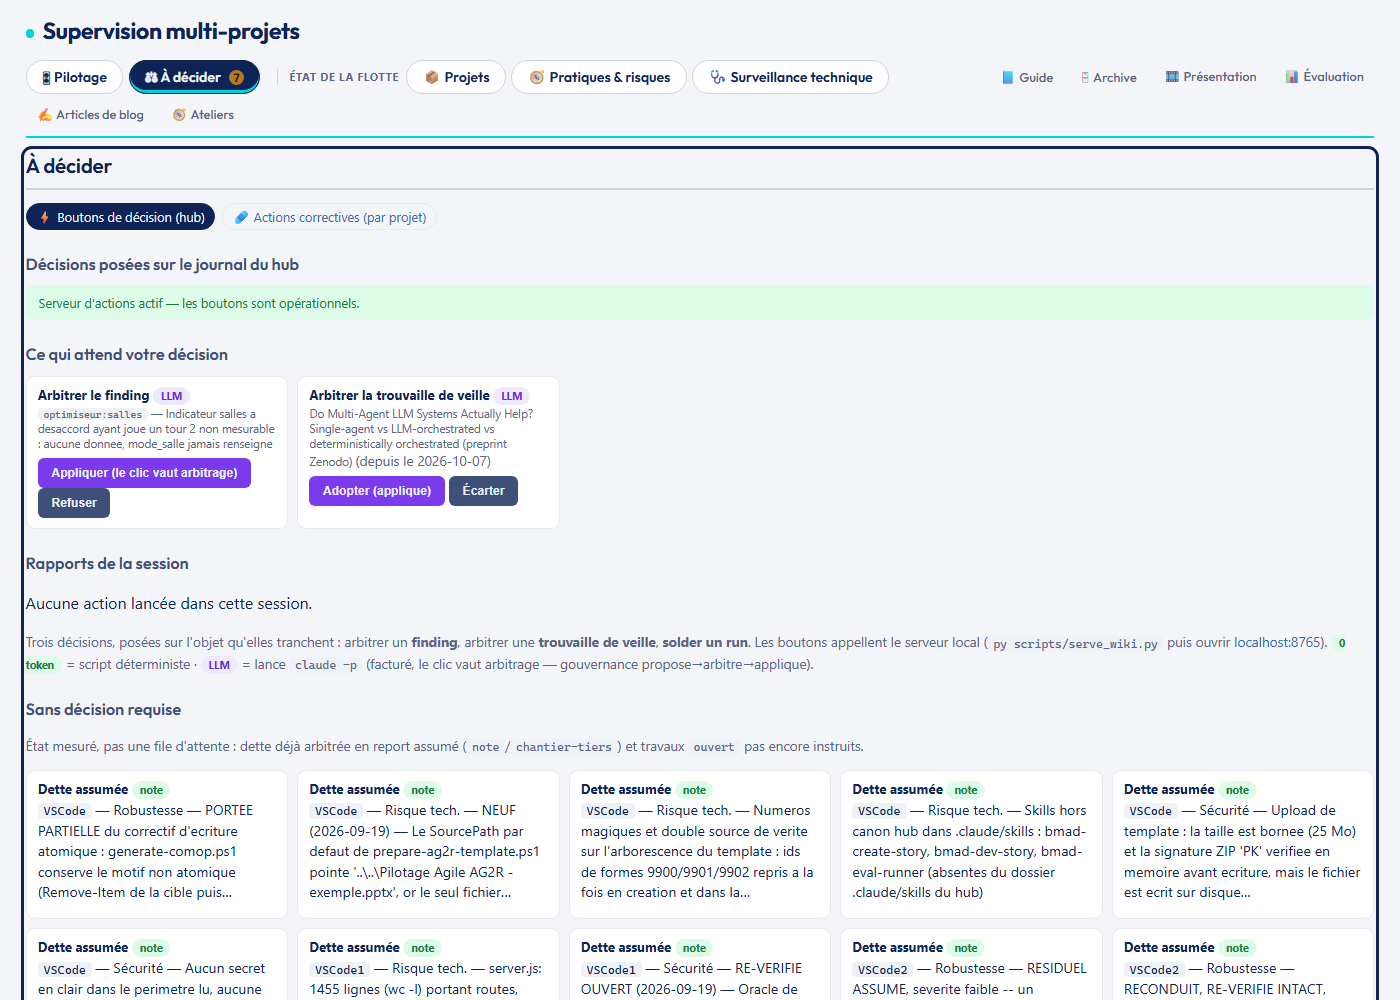
L'onglet « À décider » le 9 octobre 2026 : tout ce qui attend un choix humain est rangé au même endroit.
Équipé n'est pas « bon »
Mon deuxième article présentait une grille de 24 questions, appliquée aux huit projets. Elle demande si les pratiques sont en place : le besoin est écrit, le code testé et relu, les agents cadrés. Elle mesure la présence des pratiques, pas le résultat.
Un projet peut cocher les 24 cases et ne servir à personne. La grille lui donnerait une bonne note, et je l'aurais validé incrément après incrément, sur des preuves impeccables.
Il me fallait donc une définition du projet réussi, en quatre conditions :
- il répond aux attentes de ses utilisateurs ;
- il est utilisé ;
- il a presque zéro bug ;
- il a presque zéro dette technique.
Quatre questions, quatre sources
J'ai ajouté à l'évaluation un étage séparé, « Qualité du produit ». Chaque question a sa source et une phrase qui dit ce qu'elle ne permet pas de conclure.
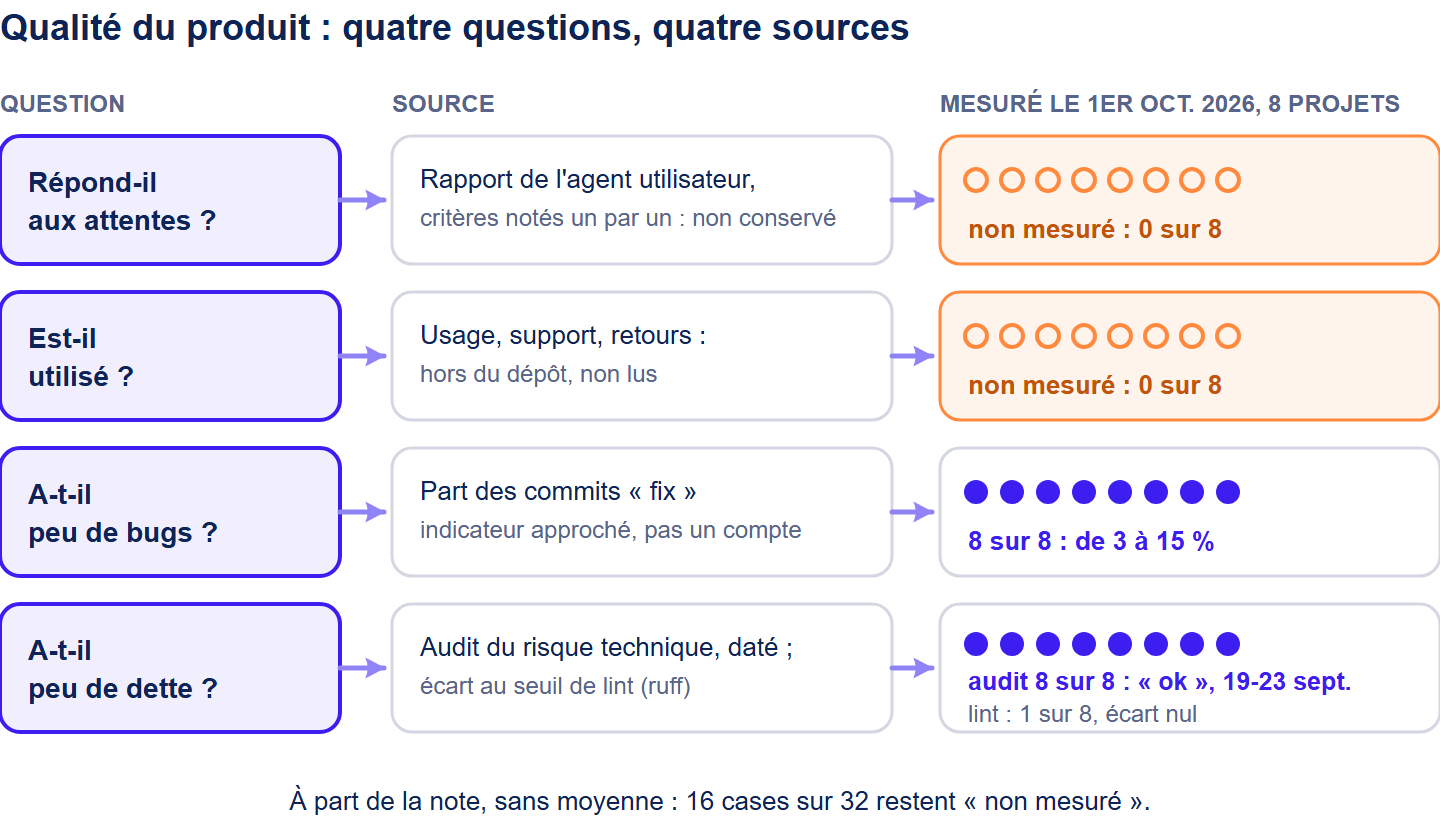
Répond-il aux attentes ? La source prévue est un agent « utilisateur simulé ». Il prend la place de la personne qui devra se servir du produit. Il parcourt le produit sur des cas d'usage réels, note un par un les critères d'acceptation et signale les défauts que les tests ne voient pas. Cet agent ne corrige rien : s'il réparait lui-même, il jugerait son propre travail. Son rapport s'ouvre sur un bandeau « 1 agent, 0 humain » : ce n'est ni un test utilisateur ni une recette (la validation formelle par les vrais utilisateurs). Un seul projet est dans son périmètre.
Est-il utilisé ? La réponse se trouve hors du dépôt : chiffres d'usage, tickets, retours. L'évaluation écrit donc « non mesuré », jamais une estimation.
A-t-il peu de bugs ? Je n'ai pas de compte de bugs. J'ai un indicateur approché : la part des commits de correction. Une convention répandue : l'intitulé d'un commit commence par un type. « feat » : nouvelle fonction. « fix » : correction. « docs » : documentation. La part des « fix » dit combien de temps le projet passe à réparer. Ses limites : une correction peut ne pas porter le préfixe, un « fix » peut corriger une simple coquille, et un bug jamais corrigé n'apparaît nulle part.
A-t-il peu de dette ? Deux sources : un audit technique du code, et un compteur d'infractions d'écriture.
L'audit technique. C'est une relecture du code confiée à un agent, à la demande, car elle coûte : l'agent lit vraiment le code, ce que mes compteurs automatiques ne font pas. Il ne corrige rien. Il rend un rapport daté avec, pour chaque critère, un niveau (« ok », « moyen » pour un point à surveiller, « critique » pour un point à traiter vite) et des constats situés au fichier et à la ligne. Je reprends ensuite chaque constat : corrigé, fermé avec la preuve, ou laissé en attente quand le corriger suppose un choix qui me revient.
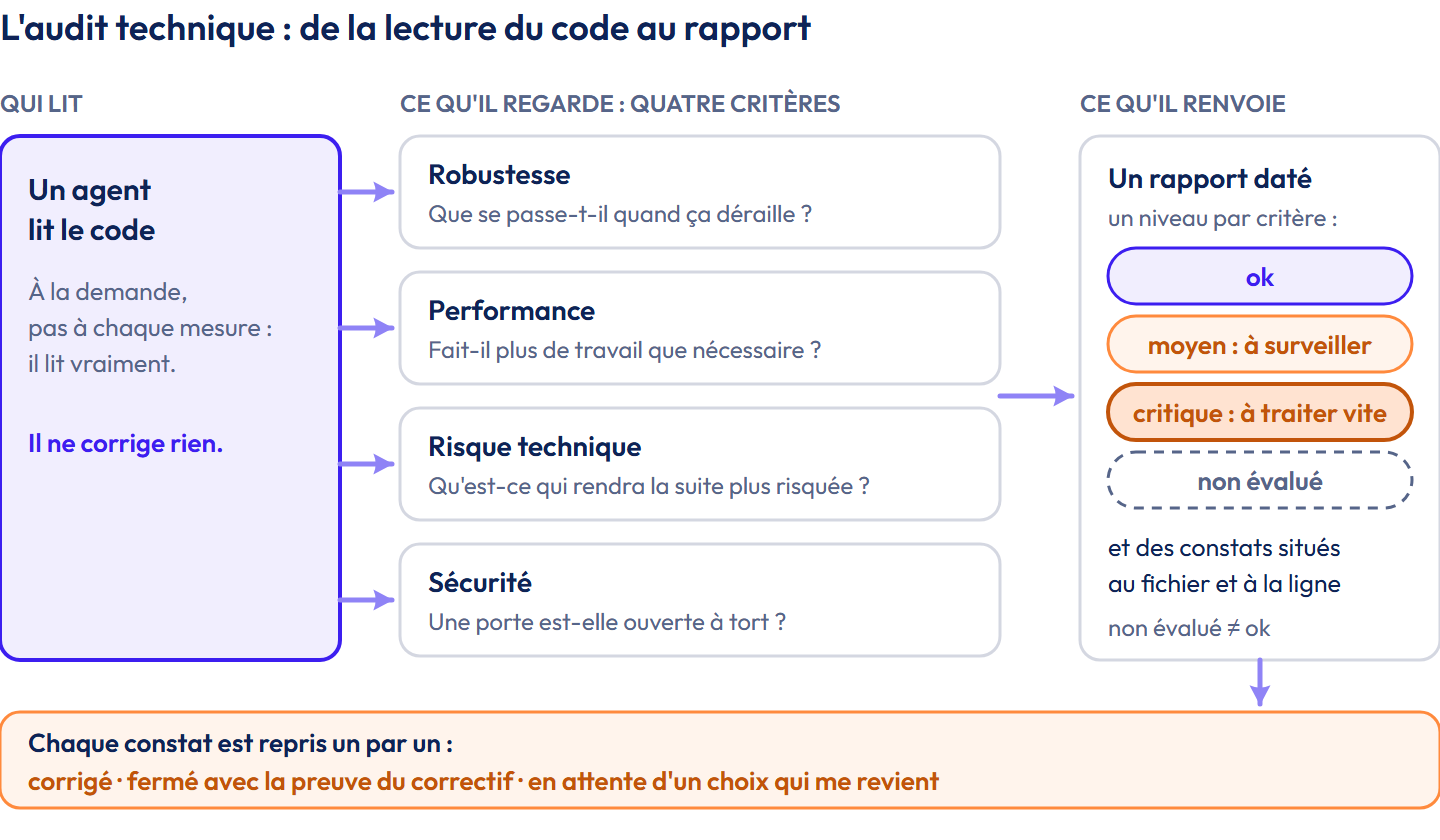
L'agent d'audit examine quatre critères :
- La robustesse : que se passe-t-il quand quelque chose ne se déroule pas comme prévu ? Exemple réel, corrigé cette semaine : un nom de champ inattendu, envoyé par un formulaire, faisait planter le serveur au lieu d'être refusé.
- La performance : le programme fait-il plus de travail que nécessaire ? Exemple réel : un serveur lançait un nouveau programme à chaque demande, sans limite. Dix demandes simultanées en lançaient dix.
- Le risque technique, la dette proprement dite : qu'est-ce qui rendra la prochaine modification plus lente ou plus risquée ? Exemple réel : un même module de mise en page existait en deux copies. Il n'en reste qu'une.
- La sécurité : quelqu'un de mal intentionné, ou une simple erreur, pourrait-il accéder à ce qu'il ne devrait pas ? Exemple réel : un contrôle de connexion sécurisée pouvait être trompé en envoyant deux valeurs au lieu d'une. Il les lit désormais toutes.
Un quatrième niveau existe, « non évalué » : l'agent n'a pas pu regarder, faute de temps ou d'accès. Il ne vaut pas « ok », qui affirme avoir regardé sans rien trouver.
Le seuil de lint*.* J'ai enregistré à une date le nombre d'infractions relevées par ruff. Un test fait échouer toute modification qui le fait monter : il peut baisser, jamais monter.
Ces quatre questions restent à part de la note de la grille : une moyenne entre « non mesuré », un pourcentage et un niveau d'audit n'aurait aucun sens, et elle aurait caché la case vide derrière les cases pleines.
Ce que j'ai trouvé
J'ai fait tourner l'étage sur les huit projets le 1er octobre 2026. Ce sont des outils internes de taille modeste : deux applications web (un questionnaire de maturité d'équipe, un outil qui transforme des entretiens en présentation), quatre projets qui produisent des présentations PowerPoint, un petit projet d'apprentissage (un client pour Trello) et le hub. Les plus anciens ont quatre mois, les deux plus jeunes deux semaines. Leur historique va de 80 à 752 commits. Je suis le seul à m'en être servi, surtout en test.
Le résultat se lit comme une grille : huit projets, quatre questions, 32 cases.
Attentes : non mesuré, sur les huit projets. Je m'attendais à sept cases vides et une remplie. Le huitième projet possède pourtant ses critères d'acceptation, rédigés sous la forme « étant donné…, quand…, alors… ». Par exemple : étant donné un fichier d'entrée valide et un modèle de présentation, quand je lance la commande, alors un fichier de présentation est créé et chaque section affiche un statut lisible.
L'agent utilisateur a bien été lancé. Mais il rend son rapport à la conversation qui l'a lancée, et ce rapport n'est conservé nulle part. L'évaluation n'a rien à lire. C'est la première leçon : une vérification dont on ne garde pas la trace ne compte pas. Elle a eu lieu, elle m'a peut-être convaincu ce jour-là, mais elle ne peut être ni relue ni comparée à la suivante.
Usage : non mesuré, sur les huit projets. C'était attendu : je suis le seul utilisateur. Aucun projet ne remonte de données d'usage, et l'évaluation ne va pas les chercher ailleurs. Pour un outil interne, la réponse tient souvent en une conversation : qui s'en est servi le mois dernier, et pour quoi faire ?
Bugs : de 3 à 15 % de commits « fix ». C'est la seule ligne mesurée partout. Un exemple tiré du hub : un contrôle automatique comptait mal les fichiers d'une fusion de branches, je l'ai fait réparer (intitulé du commit : « fix(hooks): count files of merge commits… »). Sur les huit projets :
- quatre sont entre 3 et 6 % (7 sur 231, 7 sur 245, 8 sur 185, 9 sur 166) ;
- deux sont entre 9 et 10 % (7 sur 80, 42 sur 430) ;
- le hub est à 11 % (81 sur 752) ;
- le plus jeune, ouvert le 15 septembre, est à 15 % (13 sur 87).
Qu'est-ce qu'une bonne valeur ? Je n'ai pas de référence, et je n'en inventerai pas. Le plus élevé n'est pas forcément le plus inquiétant. Le plus jeune découvre son terrain. Sur 87 commits, deux corrections de plus font bouger le taux de deux points. Pour le hub, 27 de ses 81 « fix » portent sur ses outils de mesure et ses garde-fous, ceux qui surveillent les sept autres projets. Ces taux ne disent pas combien de bugs ont atteint un utilisateur.
Dette : un audit daté partout, un seuil de lint sur un seul projet. Je ne retiens ici que le risque technique. Les huit audits lui donnent le niveau « ok ». Ils datent du 19 au 23 septembre 2026, soit huit à douze jours avant la mesure. C'est un contrôle technique : il vaut pour l'état du véhicule le jour du passage, pas pour les kilomètres faits depuis. Seul le hub a un seuil de lint. Le 1er octobre, il mesurait 164 infractions pour un seuil de 164 : écart nul. Le seuil a baissé depuis, à 46 le 2 octobre puis à 40 le 4. Une valeur inquiétante serait un écart qui grandit d'une mesure à l'autre. Sur les sept autres projets, l'indicateur n'existe pas encore.
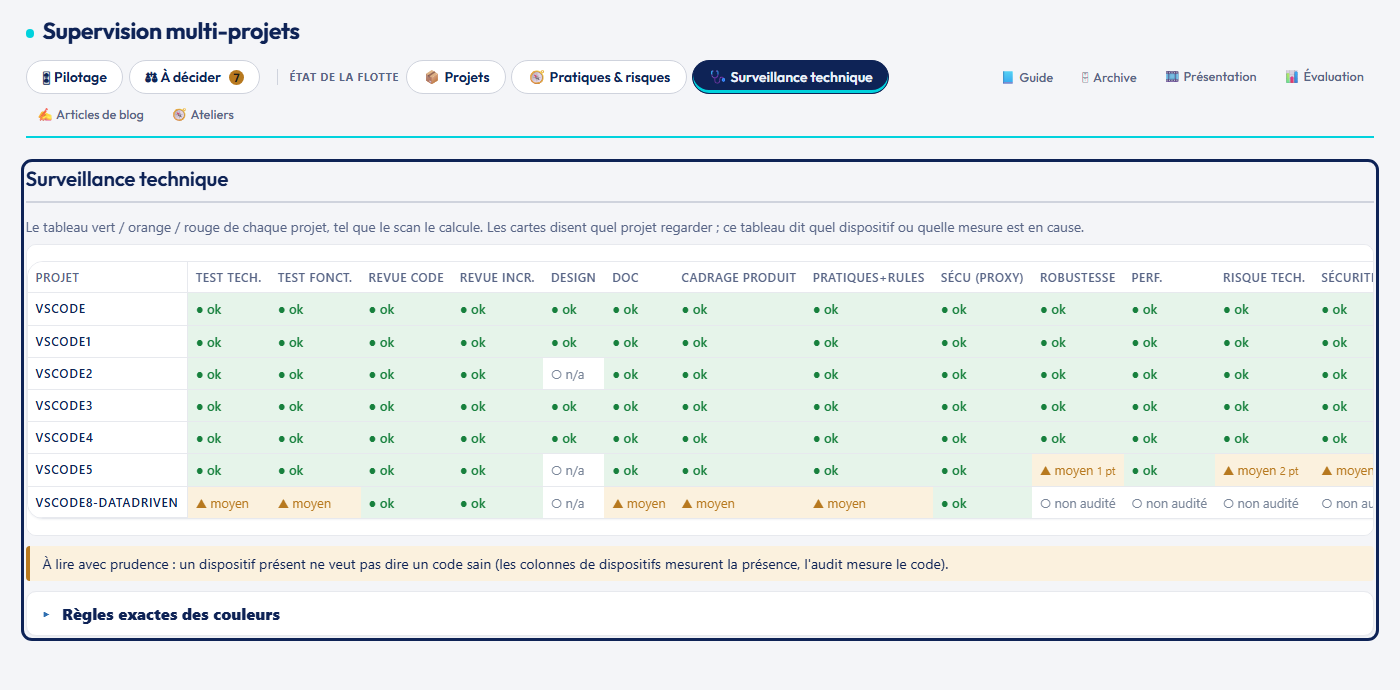
La surveillance technique le 9 octobre 2026, huit jours après la mesure de l'étage : l'état a bougé depuis. Le tableau montre où regarder, pas si le produit sert.
En résumé, 16 cases sur 32 sont « non mesuré ». Ce sont les deux premières lignes, attentes et usages, pour les huit projets. Ce vide est un résultat : il montre où mon dispositif est aveugle, au même endroit partout, donc une cause commune plutôt qu'une négligence locale.
Conclure « mes produits sont de bonne qualité » serait tentant : audits tous « ok », taux de correction modestes. Ce serait l'erreur que cet étage existe pour empêcher. Les deux cases vides sont celles où se joue la valeur d'un produit.
Ce que cette mesure change dans ma façon de travailler
Conserver ce que l'agent utilisateur constate. Son rapport doit être gardé à côté du projet, daté, avec ses critères notés un par un. Sinon la ligne « attentes » restera vide, quel que soit le nombre de lancements. C'est une proposition que je dois encore arbitrer : où le ranger, sous quelle forme, qui le relit.
Poser la question de l'usage à l'humain, pas au dépôt. Aucun agent ne m'apportera cette réponse : il faut aller voir les utilisateurs.
Lire les chiffres dans le temps, pas entre projets. Le même projet à 11 % puis à 6 % trois mois plus tard dit quelque chose. Je referai la mesure à chaque évaluation.
Ce à quoi je me fie, et ce qui reste humain
Revenons à la question du titre. À quoi me suis-je fié, moi qui ne lis pas le code ?
À des preuves que je sais lire, d'abord. Elles m'ont évité de nombreuses erreurs et m'ont montré les miennes, comme ces 23 % de succès validés sans trace de vérification. À des indicateurs approchés, ensuite, dont les limites sont écrites à côté du chiffre. Pour le reste, les attentes et l'usage, je ne me fie à rien de mesuré : ce sont les questions où les agents m'aident le moins.
Développer n'est plus réservé aux développeurs. N'importe qui peut désormais faire construire un logiciel, mais pas n'importe comment. Mes huit projets m'ont appris cinq conditions :
- une demande cadrée, avec des critères d'acceptation écrits avant le développement : c'est ce que BMAD impose à mes agents, et sans eux, rien ne dit ce que « fini » veut dire ;
- des preuves lisibles sans lire le code : tests rejoués, rendu regardé, revue, journal ;
- des garde-corps automatiques, qui bloquent par exemple une commande destructrice avant qu'elle parte ;
- un regard indépendant de celui qui a fabriqué : un autre agent pour la revue, l'agent utilisateur pour les attentes ;
- une personne qui tranche et répond du résultat : l'agent propose, je valide ou je fais reprendre.
Même réunies, ces conditions laissent deux angles morts. Il reste une limite, liée à mon parcours : je ne sais plus juger le code lui-même. Je m'en remets à un audit mené par un agent. Sur un produit qui manipule des données sensibles ou de l'argent, je ne m'en contenterais pas : là, un développeur reste nécessaire.
Ne pas savoir coder m'a obligé à chercher la qualité ailleurs : moins dans le code, davantage dans les traces et chez les utilisateurs. C'est peut-être le vrai travail du PO augmenté : savoir ce que les agents prouvent, et aller chercher lui-même ce qu'ils ne peuvent pas prouver.
Conclusion
Je ne code pas, et je fais pourtant construire des outils par des agents. Ma confiance repose sur des preuves que les agents laissent derrière eux, et sur un étage de mesure qui dit honnêtement ce qu'il sait et ce qu'il ignore.
Sa première mesure m'a appris deux choses. Mes projets sont équipés et testés, avec des taux de correction modestes. Et je ne sais toujours pas, mesure à l'appui, s'ils serviront ceux pour qui ils ont été faits, puisque je suis le seul à les avoir essayés.
Si vous faites développer un produit par des agents, posez-vous une question avant la prochaine validation : parmi les preuves que je lis, laquelle dit que le produit sert ses utilisateurs ? Si la réponse est « aucune », vous savez où aller ensuite. Pas dans le code : chez vos utilisateurs.
Note de l'auteur
Pour structurer mon récit, j'ai fait avec l'IA ce que je fais avec les équipes : poser des questions et laisser les autres taper. À ceci près qu'elle n'a jamais réclamé de rétrospective. Les chiffres de cet article sortent des scripts du dispositif, mesurés le 1er octobre 2026 et certains recomptés le 4, pas d'une boule de cristal.