Harnais agentiques (épilogue) : travailler au quotidien avec un agent frontière
Harnais agentiques (épilogue) : travailler au quotidien avec un agent frontière
Epilogue d'une série en deux volets. Premier volet : « Pourquoi les bonnes pratiques d'hier coûtent cher aujourd'hui ». Deuxième volet : « Huit réflexes à désapprendre pour un harnais frugal ».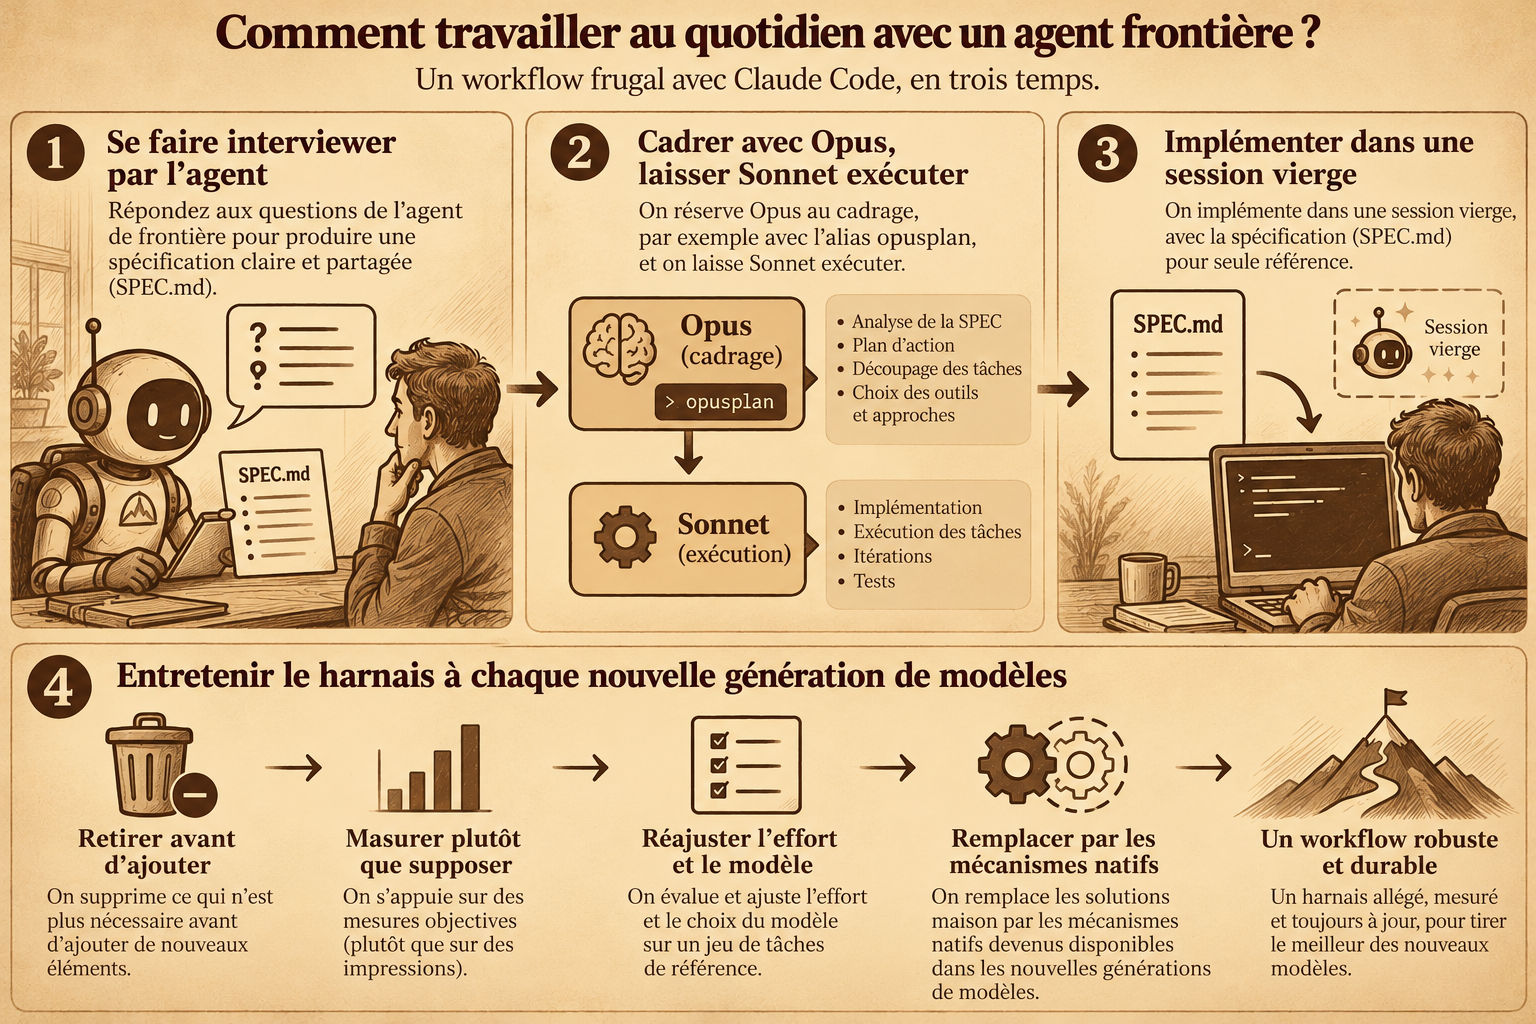
Dans les deux volets précédents consacrés aux harnais agentiques, nous sommes partis d'un constat : les modèles agentiques de frontière ont fortement évolué, et les artefacts qui composent leurs harnais (instructions, outils, règles, orchestration) doivent évoluer avec eux.
Nous n'avons en revanche fait qu'effleurer une question tout aussi essentielle : comment interagir avec ces agents au quotidien ?
C'est l'objet de cet épilogue, qui prolonge directement les deux volets précédents.
Il se déroule en trois temps :
- un workflow concret, de l'expression du besoin à l'implémentation, qui met en œuvre plusieurs des réflexes décrits dans le deuxième volet ;
- une méthode pour faire évoluer son harnais à chaque nouvelle génération de modèles ;
- une synthèse pour ne plus jeter ses jetons par la fenêtre.
Comme dans les volets précédents, les exemples s'appuient sur Claude Code et les modèles Claude Opus 5.5 et Sonnet 5.5 ; les principes restent valables quels que soient l'agent et le fournisseur.
Table des matières
- En pratique : un workflow frugal avec Claude Code
- Faire évoluer son harnais au rythme des modèles
Économiser des tokens : une approche globale
Conclusion : un harnais vivant, une pratique vivante
1. En pratique : un workflow frugal avec Claude Code
Les huit réflexes du deuxième volet prennent tout leur sens lorsqu'on les applique au quotidien. Prenons un cas fréquent : vous devez transmettre à l'agent de nouveaux besoins métier.
Ce workflow en trois temps (cadrer, choisir le modèle, implémenter) en met plusieurs en œuvre à la fois : des consignes extraites plutôt que rédigées (deuxième volet, § 1.1), le bon modèle au bon moment (deuxième volet, § 1.4), un contexte propre adossé à un artefact explicite (deuxième volet, § 1.8).
1.1. Cadrer : se faire interviewer par l'agent
Plutôt que de rédiger vous-même une longue spécification, la méthode recommandée aujourd'hui consiste à inverser les rôles : c'est Claude qui vous interroge et extrait de votre tête le contexte dont il a besoin.
Le prompt « interview ». La documentation officielle propose un modèle de prompt qui s'appuie sur l'outil AskUserQuestion :
Je veux construire [brève description]. Interroge-moi en détail avec l'outil AskUserQuestion. Pose des questions sur l'implémentation technique, l'UI/UX, les cas limites, les risques et les compromis. Évite les questions évidentes, creuse les points difficiles auxquels je n'aurais pas pensé. Continue jusqu'à avoir tout couvert, puis rédige une spécification complète dans SPEC.md.
L'intérêt est de faire émerger, dès le départ, les décisions que vous auriez sinon découvertes en plein milieu de l'implémentation. Un conseil : répondez honnêtement, y compris aux questions pour lesquelles vous n'avez pas encore de réponse. C'est précisément là que se trouve le vrai travail.
Parler plutôt qu'écrire
Parler va souvent plus vite qu'écrire, et l'on en dit davantage. Si vous êtes connecté avec un compte Claude.ai, commencez par la commande /voice, intégrée à Claude Code : la transcription ne consomme ni messages ni tokens, et elle reconnaît le vocabulaire technique (regex, OAuth, JSON…), en s'aidant du nom du projet et de la branche git.
Deux modes existent : hold, le mode par défaut, où l'on maintient Espace pendant que l'on parle, et tap, où un premier appui lance l'enregistrement et un second envoie le prompt.
Pensez à régler la langue sur le français dans /config : sans réglage, la dictée reste en anglais. /voice n'est en revanche disponible ni avec une clé API Anthropic, ni via Amazon Bedrock, Google Cloud ou Microsoft Foundry, ni dans les sessions distantes (cloud, SSH).
Un outil tiers comme Wispr Flow (ou VoiceInk pour une transcription en local) ne se justifie que dans ces cas, ou si la qualité en français ou la mise en forme vous déçoit.
Gardez toutefois une règle en tête : la voix sert à transmettre le contexte, pas le code. Exposez le problème oralement, laissez le modèle écrire, puis reprenez la main au clavier pour relire et affiner.
1.2. Choisir le bon modèle pour chaque phase
Opus pour le cadrage
C'est au moment du cadrage que se jouent les décisions difficiles : quelles questions poser, quels cas limites anticiper, quels compromis accepter. Opus raisonne mieux sur ces choix d'architecture, mais il coûte plus cher et atteint plus vite les limites d'usage. Sonnet, plus économique, peut en revanche perdre en précision sur les décisions de conception complexes. Comme l'interview consomme relativement peu de tokens, c'est le meilleur endroit pour investir dans le modèle le plus capable : une application directe du coût global de réalisation (deuxième volet, § 1.4).
L'alias opusplan. Le plus pratique est d'utiliser l'alias opusplan, qui fait appel à Opus pendant le mode Plan, puis bascule automatiquement sur Sonnet pour l'exécution. L'association est naturelle : en mode Plan, Claude utilise justement AskUserQuestion pour recueillir vos besoins et clarifier vos objectifs avant de proposer un plan. Pour l'activer :
- saisissez /model opusplan ;
- appuyez sur Shift+Tab jusqu'à afficher « plan mode ».
Attention à un piège fréquent : sélectionner opusplan ne suffit pas. Il faut aussi activer le mode Plan pour que la bascule entre Opus et Sonnet ait lieu.
1.3. Implémenter à partir d'une session propre
Une fois la spécification terminée, lancez une nouvelle session pour la construire. L'implémentation part ainsi d'un contexte vierge, débarrassé des échanges du cadrage, avec un document écrit comme seule référence (deuxième volet, § 1.8).
Variante : séparer explicitement les deux phases
Si vous suivez le workflow SPEC.md sans opusplan, découpez le travail en deux sessions :
| Phase | Commande | Ce qui se passe |
| Cadrage | | interview avec AskUserQuestion, puis rédaction de SPEC.md |
| Implémentation | /clear puis /model sonnet | « Implémente @SPEC.md » |
Comme nous l’évoquions dans le deuxième volet (§ 1.4), face à une difficulté qui dépasse les capacités du modèle en cours, par exemple Sonnet, vous pouvez faire appel à un conseiller plus puissant grâce à l’Advisor Tool.
Ce qui fait une bonne spécification
Les meilleures spécifications :
- nomment les fichiers et interfaces concernés ;
- précisent ce qui est hors périmètre ;
- se terminent par une vérification de bout en bout prouvant que la fonctionnalité marche.
2. Faire évoluer son harnais au rythme des modèles
Un harnais n'est jamais terminé. Il est conçu pour un modèle donné, avec ses forces et ses faiblesses ; quand le modèle change, une partie du harnais perd sa raison d'être. Chaque nouvelle génération impose donc de le réexaminer, comme on revoit ses habitudes de travail avec un collaborateur qui a gagné en expérience.
La concurrence entre fournisseurs rend cette vigilance d'autant plus nécessaire : le rythme des sorties ne faiblit pas, et nul ne peut prédire quel acteur proposera demain les modèles les plus performants. Suivre les évolutions et les recommandations des fournisseurs (notes de version, guides de migration, nouvelles fonctionnalités de l'API) devient une partie intégrante de la maintenance du harnais. Concrètement, à chaque changement de modèle, quatre étapes.
2.1. Retirer avant d'ajouter
Le premier réflexe face à un nouveau modèle est souvent d'enrichir le harnais. Il faut faire l'inverse : tester d'abord une version allégée, sans les instructions générales, les étapes intermédiaires et les artefacts qui compensaient les limites du modèle précédent. Si le résultat ne se dégrade pas, ces éléments sont devenus superflus. Si un problème précis apparaît, on réintroduit uniquement ce qui le corrige.
Claude Code fournit trois commandes de diagnostic, complémentaires pour garder un harnais sain et sobre. Dans le terminal, claude doctor établit un bilan de l'installation sans rien modifier : installations multiples, état des mises à jour, fonctionnement de la recherche dans le code, configurations MCP ou raccourcis clavier invalides. Lancé dans une session interactive, /doctor va plus loin. Depuis la version 2.1.205, il réalise un audit complet de la configuration ; depuis la 2.1.206, il propose aussi d'alléger les fichiers CLAUDE.md en retirant ce que Claude peut déduire du code, et de déplacer les consignes chargées en permanence vers des skills ou des fichiers chargés à la demande. Il présente toujours ses constats et demande confirmation avant de modifier quoi que ce soit. Une précaution s'impose : ces commandes démarrent les serveurs MCP configurés, il ne faut donc les lancer que dans des répertoires de confiance.
Introduit en septembre 2026 avec la version 2.1.261, /skill-doctor cible un gaspillage plus discret : les compétences chargées mais jamais utilisées. Chaque skill présente dans la liste ajoute sa description au contexte à chaque requête, qu'elle serve ou non. La commande indique, pour chaque compétence de la session, si elle a été invoquée et ce qu'elle coûte en contexte, puis précise où la désactiver ; elle signale aussi les plugins inutilisés depuis un moment. Une limite toutefois : l'outil mesure l'usage, pas l'utilité. Une compétence rarement invoquée mais précieuse ressemble, dans le rapport, à un poids mort : c'est au lecteur de trancher.
2.2. Mesurer plutôt que supposer
L'intuition est un mauvais juge de l'efficacité d'un harnais.
Quelques indicateurs suffisent à objectiver la situation :
| Indicateur | Ce qu'il révèle |
| Tokens de sortie par tâche | le poids de la réflexion et de la génération, le poste le plus cher (premier volet, § 3.1) |
| Taux de réutilisation du cache | la stabilité du contexte (premier volet, § 3.3 ; deuxième volet, § 1.5) |
| Nombre de cycles par tâche | l'efficacité de l'outillage et de l'orchestration (deuxième volet, § 1.6) |
| Nombre de reprises et de corrections | la qualité des consignes et du contexte (premier volet, § 3.2 ; deuxième volet, § 1.7) |
Mesurés avant et après chaque changement, ces indicateurs montrent ce qu'il apporte réellement.
2.3. Réajuster l'effort et le modèle par activité
Les réglages d'effort (deuxième volet, § 1.3) et le choix des modèles (deuxième volet, § 1.4, et § 1.2 ci-dessus) ont été calibrés pour une génération donnée. Quand celle-ci change, l'équilibre change avec elle, de deux façons :
- le même modèle a besoin de moins d'effort : une tâche qui exigeait un effort élevé peut désormais réussir avec un effort moyen, voire faible ;
- un modèle moins cher devient suffisant : une activité confiée jusque-là à Opus peut passer à Sonnet sans perte de qualité.
Un exemple
Votre équipe avait réglé la génération de tests sur un effort élevé, car le modèle précédent oubliait trop souvent les cas limites. Avec la nouvelle génération, un effort moyen produit des tests tout aussi complets. Conserver l'ancien réglage, c'est payer des tokens de réflexion sans gain de qualité, et risquer le cercle vicieux décrit dans le deuxième volet (§ 1.3).
Comment revalider sans se fier aux impressions ?
Une impression se forme sur quelques cas marquants ; une évaluation repose sur un échantillon représentatif.
La démarche reste légère :
- constituer un jeu de tâches de référence : une dizaine de tâches réelles du projet par activité (story simple, refactoring, analyse d'anomalie…), dont le résultat attendu est connu ;
- les rejouer avec plusieurs réglages : par exemple l'effort actuel et le niveau inférieur, ou Opus et Sonnet ;
- comparer trois critères : le taux de réussite, les tokens consommés et le nombre de corrections nécessaires ;
- retenir le réglage le moins coûteux parmi ceux qui atteignent le niveau de qualité attendu.
Ce jeu de tâches se réutilise à chaque nouvelle génération : quelques heures d'évaluation suffisent alors à mettre à jour toute la grille de réglages.
2.4. Revoir l'outillage
Faute de mieux, beaucoup d'équipes ont construit leurs propres solutions pour pallier les limites des agents : un script qui filtre les outils à exposer, un agent chargé de résumer l'historique, une logique maison pour passer d'un modèle à l'autre. Ces solutions maison ont rendu service, mais elles ont un coût : il faut les maintenir, elles consomment souvent des tokens supplémentaires, et elles n'évoluent pas au rythme des modèles.
Or les fournisseurs intègrent régulièrement à leurs plateformes des mécanismes natifs qui font la même chose, mieux et moins cher. C'est un peu comme une extension que l'on maintenait soi-même pour son éditeur de code, jusqu'au jour où la fonctionnalité est intégrée en standard : la garder ne fait plus qu'ajouter de la complexité.
| Solution maison d'hier | Mécanisme natif aujourd'hui | Voir |
| Sélectionner à la main les outils exposés à l'agent | Tool Search et defer_loading | deuxième volet, § 1.2 |
| Router soi-même les questions difficiles vers un modèle plus puissant | Advisor Tool, alias opusplan | deuxième volet, § 1.4 ; § 1.2 ci-dessus |
| Relancer des requêtes pour garder le cache « chaud » | Cache d'une heure | deuxième volet, § 1.5 |
| Enchaîner des appels d'outils via un agent intermédiaire | Programmatic Tool Calling | deuxième volet, § 1.6 |
| Écrire un résumé de session ou purger les journaux à la main | Compaction et Context Editing | deuxième volet, § 1.8 |
3. Économiser des tokens : une approche globale
Pour clore ce dossier, il nous restait à dresser un bilan d’ensemble de la consommation de tokens. Un agent en consomme à trois niveaux. La sortie (réflexion, texte, appels d’outils) est le poste le plus cher ; l’entrée, c’est-à-dire le contexte relu à chaque requête, coûte peu tant qu’elle reste en cache ; enfin, le nombre de cycles démultiplie les deux premiers. Un levier efficace agit sur au moins l’un de ces niveaux : les leviers natifs de Claude Code couvrent les trois, tandis que les compétences externes portent surtout sur la sortie.
Parmi les compétences (skills) les plus populaires dans ce domaine, deux se distinguent, mais par des approches opposées.
- Ponytail fait raisonner l’agent comme un développeur senior « paresseux » : il réutilise le code existant et évite la sur-ingénierie. Le benchmark indépendant de JetBrains mesure environ −15 % de code et −10 % de coût, sans perte de qualité détectable (https://github.com/dietrichgebert/ponytail).
- Caveman, à l’inverse, agit sur la forme plutôt que sur le fond : il fait répondre l’agent dans un style télégraphique, sans articles ni formules superflues. Le même benchmark n’y mesure qu’environ −8,5 % d’économie, loin des −65 % annoncés et comparable à une simple consigne de concision (https://github.com/JuliusBrussee/caveman).
3.1. Classement des leviers, du plus efficace au plus ponctuel
Pour résumer l’essentiel, le tableau ci-dessous rassemble les principaux leviers d’économie, classés du plus efficace au plus ponctuel. Les six premiers sont intégrés à Claude Code et agissent sur la sortie, l’entrée ou le nombre de cycles.
Les deux derniers sont des compétences externes : elles ne portent que sur la sortie, et leurs gains mesurés restent modestes.
Pour chaque levier, le tableau indique ce qu’il réduit et dans quels cas y recourir.
Leviers d’économie de tokens, du plus efficace au plus ponctuel
| # | Levier | Type | Ce qu'il réduit | Quand l'utiliser |
| 1 | Effort adapté (/effort) | natif | toute la sortie : réflexion, texte, appels d'outils | en permanence ; medium par défaut, high pour les tâches complexes |
| 2 | Modèle adapté à la phase (opusplan, /advisor) | natif | le coût global : moins de reprises, Opus réservé aux décisions délicates | dès qu'une tâche mêle conception et exécution |
| 3 | Contexte stable (préfixe figé, cache d'une heure) | natif | l'entrée, relue à 5 % du prix | en permanence ; vérifier le taux de cache |
| 4 | Contexte initial léger (AGENTS.md concis, Tool Search) | natif | l'entrée à chaque requête et la dilution de l'attention | à la configuration du projet, puis à chaque revue du harnais |
| 5 | Outils de haut niveau (serveur de langage, scripts, codemods, sous-agents) | natif | le nombre de cycles | recherche dans le code, refactoring, calculs, exploration |
| 6 | Hygiène de session (/compact, /clear, /rewind) | natif | l'historique relu et les spirales de correction | en fin d'étape, au changement de sujet, après deux corrections infructueuses |
| 7 | Ponytail | externe | le code produit, donc la sortie | projets où l'agent tend à sur-construire ; gain mesuré par JetBrains : −10 % de coût |
| 8 | Caveman, ou une simple consigne de concision | externe | le texte des réponses uniquement | sessions longues et bavardes ; gain mesuré : environ −8,5 %, comparable à « sois bref » |
3.2. Ce qu'il faut retenir
Les leviers natifs pèsent bien plus lourd que les plugins. Régler l'effort, choisir le bon modèle ou stabiliser le contexte joue sur le coût total. Les compétences externes plafonnent autour de 10 % dans les tests indépendants, soit trois à huit fois moins que les chiffres annoncés.
Parmi les externes, mieux vaut agir sur le fond que sur la forme. Ponytail, qui évite d'écrire du code inutile, a montré une économie réelle sans perte de qualité détectable. Caveman, qui ne raccourcit que le texte, ne fait pas mieux qu'une consigne de concision et ajoute même des tokens d'entrée à chaque tour.
Toute compétence ajoutée entre dans le préfixe. Elle coûte à chaque requête et peut casser le cache si elle change : mieux vaut l'installer en début de projet qu'en cours de session.
3.3. Une proposition en trois niveaux
- Le socle, toujours : effort adapté, opusplan ou advisor, AGENTS.md concis, contexte stable, compaction en fin d'étape.
- Au cas par cas : serveur de langage pour les gros dépôts typés, scripts pour les calculs, sous-agents pour l'exploration, cache d'une heure pour les sessions entrecoupées de pauses.
- En option, après mesure : Ponytail si l'agent tend à sur-construire ; une consigne de concision dans AGENTS.md plutôt que Caveman.
Dans tous les cas, mesurez avant et après : /cost (avec une clé API), /context, le taux de réutilisation du cache, et les tableaux de bord intégrés aux plugins (/caveman-stats, bandeau Ponytail), et /skill-doctor pour repérer les compétences qui ne servent pas. Un levier qui ne se mesure pas ne se garde pas.
Conclusion : un harnais vivant, une pratique vivante
Travailler efficacement avec un agent de frontière ne dépend pas seulement de la qualité de son harnais. Cela dépend aussi de la façon dont on lui confie le travail. Le workflow présenté ici tient en trois gestes :
- laisser l'agent extraire le besoin plutôt que le rédiger seul,
- réserver le modèle le plus capable aux décisions difficiles, et
- implémenter à partir d'un contexte propre, adossé à une spécification écrite.
Ces gestes ne sont pas figés pour autant. Les modèles évoluent vite, et ce qui est aujourd'hui un bon réglage deviendra demain une habitude héritée. D'où la seconde partie de cet épilogue :
- retirer avant d'ajouter, mesurer plutôt que supposer,
- revalider l'effort et le modèle sur un jeu de tâches de référence, et
- abandonner les solutions maison dès qu'un mécanisme natif fait aussi bien.
Enfin, la troisième partie rassemble ces leviers en une approche globale de l'économie de tokens. Les leviers natifs (effort adapté, modèle choisi selon la phase, contexte stable et léger) y pèsent bien plus lourd que les compétences externes, dont les gains réels plafonnent autour de 10 % dans les tests indépendants, loin des chiffres annoncés. Parmi ces dernières, celles qui évitent d'écrire du code inutile valent mieux que celles qui raccourcissent seulement le texte. Et dans tous les cas, un levier qui ne se mesure pas ne se garde pas.
Au terme de cette série, un fil relie les deux volets et cet épilogue. Le premier a montré pourquoi les bonnes pratiques d'hier coûtent cher aujourd'hui. Le deuxième a proposé de désapprendre huit réflexes hérités. Cet épilogue a montré comment travailler au quotidien, comment rester à jour, et comment dépenser chaque token à bon escient. La leçon commune est simple : un harnais, comme la façon de s'en servir, n'est jamais terminé. Il s'entretient au même rythme que les modèles qu'il encadre.
Références
- Premier volet : Harnais agentiques (1/2) — Pourquoi les bonnes pratiques d'hier coûtent cher aujourd'hui
- Second volet : Harnais agentiques (2/2) : huit réflexes à désapprendre pour un harnais frugal
- AskUserQuestion : Comportement de l’outil AskUserQuestion
- Voice dictation with Claude Code : Speak your prompts in the Claude Code CLI
Remerciement
Cette série en trois parties est née d’un texte de plus de trente pages, dont la longueur rendait la relecture difficile et le fil parfois délicat à suivre.
Je tiens à remercier Godefroy Clair et Florian Enoh pour leurs commentaires et leurs conseils avisés tout au long de cette série.