Harnais agentiques (2/2) : huit réflexes à désapprendre pour un harnais frugal
Harnais agentiques (2/2) : huit réflexes à désapprendre pour un harnais frugal
Second volet d'une série en deux parties, suivie d'un épilogue. Premier volet : « Pourquoi les bonnes pratiques d'hier coûtent cher aujourd'hui ». Épilogue : « Travailler au quotidien avec un agent de frontière ».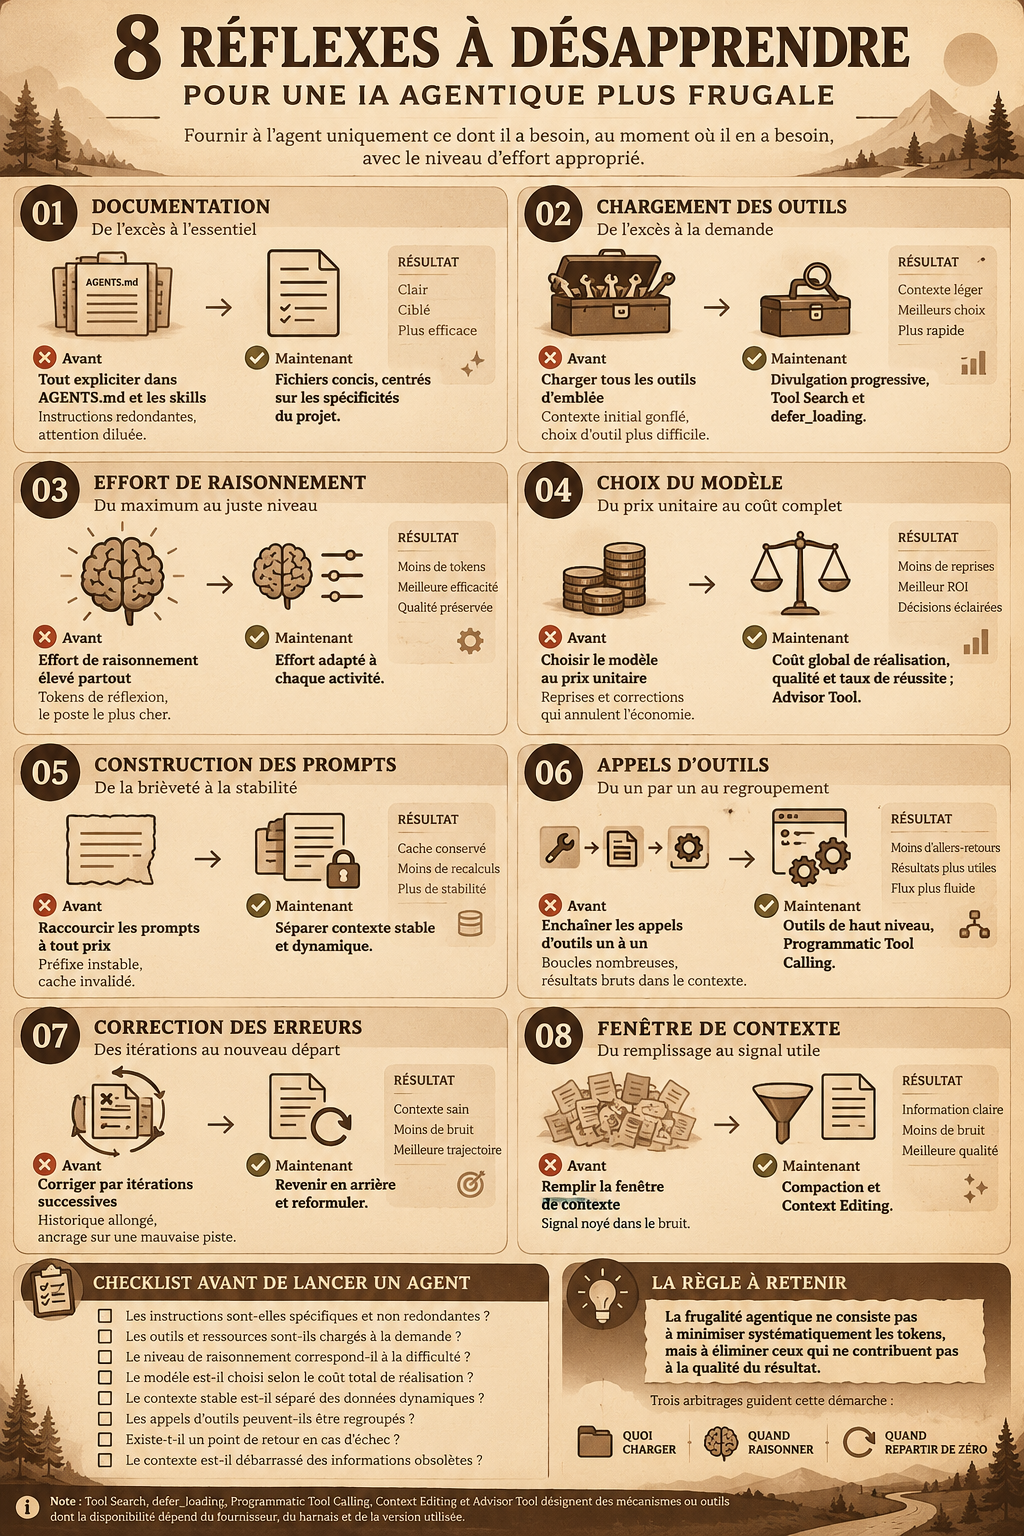
Ce volet traite d'un sujet délicat : désapprendre. Se défaire d'un savoir demande souvent plus d'effort que d'en acquérir un nouveau, car il faut d'abord admettre que ce qui fonctionnait hier ne fonctionne plus. Le harnais que nous avions patiemment construit ne faisait en réalité que refléter les capacités du modèle de l'époque.
Les exemples s'appuient sur Claude Code 2.1.291 et les modèles Claude Opus 5.5 et Sonnet 5.5, mais les principes valent quels que soient l'agent et le fournisseur.
Table des matières
- Huit réflexes hérités à désapprendre
- 1.1. Des instructions concises plutôt que exhaustives
- 1.2. Charger au bon moment plutôt que tout charger
- 1.3. Un effort adapté plutôt qu'un effort maximal
- 1.4. Raisonner en coût global plutôt qu'en prix unitaire
- 1.5. Stabiliser plutôt que raccourcir
- 1.6. Des opérations de haut niveau plutôt que des boucles
- 1.7. Repartir proprement plutôt que corriger en boucle
- 1.8. Entretenir le contexte plutôt que le remplir
Conclusion : la frugalité comme discipline
1. Huit réflexes hérités à désapprendre
À chaque réflexe hérité correspond aujourd'hui une pratique plus sobre. Le tableau les met en regard ; chaque ligne est ensuite détaillée.
| Réflexe hérité | Pourquoi il coûte aujourd'hui | Ce qui le remplace |
| 1. Tout expliciter dans AGENTS.md et les skills | instructions redondantes, attention diluée | fichiers concis, centrés sur les spécificités du projet |
| 2. Charger tous les outils d'emblée (pris en charge par la version 2.1.7) | contexte initial gonflé, choix d'outil plus difficile | divulgation progressive, Tool Search |
| 3. Effort de raisonnement élevé partout | tokens de réflexion, le poste le plus cher | effort adapté à chaque activité |
| 4. Choisir le modèle au prix unitaire | reprises et corrections qui annulent l'économie | coût global de réalisation, Advisor Tool |
| 5. Raccourcir les prompts à tout prix | préfixe instable, cache invalidé | séparer contexte stable et dynamique |
| 6. Enchaîner les appels d'outils un à un | boucles nombreuses, résultats bruts dans le contexte | outils de haut niveau, scripts déterministes |
| 7. Corriger par itérations successives | historique allongé, ancrage sur une mauvaise piste | revenir en arrière et reformuler |
| 8. Remplir la fenêtre de contexte | signal noyé dans le bruit | compaction et Context Editing |
1.1. Des instructions concises plutôt qu'exhaustives
Réflexe hérité n° 1 : tout expliciter dans AGENTS.md et les skills
Un modèle récent connaît déjà les bonnes pratiques générales du développement : fonctions courtes, noms clairs, tests, absence de duplication. Les lui rappeler ne lui apprend rien ; ces lignes occupent du contexte à chaque requête et diluent son attention. Un bon AGENTS.md se concentre sur ce que le modèle ne peut pas deviner en lisant le code : les conventions du projet, les contraintes d'architecture, les règles de sécurité, les commandes importantes et les décisions structurantes, avec leurs raisons.
Pour trier, une question suffit : un développeur expérimenté arrivant sur le projet aurait-il besoin qu'on le lui dise ?
| À retirer | À conserver |
| Écris du code propre et lisible. | Les montants sont toujours stockés en centimes, jamais en décimaux. |
| Ajoute des tests pour ton code. | Lancer les tests avec make test-unit ; les tests d'intégration nécessitent Docker. |
| Respecte les principes SOLID. | Le module billing ne doit jamais appeler directement la base users : passer par l'API interne. |
Les skills suivent la même logique. Leur description, toujours visible par l'agent, reste courte : à quoi sert le skill et quand l'utiliser. Les procédures, exemples et scripts sont placés dans des fichiers séparés, chargés seulement à l'usage. Les instructions permanentes sont payées, et lues, à chaque requête : elles doivent mériter leur place.
1.2. Charger au bon moment plutôt que tout charger
Réflexe hérité n° 2 : charger tous les outils d'emblée
La divulgation progressive (Progressive Disclosure) consiste à ne donner à l'agent, au départ, que le minimum : de quoi comprendre sa mission et savoir où trouver le reste. Comme dans une bibliothèque, on consulte le catalogue avant d'aller chercher les ouvrages utiles.
Chaque outil connecté apporte sa définition, qui occupe du contexte même s'il n'est jamais utilisé. Dans l'article d'Anthropic Introducing advanced tool use on the Claude Developer Platform, cinq serveurs MCP (GitHub, Slack, Sentry, Grafana, Splunk) totalisent 58 outils et environ 55 000 tokens de définitions avant même le premier message. Avec le Tool Search Tool et le paramètre defer_loading, les différents outils différés ne sont pas chargés : l'agent ne voit que l'outil de recherche et quelques outils actifs, puis charge ceux dont il a besoin.
| Tout charger | Tool Search + defer_loading | |
| Au démarrage | toutes les définitions (~72 000 tokens) | l'outil de recherche (~500 tokens) |
| En cours de tâche | — | 3 à 5 outils utiles (~3 000 tokens) |
| Total | ~77 000 tokens | ~8 700 tokens |
L'article rapporte une réduction d'environ 85 % des tokens consommés. Avec moins d'outils visibles, l'agent choisit aussi plus souvent le bon (premier volet, § 3.2), et les outils différés, absents du préfixe initial, ne cassent pas le cache (premier volet, § 3.3).
Dans Claude Code, Tool Search est apparu avec la version 2.1.7. À l’origine, les outils MCP n’étaient différés que lorsque leurs descriptions dépassaient 10 % de la fenêtre de contexte. Ils le sont désormais par défaut, et l’agent les découvre au moment où il en a besoin ; la variable d’environnement ENABLE_TOOL_SEARCH permet de modifier ce comportement. Si vous construisez votre propre agent sur l’API, gardez chargés en permanence les trois à cinq outils les plus utilisés et différez les autres. En dessous d’une dizaine d’outils, en revanche, le mécanisme n’est guère utile : l’étape de recherche ajoute de la latence pour un gain limité.
1.3. Un effort adapté plutôt qu'un effort maximal
Réflexe hérité n° 3 : un effort de raisonnement élevé partout
Les niveaux d'effort (low, medium, high, xhigh, max) influencent la réflexion interne, mais aussi le nombre d'appels d'outils, la profondeur d'analyse et la longueur des réponses.
Quelques points de départ, à ajuster par des évaluations sur le projet :
| Effort | Activités |
| High | analyse métier, conception architecturale, anomalie complexe |
| Medium à High | décomposition en stories |
| Medium | développement d'une story bien spécifiée |
| Low à Medium | refactoring mécanique, tests simples, vérification de conformité selon le risque |
Ce tableau illustre une manière possible de répartir l’effort selon les activités ; il ne s’agit pas d’une recommandation officielle.
Face à un mauvais résultat, augmenter l'effort est souvent une erreur : le problème vient plus souvent d'un contexte incomplet, d'une spécification ambiguë ou d'un mauvais outil. Et trop réfléchir peut nuire. Des chercheurs du programme Anthropic Fellows ont montré que, sur certaines tâches, allonger le raisonnement fait baisser la précision (Inverse Scaling in Test-Time Compute) ; un contexte encombré rend en outre le modèle moins fiable (Context Rot, Chroma).
S'installe alors un cercle vicieux : on relève l'effort, l'historique se remplit de pistes abandonnées, le modèle se trompe davantage, et l'on relève encore l'effort. L'excès inverse n'est pas meilleur : un effort trop faible sur une tâche complexe entraîne des cycles de correction. Le bon niveau est celui qui donne un résultat satisfaisant au coût total le plus faible.
1.4. Raisonner en coût global plutôt qu'en prix unitaire
Réflexe hérité n° 4 : choisir le modèle au prix unitaire
On ne paie pas un token, on paie une tâche terminée. Le coût global de réalisation additionne les tokens de toutes les tentatives, la réflexion et les appels d'outils, l'historique relu à chaque reprise, et le temps humain passé à relire et relancer, souvent le poste le plus cher.
Prenons une tâche de difficulté moyenne, avec les tarifs par million de tokens de Sonnet 5.5 (2 $ en entrée, 10 $ en sortie) et d'Opus 5.5 (4 $ / 20 $). Pour simplifier, le cache est ignoré et les volumes sont illustratifs.
| Sonnet 5.5 | Opus 5.5, effort faible | |
| Tentatives | trois (150 k, 200 k puis 250 k tokens en entrée, 15 k en sortie à chaque fois) | une seule (150 k en entrée, 8 k en sortie) |
| Coût global | 1,65 $, plus trois relectures humaines | 0,76 $, plus une relecture |
Le modèle deux fois moins cher au token revient ici deux fois plus cher à la tâche. Sur une tâche simple, le raisonnement s'inverse : si Sonnet réussit du premier coup, il coûte 0,45 $. Aucun modèle n'est économique dans l'absolu ; il l'est pour une tâche donnée.
Advisor Tool évite de choisir une fois pour toutes. Comme un développeur qui sollicite l'architecte senior sur une question épineuse puis se remet au travail, un exécutant économique (Sonnet, Haiku) réalise la tâche et ne consulte un conseiller plus puissant (Opus) que face à une difficulté réelle. On ne paie le prix fort qu'au moment où cela en vaut la peine ; plafonner le conseiller à max_tokens: 2048 est un bon point de départ.
Prenons la story « Permettre aux clients d'annuler une commande tant qu'elle n'est pas expédiée, avec remboursement automatique ». Sonnet ajoute seul le bouton et la route d'API. Il bute ensuite sur une vraie question : que se passe-t-il si le client annule au moment précis où l'entrepôt valide l'expédition ? Il consulte Opus, qui recommande en quelques lignes de verrouiller la commande pendant le changement de statut, de n'accepter l'annulation qu'au statut « en préparation » et de ne rembourser qu'après confirmation. Sonnet implémente, puis écrit les tests, dont celui des deux actions simultanées. Opus n'est intervenu qu'une fois, sur le seul point délicat.
Dans Claude Code, une ligne suffit pour l'activer :
/advisor opus # pendant une session (choix mémorisé)
claude --advisor opus # pour une seule session, au lancement
{ "advisorModel": "opus" } # dans settings.json, par défaut
L’exécutant consulte le conseiller quand il le juge utile, mais vous pouvez aussi le demander dans votre consigne (« consulte l’advisor avant de continuer ») ; /advisor off le désactive. Points d’attention : le conseiller doit être au moins aussi capable que l’exécutant, chaque consultation est facturée à son tarif, et avec Opus 5.5 votre application ne peut pas afficher le conseil. Au 21 octobre 2026, l’outil est en bêta sur l’API Claude et Claude Platform on AWS (dans Claude Code, via l’API Anthropic uniquement), mais absent d’Amazon Bedrock, de Google Cloud et de Microsoft Foundry.
Comprendre le cache de prompt, c'est se donner les moyens de saisir ce qui a réellement changé entre deux générations de modèles, par exemple entre Opus 4.6 et Opus 5.5.
Le cache repose sur une notion simple : le préfixe. À chaque requête, l’agent renvoie au modèle tout son contexte, toujours dans le même ordre : outils, instructions système (dont AGENTS.md), puis historique. Le préfixe est la partie initiale de cette séquence restée identique, au token près, depuis la requête précédente. Le modèle le relit depuis le cache pour une fraction du prix (5 % du tarif d’entrée sur Opus 5.5). Au premier token qui diffère, la comparaison s’arrête et tout ce qui suit est retraité au plein tarif.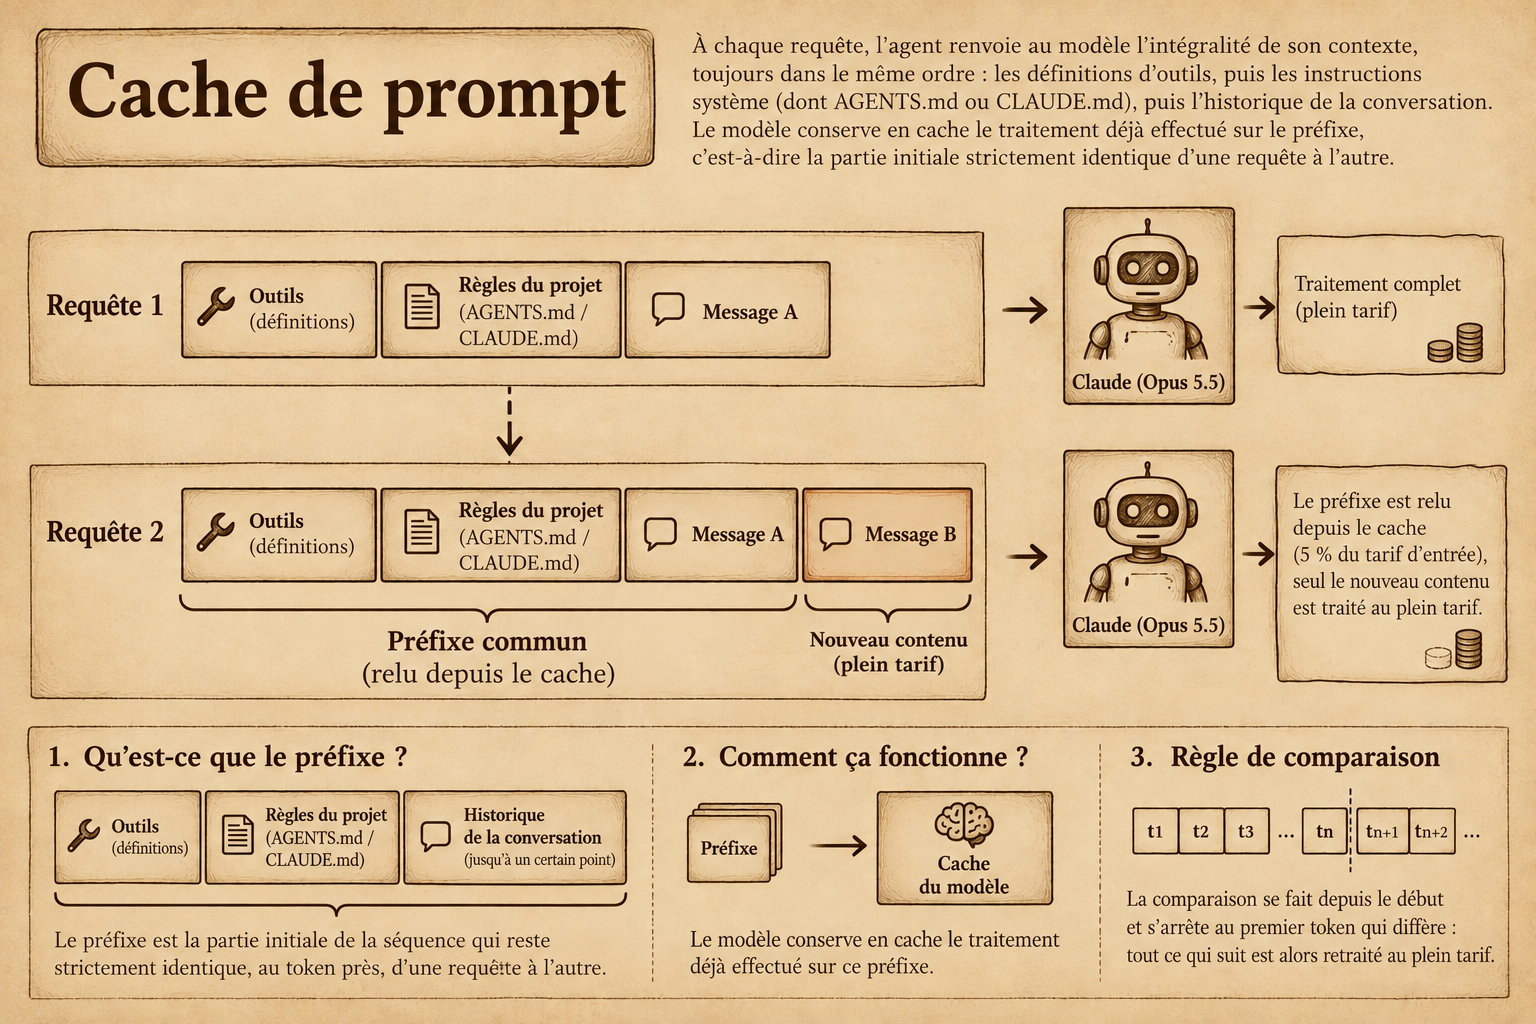
L’ordre compte donc plus que la longueur : une date en tête des instructions système suffit à faire refacturer, à chaque requête, des milliers de tokens de règles inchangées.
Encore faut-il que le préfixe soit assez long. En dessous d’un seuil propre à chaque modèle, rien n’est mis en cache, sans message d’erreur. Ce seuil est passé de 4 096 tokens pour Opus 4.6 et de 2 048 pour Sonnet 4.6 à 512 pour Opus 5.5 et Sonnet 5.5. Un harnais sobre de 3 000 tokens, payé au plein tarif avec Opus 4.6 tant que l’historique restait court, est désormais mis en cache dès la première requête. Un harnais court n’a donc plus besoin de grossir : il lui suffit de rester stable.
1.5. Stabiliser plutôt que raccourcir
Réflexe hérité n° 5 : raccourcir les prompts à tout prix
Les harnais d'hier cherchaient à réduire la taille des prompts. Avec le cache, un long contexte relu coûte peu (premier volet, § 3.1) ; ce qui coûte cher, c'est un contexte qui change (premier volet, § 3.3). L'objectif n'est donc plus un prompt court, mais un prompt stable, organisé en deux zones :
| Zone | Contenu | Règle |
| Contexte stable (en tête) | définitions d'outils, règles de développement, conventions d'architecture | figé pendant toute la session |
| Contexte dynamique (à la suite) | story en cours, résultats d'analyse, décisions récentes, date du jour | ajouté en fin de requête |
Dans Claude Code, cela se traduit par trois réflexes :
- garder CLAUDE.md ou AGENTS.md stable : n'y inscrivez ni la story en cours ni l'avancement du sprint ; ces éléments vont dans votre message ou dans un fichier référencé (« Implémente @SPEC.md ») ;
- éviter de modifier les outils chargés en permanence en cours de session : ils sont en tête du préfixe. Les outils MCP différés par Tool Search, eux, n'invalident pas le cache ;
- éviter de changer de modèle en cours de session : chaque modèle a son propre cache.
Choisir la bonne durée de conservation. Écrire en cache coûte un peu plus cher qu'une entrée ordinaire ; relire coûte vingt fois moins cher. Sur Opus 5.5 :
| Opération | Tarif | Pour 100 000 tokens |
| Entrée ordinaire | 4 $/M | 0,40 $ |
| Écriture en cache, 5 minutes | 1,25 × l'entrée, soit 5 $/M | 0,50 $ |
| Écriture en cache, 1 heure | 2 × l'entrée, soit 8 $/M | 0,80 $ |
| Lecture depuis le cache | 5 % de l'entrée, soit 0,20 $/M | 0,02 $ |
Cinq minutes conviennent aux échanges rapprochés ; une heure, aux sessions entrecoupées d'attentes (relecture, tests longs, réunion). Si deux requêtes sont séparées de plus de cinq minutes, la conservation courte oblige à réécrire le cache : 2,5 fois le prix d'entrée, contre 2,05 fois avec une conservation d'une heure. Une seule réutilisation après une pause suffit à rentabiliser la durée longue.
Dans Claude Code, le cache est actif par défaut et expire après cinq minutes d'inactivité. Trois variables d'environnement permettent d'ajuster ce comportement :
| Variable | Effet |
| ENABLE_PROMPT_CACHING_1H=1 | porte la durée à une heure (clé API, Bedrock, Vertex AI, Microsoft Foundry) ; remplace ENABLE_PROMPT_CACHING_1H_BEDROCK, dépréciée |
| FORCE_PROMPT_CACHING_5M=1 | impose cinq minutes, pour comparer ou diagnostiquer |
| DISABLE_PROMPT_CACHING=1 | désactive le cache, pour le diagnostic uniquement |
Pour l'appliquer à toutes les sessions, placez la variable dans le bloc env de ~/.claude/settings.json ; dans une organisation, elle peut aussi être imposée via les paramètres gérés :
{
  "env": {
    "ENABLE_PROMPT_CACHING_1H": "1"
  }
}
Mesurer plutôt que supposer. Pour chaque requête, mesurez la répartition des tokens entre ceux écrits dans le cache, relus depuis le cache et traités sans mise en cache. Surveillez le taux de réutilisation du cache, la fréquence de ses invalidations et leurs causes : présence d’un horodatage dans le prompt, ajout dynamique d’un outil en cours de session, variation de l’ordre de chargement des éléments du contexte, etc.
Une chute brutale du taux de réutilisation constitue souvent le premier signal d’alerte : une modification apparemment anodine du harnais peut avoir rompu la stabilité du préfixe et entraîné un retraitement coûteux de tokens jusque-là réutilisés.
1.6. Des opérations de haut niveau plutôt que des boucles
Réflexe hérité n° 6 : enchaîner les appels d'outils un à un
Un agent travaille par cycles : analyser, choisir une action, appeler un outil, lire le résultat, décider de la suite. Chaque cycle consomme de la réflexion et ajoute son résultat au contexte : une tâche en trente cycles coûte bien plus cher qu'en trois, pour un résultat identique. La parade consiste à donner à l'agent des outils capables d'accomplir en un appel ce qui en demanderait sinon des dizaines :
| Approche bas niveau | Approche haut niveau | Gain |
| une série de find et grep pour retrouver les usages d'une fonction | un serveur de langage (LSP) qui renvoie directement les références | moins d'appels, résultat exact |
| une modification fichier par fichier pour renommer un élément | un refactoring structuré appliqué en une opération | cohérence garantie |
| un calcul « de tête » par le modèle | un script déterministe | résultat fiable et reproductible |
Un serveur de langage est un programme qui comprend le code d'un langage donné, via le Language Server Protocol (LSP) créé par Microsoft en 2016 : c'est lui qui se cache derrière « aller à la définition » ou « trouver les références » dans l'IDE. Là où grep recherche du texte, il analyse la structure du code.
Trois exemples illustrent l'écart :
- Retrouver les usages d'une fonction. Dans un dépôt de 2 000 fichiers, grep renvoie 140 correspondances pour calculerRemise() : vrais appels, commentaires, chaînes de caractères, méthode homonyme. Faire le tri coûte une dizaine de cycles. Le serveur de langage renvoie directement les 23 appels réels, en un seul appel.
- Renommer un élément. Renommer la classe Client en Customer dans soixante fichiers, fichier par fichier, multiplie les cycles et les risques d'oubli. Un outil de refactoring structuré (celui de l'IDE, ou un codemod comme OpenRewrite en Java ou jscodeshift en JavaScript) le fait en une opération ; l'agent n'a plus qu'à lancer les tests.
- Vérifier un calcul. Additionner « de tête » les 250 lignes d'un relevé est exactement le type de tâche où un modèle peut se tromper sans s'en rendre compte. Un script de trois lignes donne un résultat exact et reproductible :
import pandas as pd
releve = pd.read_csv("releve.csv")
print(round(releve["montant"].sum(), 2))
Ces outils économisent des tokens, mais leur principal atout est ailleurs : ils rendent le résultat plus fiable.
1.7. Repartir proprement plutôt que corriger en boucle
Réflexe hérité n° 7 : corriger par itérations successives
Face à un résultat incorrect, le réflexe naturel est de signaler l'erreur, puis la suivante, puis encore la suivante. Cette méthode a deux effets pervers. L'historique s'allonge et se remplit de tentatives ratées, qui diluent l'attention du modèle (premier volet, § 3.2). Et l'agent reste ancré dans son choix initial : s'il est parti d'une mauvaise hypothèse, il empile des rustines sur une base fragile au lieu de la remettre en cause. Comme sur un itinéraire mal engagé, multiplier les détours coûte souvent plus cher que de faire demi-tour.
Il est souvent plus efficace de revenir à un état antérieur (commit git, point de sauvegarde, retour en arrière dans la conversation), d'expliciter ce qui n'a pas fonctionné, puis de reformuler la demande en intégrant cet enseignement. L'agent repart avec un contexte propre et une consigne plus précise ; le premier essai n'est pas perdu, il a révélé ce que la demande initiale ne disait pas.
| Situation | Approche recommandée |
| Erreur clairement identifiée et circonscrite (faute de frappe, cas limite oublié) | corriger localement |
| Erreur qui révèle un malentendu ou une mauvaise hypothèse de départ | revenir en arrière et reformuler |
| Deuxième ou troisième correction sur le même sujet sans amélioration nette | revenir en arrière et reformuler |
Un bon signal d'alerte : si l'on se surprend à corriger les corrections, le problème est en amont.
1.8. Entretenir le contexte plutôt que le remplir
Réflexe hérité n° 8 : remplir la fenêtre de contexte
Une grande fenêtre de contexte permet de tout conserver, mais ce n'est pas souhaitable : plus l'historique s'allonge, plus l'essentiel se noie dans les échanges secondaires et les résultats périmés (premier volet, § 3.2). Le contexte s'entretient comme un espace de travail, grâce à deux mécanismes.
La compaction : résumer l'historique. Elle remplace l'historique par une synthèse des objectifs, décisions et résultats importants : le compte rendu d'une réunion plutôt que sa transcription. Claude Code compacte automatiquement à l'approche de la limite, souvent en pleine tâche.
Mieux vaut lancer soi-même /compact à la fin d'une étape, en précisant quoi garder (« /compact concentre-toi sur le bug d'authentification »), ou /clear si la tâche suivante n'a rien à voir. Le CLAUDE.md racine survit à la compaction, mais pas forcément les détails de la conversation. Mieux vaut donc consigner les décisions structurantes dans des artefacts explicites (spécification, décisions d'architecture).
Avec l’API, le Context Editing s’active via la stratégie clear_tool_uses, en fixant un seuil au-delà duquel les résultats d’outils les plus anciens sont retirés. Plutôt que de tout résumer, ce mécanisme supprime de façon ciblée les résultats d'outils devenus inutiles. L'agent garde la trace de ce qu'il a fait (« j'ai lancé les tests »), mais le contenu brut est remplacé par une mention courte. Exemple : un agent corrige un test en échec. Claude Code applique un mécanisme comparable de façon automatique.
| Étape | Résultat d'outil | Taille | Encore utile ? |
| Lancer la suite de tests | journal complet, 1 test en échec | ~8 000 tokens | non : l'erreur est identifiée |
| Rechercher la fonction fautive | 40 correspondances grep | ~4 000 tokens | non : la bonne a été trouvée |
| Lire trois fichiers | contenu intégral | ~15 000 tokens | non : deux ont été modifiés |
| Relancer les tests | tous les tests passent | ~2 000 tokens | oui : preuve que la correction fonctionne |
Une fois la correction validée, près de 27 000 tokens périmés restent dans l’historique et sont relus à chaque requête, au risque que le modèle se fie à l’ancienne version d’un fichier. Le Context Editing retire les trois premiers résultats et garde le dernier. Claude Code le fait automatiquement ; avec l’API, on fixe un seuil au-delà duquel les résultats d’outils les plus anciens sont retirés.
Attention au cache. Supprimer un élément du contexte modifie le préfixe à partir de cet endroit (premier volet, § 3.3) : tout ce qui suit est retraité au plein tarif à la requête suivante. L’opération n’est rentable que si le volume retiré est important et que la session se prolonge ; retirer quelques lignes d’un long historique peut coûter plus cher que de les laisser. Mieux vaut donc compacter une fois une fonctionnalité achevée, et avant une pause, tant que le cache est chaud. La suite démarre alors avec un contexte allégé, et la réécriture du cache n’est payée qu’une fois.
Conclusion : la frugalité comme discipline
Le harnais agentique n’est pas un simple emballage autour du modèle : il conditionne ce que l’on paie et ce que l’on obtient. Tout expliciter, tout charger d’emblée, pousser l’effort au maximum, raccourcir les prompts : ces réflexes de prudence compensaient les limites des modèles d’alors. Appliqués aux modèles actuels, ils font payer plus cher un résultat qui n’est pas meilleur, parfois moins bon. Bonne nouvelle : la plupart des leviers se trouvent dans le harnais lui-même.
La frugalité n’est pas du rationnement : elle consiste à placer chaque token là où il sert. Trois principes traversent les huit réflexes :
- stable plutôt que court : avec le cache, la stabilité d’un contexte compte plus que sa longueur ;
- au bon moment plutôt que tout, tout de suite : ne laisser sous les yeux du modèle que ce dont il a besoin maintenant ;
- le coût global plutôt que le prix unitaire : viser un résultat accepté au coût total le plus bas, temps humain compris.
Pourquoi parler de discipline ? Parce que la frugalité s’érode d’elle-même. Un serveur MCP ajouté « pour essayer », une ligne glissée dans AGENTS.md après un incident, un horodatage en tête de prompt : chaque ajout paraît anodin, mais leur accumulation alourdit le harnais. D’où trois habitudes à cultiver : mesurer plutôt que supposer, réévaluer la pertinence de chaque règle à chaque nouvelle génération de modèles et traiter le harnais comme du code, versionné, relu et régulièrement allégé. Les propositions présentées dans ce volet vont de simples commandes à des ajustements de configuration, voire à des appels d’API. Autant de pistes à explorer dès aujourd’hui pour améliorer votre harnais
Références
- Premier volet : Harnais agentiques (1/2) — Pourquoi les bonnes pratiques d'hier coûtent cher aujourd'hui
- Introducing advanced tool use on the Claude Developer Platform, Anthropic
- Advisor tool — documentation API · Advisor — documentation Claude Code
- Inverse Scaling in Test-Time Compute, Anthropic Fellows Program
- Context Rot: How Increasing Input Tokens Impacts LLM Performance, Chroma