Harnais agentiques (1/2) : pourquoi les bonnes pratiques d'hier coûtent cher aujourd'hui
Harnais agentiques (1/2) : pourquoi les bonnes pratiques d'hier coûtent cher aujourd'hui
Premier volet d'une série en deux parties. Second volet : « Huit réflexes à désapprendre pour un harnais frugal ».
Table des matières
- 1. Le harnais d'hier : miroir de nos modèles fragiles
- 2. Pourquoi il devient inutile : les modèles ont rattrapé le harnais
- 3. Pourquoi il devient contre-productif : l'économie des tokens a changé
- Ce qu'il faut retenir
- Annexe : tarifs des modèles Anthropic
Un agent de codage ne se résume pas au modèle qui l'anime. Le modèle de langage en est le moteur, mais il ne travaille jamais seul : il est intégré dans un harnais, c'est-à-dire l'ensemble des instructions, outils, règles, étapes d'orchestration et mécanismes de contrôle qui encadrent son travail. Ce harnais a un double rôle :
- donner au modèle les moyens d'agir sur son environnement ;
- compenser ce qu'il ne sait pas encore faire seul.
Pour comprendre pourquoi les agents changent de comportement d’une génération à l’autre, il faut regarder au-delà du modèle qui les anime.
Leur performance ne repose pas uniquement sur la puissance du modèle de langage, mais aussi sur l’architecture interne qui l’entoure : le harnais agentique. Comprendre ses composants, leurs interactions et leurs mécanismes d’orchestration est indispensable pour saisir les évolutions observées, expliquer leurs effets sur la qualité des résultats et identifier les nouvelles possibilités d’optimisation.
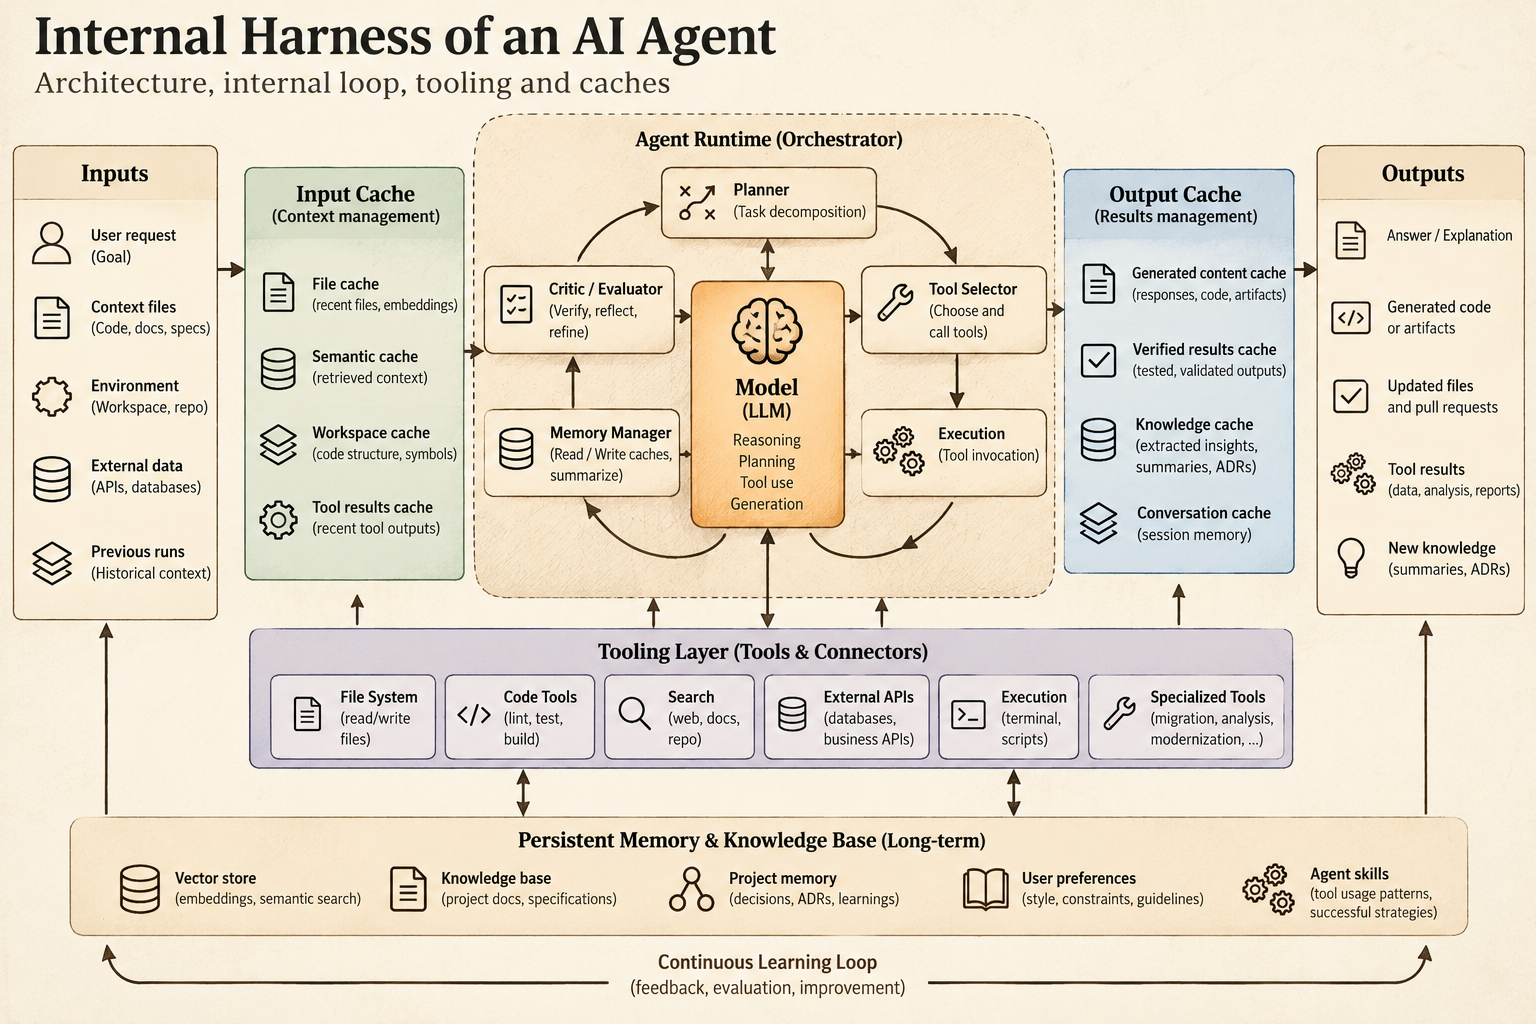
Le schéma ci-dessus illustre les principaux composants de l'architecture interne d'un agent de développement : les caches en entrée et en sortie, le modèle de langage (LLM), la boucle de décision et d'exécution, les mécanismes d'orchestration ainsi que l'outillage associé.
L'ensemble de ces composants constitue le harnais agentique. Leur conception, leur orchestration et leurs interactions influencent directement la qualité des résultats obtenus, les performances de l'agent et son efficacité en matière de consommation de tokens.
Cette distinction est souvent négligée. On attribue fréquemment au modèle des performances observées à travers un agent particulier, alors qu'un même modèle peut produire des résultats sensiblement différents selon le harnais dans lequel il est intégré. C'est un peu comme juger un moteur à la performance d'une voiture : la boîte de vitesses, les pneus et le réglage du châssis comptent autant que la puissance brute.
La performance d'une solution agentique ne dépend pas uniquement de la puissance du modèle, mais de l'efficacité de l'ensemble du système qui l'entoure.
Or les modèles progressent vite. Portés par une concurrence féroce, les fournisseurs de frontier models repoussent sans cesse les limites de la performance, et chaque version change le comportement des agents. Résultat : un harnais conçu il y a six mois impose des garde-fous à des modèles qui n'en ont plus besoin. Instructions redondantes, contexte surchargé, orchestration excessive : ce qui compensait hier leurs faiblesses devient aujourd'hui source de coûts, de bruit, voire d'erreurs.
Le défi n'est plus seulement d'optimiser son harnais, mais de le faire évoluer au rythme des modèles, sans traîner la complexité héritée des générations précédentes.
Ce sujet est traité en deux articles. Ce premier volet pose le diagnostic : il rappelle à quoi servaient ces mécanismes, puis explique pourquoi ils deviennent inutiles, et enfin pourquoi ils deviennent contre-productifs. Le second volet passe à la pratique : huit réflexes hérités à désapprendre, et la manière de faire évoluer son harnais dans la durée. L'ensemble est abordé sous trois angles :
- économique : ce qui génère réellement les coûts ;
- technique : la gestion du contexte, la génération et l'outillage ;
- méthodologique : l'organisation du travail des agents.
Les exemples s'appuient sur l'agent Claude Code 2.1.291, associé aux modèles Claude Opus 5.5 et Claude Sonnet 5.5, qui occupent en octobre 2026 les premières places de plusieurs classements de référence pour le code. Les principes présentés restent toutefois valables quels que soient l'agent et le fournisseur.
1. Le harnais d'hier : miroir de nos modèles fragiles
Qu'est-ce qu'un harnais ? C'est tout ce qui entoure le modèle d'IA pour l'aider à travailler. Le modèle, lui, pense : il comprend la demande, raisonne et décide. Pour compléter ses connaissances, il se nourrit d'artefacts — définitions d'agents, skills, règles du projet — qui lui apprennent les spécificités du contexte. Et lorsqu'il ne sait pas faire lui-même, il délègue à l'outillage : exécuter du code, chercher dans un dépôt, lancer des tests, interroger un service.
Imaginez un artisan spécialisé qui rejoint une nouvelle entreprise. Il sait déjà raisonner et maîtriser son métier ; il consulte le guide interne pour connaître les usages de la maison, et utilise les outils de l'atelier pour ce qu'il ne peut pas faire à mains nues. Le harnais, c'est ce guide interne et cet atelier.
Pourquoi l'a-t-on rendu si lourd ? Il y a encore six mois, les modèles ressemblaient à un stagiaire brillant mais débutant : sans consignes très précises, ils se trompaient, oubliaient des règles ou partaient dans la mauvaise direction. On a donc construit des harnais qui les tenaient par la main, comme les petites roues d'un vélo d'enfant.
Cela a donné naissance à six habitudes, considérées à l'époque comme de bonnes pratiques :
- Tout expliquer : rédiger de longs fichiers de consignes (comme AGENTS.md), y compris des règles de développement que tout bon développeur connaît déjà.
- Tout fournir dès le départ : donner au modèle tous les outils et tous les documents d'un coup, « au cas où ».
- Toujours le faire réfléchir au maximum : lui demander une réflexion approfondie, même pour une tâche simple comme renommer une variable.
- Le guider étape par étape : découper chaque tâche en nombreuses petites étapes, avec des documents intermédiaires pour structurer son travail.
- Corriger au coup par coup : quand le résultat est faux, lui demander de réparer chaque erreur l'une après l'autre.
- Tout garder en mémoire : conserver l'intégralité de la conversation, puisque le modèle peut l'accepter.
À l'époque, ces habitudes étaient justifiées : sans elles, les résultats étaient médiocres. Mais un enfant qui sait faire du vélo n'a plus besoin de petites roues, et les garder finit même par ralentir. C'est exactement ce qui arrive aujourd'hui avec les modèles.
2. Pourquoi il devient inutile : les modèles ont rattrapé le harnais
Les modèles les plus performants travaillent désormais efficacement à partir de consignes concises, parfois une seule phrase exprimant clairement l'intention. À mesure qu'ils gagnent en autonomie et en capacité de raisonnement, ils accomplissent les mêmes tâches avec moins d'instructions, moins de contexte et moins d'artefacts intermédiaires.
Une partie du harnais répète donc ce que le modèle sait déjà :
- Les bonnes pratiques générales inscrites dans AGENTS.md sont déjà maîtrisées par le modèle. Seules les particularités du système — conventions spécifiques, contraintes architecturales, règles de sécurité, commandes, décisions structurantes — lui apportent une information nouvelle.
- Les étapes d'orchestration qui guidaient pas à pas un modèle hésitant deviennent des allers-retours sans valeur pour un modèle capable de planifier seul.
- Les artefacts intermédiaires produits pour structurer sa pensée sont générés, payés, puis relus sans améliorer le résultat.
Un exemple. Prenons une story simple : ajouter un champ date de naissance au formulaire d'inscription. Un harnais d'hier l'aurait découpée en quatre étapes confiées à des agents successifs : un agent d'analyse rédige une note, un agent de conception en tire un plan, un agent de développement lit les deux documents puis code, un agent de revue relit le tout. À chaque passage de relais, le contexte est relu et un nouveau document est généré.
Aujourd'hui, une seule consigne suffit : le modèle identifie lui-même le formulaire, la règle de validation, la migration de base de données et les tests à écrire, puis enchaîne le tout dans la même session. Les trois documents intermédiaires, facturés au prix fort des tokens de sortie, n'apportent plus rien.
C'est le sens de la frugalité : non pas réduire aveuglément les tokens, mais éliminer ce dont le modèle n'a plus besoin pour produire un résultat de qualité.
3. Pourquoi il devient contre-productif : l'économie des tokens a changé
On pourrait croire qu'une consigne en trop ou un outil chargé « au cas où » ne fait de mal à personne : au pire, le modèle l'ignore. C'est faux. Un mécanisme superflu n'est jamais neutre. Chaque mot transmis au modèle est facturé, chaque information inutile entre en concurrence avec les informations utiles, et chaque modification mal placée oblige à tout retraiter. Autrement dit, ce qui ne sert à rien finit par coûter quelque chose, en argent comme en qualité.
Le rythme des évolutions bouleverse aussi notre rapport au temps. Dans la plupart des domaines du logiciel, une bonne pratique reste valable des années. Dans le développement agentique, six mois suffisent pour qu'elle paraisse datée. Et ces progrès ne se résument pas à « un modèle plus intelligent » : chaque nouvelle génération réagit différemment aux mêmes consignes et apporte de nouveaux réglages à comprendre (niveaux d'effort, cache, chargement des outils…). Sur un sujet aussi jeune, où les repères se construisent encore, rester à jour devient un travail à part entière pour les développeurs.
Concrètement, trois mécanismes transforment un harnais hérité en handicap :
- Le coût s'est déplacé vers la génération. Ce que le modèle écrit et « réfléchit » coûte bien plus cher que ce qu'il lit. Un harnais qui le pousse à produire davantage attaque donc le poste le plus coûteux (section 3.1).
- Le surplus d'instructions dégrade la qualité. Plus on donne d'informations au modèle, plus il lui est difficile de repérer celles qui comptent vraiment, comme un collaborateur noyé sous les notes, qui ne sait plus distinguer l'essentiel de l'accessoire (section 3.2).
- Un contexte instable casse le cache. Le modèle peut réutiliser à bas prix ce qu'il a déjà lu, à condition que le début de ses consignes ne change pas. Une modification anodine au mauvais endroit, et tout est facturé au prix fort (section 3.3).
3.1. Le coût s'est déplacé vers la génération
Une interaction mobilise quatre catégories de tokens au coût très différent : entrée (instructions, historique, code, outils, résultats), réflexion (raisonnement interne, selon le modèle et l'effort configuré), sortie (réponses, code, appels d'outils) et lecture du cache (informations déjà traitées et réutilisées). Le détail des tarifs par modèle figure en annexe.
Sur Opus 5.5, un token de sortie (20 $/M) coûte cent fois plus qu'un token relu depuis le cache (0,20 $/M).
La conséquence pour le harnais. Les harnais d'hier cherchaient avant tout à raccourcir les prompts, car l'entrée représentait le gros de la dépense. Dès lors que le cache fonctionne, la priorité s'inverse : ce qui coûte, c'est ce que l'agent produit, qu'il s'agisse de réflexion ou de cycles d'exécution répétés. Un harnais qui pousse l'agent à raisonner longuement, à rédiger des artefacts intermédiaires ou à corriger ses erreurs par itérations successives pèse donc précisément sur le poste le plus cher.
Un exemple. Un agent travaille sur un dépôt avec un contexte stable de 200 000 tokens (règles, outils, code), mis en cache. Avec les tarifs d'Opus 5.5 :
- relire tout ce contexte depuis le cache coûte 200 000 × 0,20 $/M = 0,04 $ par tour ;
- rédiger une note d'analyse intermédiaire de 5 000 tokens coûte 5 000 × 20 $/M = 0,10 $, soit plus du double de la relecture complète du contexte ;
- une réflexion poussée de 20 000 tokens coûte 0,40 $, soit dix fois le prix de cette relecture.
Que retenir de ces chiffres ? Les harnais d'hier concentrent leurs efforts sur la taille du prompt, c'est-à-dire sur ce que l'agent lit. C'était logique avant le cache : chaque token lu était facturé plein tarif (4 $/M), et retirer 50 000 tokens du prompt faisait économiser 0,20 $ à chaque tour. Mais une fois le contexte en cache, ces mêmes 50 000 tokens ne coûtent plus que 0,20 $/M : les retirer ne rapporte plus que 0,01 $.
Comparons maintenant trois optimisations possibles, à chaque tour de l'agent :
| Ce que l'on supprime | Calcul | Économie |
|---|---|---|
| 50 000 tokens de prompt (en cache) | 50 000 × 0,20 $/M | 0,01 $ |
| Une note d'analyse intermédiaire | 5 000 × 20 $/M | 0,10 $ |
| Un cycle de correction (20 000 tokens de réflexion + 5 000 de code) | 25 000 × 20 $/M | 0,50 $ |
| Autrement dit, éviter une seule correction rapporte autant que raccourcir le prompt de 50 000 tokens pendant cinquante tours. Les volumes choisis sont illustratifs, mais les écarts, eux, découlent directement des tarifs : quel que soit le projet, un token écrit coûte cent fois plus qu'un token relu depuis le cache. |
L'économie ne se joue donc plus sur ce que l'agent lit, mais sur ce qu'il écrit.
3.2. Un surplus d'instructions dégrade la qualité
Un modèle ne lit pas son contexte comme une base de données dans laquelle il irait chercher l'information exacte. Il répartit son attention sur l'ensemble de ce qu'il reçoit. Plus le contexte contient d'éléments, plus cette attention se dilue, et plus il devient difficile pour le modèle de distinguer ce qui compte vraiment pour la tâche en cours.
On peut comparer cela à un nouveau collaborateur à qui l'on remettrait, le premier jour, l'intégralité de la documentation de l'entreprise avant de lui confier une tâche précise. Toute l'information est là, mais celle dont il a besoin est noyée dans le reste.
Deux situations produisent cet effet :
- Trop d'éléments chargés dès le départ. Instructions générales, règles, skills, définitions d'outils : tout ce qui est présent dans le contexte entre en concurrence pour l'attention du modèle, qu'il soit utile ou non à la tâche. Un modèle qui dispose de cinquante outils aux noms proches se trompera plus facilement qu'un modèle qui n'en voit que cinq pertinents.
- Des conversations qui s'allongent. Au fil des échanges, l'historique accumule des discussions secondaires, des résultats d'outils devenus obsolètes et des pistes abandonnées. Une grande fenêtre de contexte permet de tout conserver, mais ne garantit pas que le modèle saura retrouver l'essentiel. Une décision importante prise au début de la session peut ainsi perdre son poids face à des centaines de lignes de journaux de tests plus récents.
Un cercle vicieux. Un contexte encombré conduit à des réponses moins justes : mauvais choix d'outils, consigne oubliée, retour vers une piste déjà écartée. Ces erreurs appellent des corrections, qui génèrent de nouveaux tokens de sortie, le poste le plus cher, et allongent encore l'historique. Charger « au cas où » ne coûte donc pas seulement des tokens d'entrée : cela finit par coûter en qualité, puis en génération.
3.3. Un contexte instable casse le cache
Pour comprendre comment on perd le bénéfice du cache, il faut savoir comment il fonctionne. Le cache ne mémorise pas des morceaux d'information isolés : il mémorise un préfixe, c'est-à-dire le début d'une requête. Lorsqu'une nouvelle requête commence exactement comme la précédente, cette partie commune est relue depuis le cache au lieu d'être retraitée.
Ce préfixe est toujours construit dans le même ordre :
- les définitions d'outils ;
- les instructions système ;
- les messages de la conversation.
La règle essentielle est simple : le cache ne fonctionne que jusqu'à la première différence. Tout ce qui suit un élément modifié doit être retraité à plein tarif. Modifier un message récent ne coûte presque rien ; modifier une définition d'outil invalide tout le reste.
On peut comparer cela à un livre dont on aurait gardé une photocopie : tant que les premières pages sont identiques, on peut les réutiliser. Mais si l'on change un mot à la page 1, toutes les pages suivantes doivent être réimprimées.
Un exemple courant. Un harnais insère la date et l'heure courantes dans les instructions système. L'intention est louable : informer l'agent du moment présent. Mais l'horodatage change à chaque requête, et il se trouve en tête de structure. Résultat : les instructions système et tout l'historique de conversation sont retraités à chaque appel.
Sur Opus 5.5, avec un contexte stable de 50 000 tokens :
- relu depuis le cache : 0,01 $ par requête ;
- retraité au tarif d'entrée : 0,20 $ par requête, soit vingt fois plus, et davantage encore si ce contenu est réécrit en cache à chaque fois.
Sur une session de plusieurs centaines d'appels, l'écart devient considérable, sans aucun gain de qualité.
La bonne pratique consiste donc à séparer le contexte stable (outils, règles, conventions, instructions permanentes), placé en tête et laissé intact, du contexte dynamique (date, story en cours, résultats récents), ajouté en fin de requête, là où il ne casse rien.
Trois effets qui se renforcent
Ces trois mécanismes ne s'additionnent pas seulement, ils s'entretiennent :
- un contexte encombré ou mal choisi dégrade les décisions de l'agent ;
- les erreurs qui en résultent appellent des corrections, donc davantage de tokens générés ;
- ces corrections allongent l'historique, qui encombre à son tour le contexte et alourdit chaque requête suivante.
Un harnais surdimensionné ne coûte donc pas une seule fois : il coûte à chaque tour de boucle.
Ce qu'il faut retenir
Un harnais conçu pour les modèles d'hier n'est pas seulement superflu : il pèse sur le poste le plus cher, la génération ; il brouille l'attention du modèle ; et il casse le cache dont dépend l'économie des agents. Ces trois effets s'entretiennent, si bien que chaque mécanisme hérité coûte à chaque tour de boucle.
Reste la question pratique : que faire de son harnais ? C'est l'objet du second volet, qui passe en revue huit réflexes hérités à désapprendre, et ce qui les remplace, avant de proposer une méthode pour faire évoluer son harnais au rythme des modèles.
Annexe : tarifs des modèles Anthropic
| Modèle | Entrée / M tokens | Sortie / M tokens | Lecture du cache |
|---|---|---|---|
| Fable 5.1 | 10 $ | 50 $ | 2,5 % du tarif d'entrée |
| Opus 5.5 | 4 $ | 20 $ | 5 % |
| Sonnet 5.5 | 2 $ | 10 $ | 5 % |
| Haiku 5.5 | Dès 0,10 $ | Dès 0,50 $ | 10 % |
| Tarifs indicatifs, à confirmer dans la documentation officielle avant toute estimation budgétaire. L'écriture en cache coûte 1,25 fois le prix d'entrée pour une conservation de cinq minutes, et 2 fois pour une heure. |