Agentic Engineering : Au-delà du prototype
Après avoir vu des accélérations offertes par le développement assisté par IA de x10 ou x100 sur les réseaux, avez-vous essayé dans votre projet historique ? Et ça n’a pas du tout marché ?
Êtes vous allez très vite dans le développement d’un prototype assisté par IA, puis vous avez vécu un ralentissement au fur et à mesure que le projet avance ?
Le père de la clean architecture, Robert Martin, mentionne dans une interview que pour lui l’accélération est plus de l’ordre de x4. Car il ne délègue pas tout, et il met en place de nombreux harnais qui rendent l’agent plus pertinent, mais le ralentissent.
Cette différence de productivité s’explique par le contexte dans lequel l’expérience est menée. Dans un contexte de prototypage où l’objectif est d’essayer une idée, vérifier que c’est faisable, que c’est utile, il est possible de prendre de nombreux raccourcis : partir d’une page blanche, sacrifier la qualité du code, laisser des failles de sécurité, etc.
Dans un contexte de produit complexe en production, il y a des standards à respecter, un existant à maintenir, des garanties de niveau de service à tenir, etc.
Nous allons explorer 5 catégories de freins à la mise en place de l’Agentic Engineering dans un projet complexe en production.
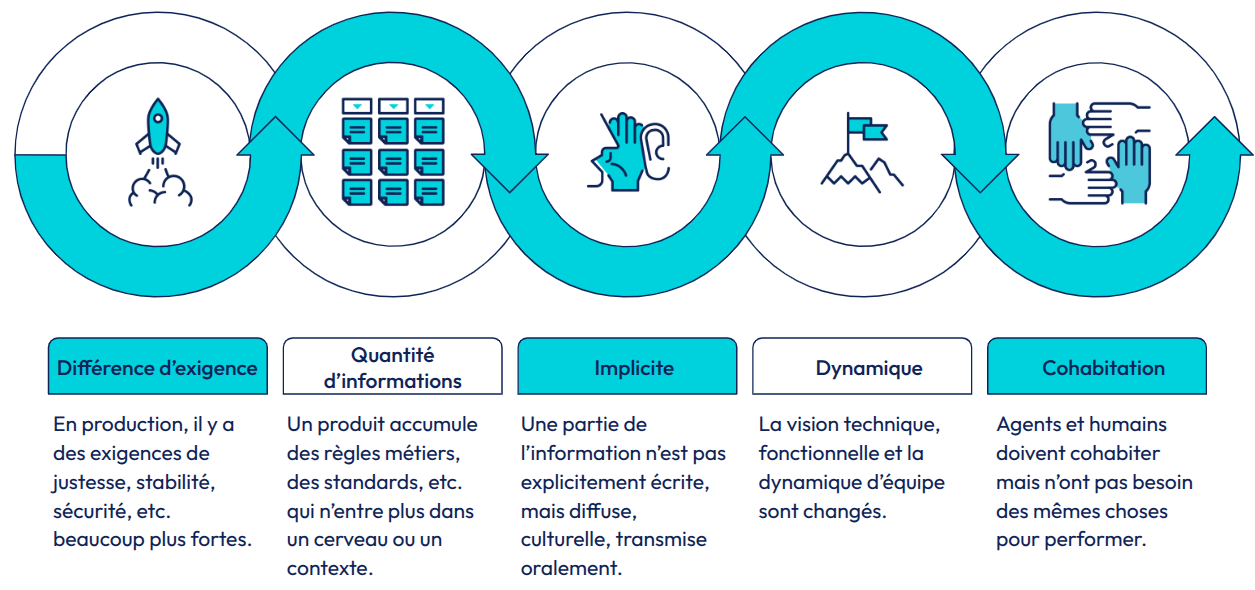
Illustration : Résumé des 5 catégories de freins rencontrés dans un projet complexe.
Frein n°1 : Une différence d’exigences
La première difficulté est la différence d’attentes entre un projet naissant, où l’objectif est de sortir un premier prototype qui “ressemble à quelque chose”, qui permet de tester une idée et un projet plus ancien avec un gros existant.
Le prototype peut se contenter d’être plausible, ça a l’air juste, ça a l’air bien pour convaincre, pouvoir itérer, et corriger d’éventuels bogues par la suite. Alors que les projets existants depuis longtemps ont une exigence de justesse, l’ensemble des fonctionnalités passées ne doit pas changer de manière non prévue, la fonctionnalité développée devra être correcte car il ne s’agit plus de convaincre mais bien d’offrir un service à l’ensemble des utilisateurs.
Le prototype n’a que peu d’exigence de stabilité, il est acceptable que, entre deux démonstrations, le comportement soit très différent ; alors que sur un existant il faut assurer cette stabilité. Cela se retrouve notamment dans le semantic versionning qui a pour standard que en versions 0.YY.ZZ il est possible de tout changer entre deux versions mineures car c’est une ”béta”, alors que lorsque que l’on passe en majeur >= 1 une stabilité doit être assurée.
Avec la stabilité, vient une exigence de traçabilité des modifications apportées au code et aux données, des actions réalisées par les utilisateurs afin de permettre un éventuel audit, un retour en arrière (roll back), etc.
Il y a également une différence d’exigence de sécurité de l’applicatif produit, un prototype tournant en local, avec des fausses données, peut (même si ce n’est bien sûr pas recommandé) se passer d’authentification, de gestion de flux réseau, peut utiliser des librairies avec des failles de sécurités, peut stocker ses secrets en dur, etc. Pour une application en production, cela est inacceptable, et des vérifications automatiques doivent être mises en place pour s’assurer que l’application n’a pas de faille de sécurité.
Finalement il y a un enjeu de pérennité de ce qui a été produit, il faut être capable de le maintenir dans le temps, même lorsque les équipes changeront, même lorsque la mémoire de l’agent aura été vidée. Si en phase de prototypage il est souvent possible d’oublier le passé, de supprimer la base de donnée, sur un produit complexe il faudra plutôt faire une migration de données, assurer un double run, ce qui rend l’évolution du code plus complexe.
Cette différence d’exigence rend le travail des agents de code plus compliqué, car les LLMs n’ont pas été construits pour répondre “je ne sais pas”, ils préfèrent compléter les trous, ils font du probabiliste, du plausible, plutôt que du juste. Mais aussi car ils cherchent à valider ce qui se mesure en ayant que peu de considération pour ceux qu’ils ne sont pas capables de mesurer. Ainsi, si il n’y a pas de tests automatisés pour valider un comportement, les agents de code n'hésitent pas à le changer. Pire, si il y a un test et que celui-ci se met à échouer, ils pourront parfois le modifier, car ce qu’ils cherchent c’est que tous les tests soient au vert.
Pour répondre à cette exigence changeante, l’humain a, par exemple, investi dans une organisation avec de la QA. Il faut investir dans le cadre apporté à l’agent, le terme actuel de marché est l’harnessing, pour approfondir, vous pouvez explorer :
- Harnessing des agents : 9 pratiques venant du logiciel - OCTO Talks !
- Harness engineering for coding agent users
- Harness engineering: leveraging Codex in an agent-first world | OpenAI
L’ensemble de ces pratiques font que l’agent de code réalise plus d’itérations avec les différents outils / documentations mis à sa disposition, cela implique une consommation en token plus importante afin de produire un code qui répond à ces exigences.
Frein n°2 La quantité d’informations
Dans un projet au stade de prototype la quantité d’information est assez limitée, l’humain comme l’agent peut avoir tout dans son contexte, dans sa mémoire.
En grandissant le projet va accumuler de l’information :
- Règles métiers
- Expériences utilisateurs prévues et non-prévues
- Pattern de développement, d’architecture
- Bug passés
- Hacks liés à une situation en production
- Fonctionnalités développés, puis retirées, mais pas complètement
- Refactoring commencé dans une partie de la base de code, mais jamais généralisé
- Etc.
Ces informations vont s’accumuler au fil des années, elles ne rentreront plus dans le contexte ou la mémoire de l’humain. Par exemple, mon projet actuel, qui a 3,5 ans d'ancienneté, fait 3,5 millions de caractères, il n’entre donc pas tel quel dans une fenêtre de contexte classique d’un modèle utilisé pour du développement logiciel. Il faut alors sélectionner le contexte à donner, orienter l’agent, faire du “Context Engineering”.
Cela passe par :
- Un bon découpage de la base de code, pour que l’agent puisse se concentrer sur une partie, réaliser une tâche en lisant “que” un dossier.
- Pour chaque partie du projet, dossier / sous-dossier, ajouter un AGENT.md pour guider plus précisément l’agent.
- Un peu de documentation pour lui permettre de naviguer facilement dans le système de dossier, par exemple dans l’AGENT.md.
- Éventuellement utiliser une base de connaissances qu’il alimente au fil de ses développements (telle que graphify)
Frein n°3 : La quantité d’implicite
Plus difficile à gérer que la quantité d’informations, l’information implicite va grandement complexifier le développement. Cet implicite prend différentes formes :
Les standards de code, les patterns d’architecture ne sont pas toujours documentés, et même si ils le sont, ils ne sont pas respectés partout. L’agent cherchant avec des “grep” utilisera le mauvais pattern de manière probabiliste là où l’humain compense par ses relations sociales : La personne expérimentée sur le projet qui dit “Regarde pas ce dossier là, c’est très moche dedans”.
Les règles métiers ne sont plus centralisées dans une fonction pure, mais sont étalées dans tout le produit, parfois entre repository de code. Car “il y a deux ans on a eu un bug, et on a mis le fix côté ETL plutôt que back pour aller plus vite”. Nous recommandons l’approche mono-repository qui permet au moins de rassembler dans le même contexte l’ensemble des informations.
Les intentions sont rarement présentes dans le code, le code contient principalement le “comment”. Il devient alors difficile de retrouver si le comportement est souhaité ou accidentel. L’équipe a des habitudes, une expérience, une mémoire que l’agent n’aura pas, qu’il lui faudra reconstituer et stocker. Si l’agent devient un gros contributeur et a une mémoire distincte des humains, cela en sera de même dans l’autre sens. Il faut alors réconcilier ces mémoires. Les outils utiles seront :
- La documentation as code : stocker dans le repository sous format markdown l’ensemble des spécifications, des standards, des Architecture Decision Record, des postmortem, des bilans d’expérimentations ;
- Les tests automatisés : qui permettent de documenter une intention, un comportement attendu ;
- Du code explicite avec des méthodes et variables bien nommées qui expriment des intentions.
Le vocabulaire est hétérogène, la même chose peut être appelée de deux façons différentes, et deux choses différentes peuvent être appelées de la même façon. La solution pourrait être d’expliciter, mais cet exercice n’est pas évident, car nous n’avons pas toujours pleinement conscience de ce que l’on fait (au sens des impacts que cela va avoir). Trois idées de solutions :
- Que humain ou agent reviewer challenge le vocabulaire en code review ;
- Demander à l’agent de code en fin de session ce qui lui a fait perdre du temps pour corriger ;
- Faire des sessions de d’explicitation, de désambiguïsation de la base de code avec pour livrable des choses mieux nommées, de la documentation, etc.
Avec ces idées, un compromis apparaît : énergie consacrée, en temps ou en tokens, à désambiguïser, documenter versus énergie consacrée à développer de nouvelles fonctionnalités.
Frein n°4 : La dynamique
Si en phase de prototypage la dynamique d’équipe peut être simple : demander à l’agent ce qu’il faut construire (par exemple en utilisant BMAD) puis faire du vibe coding où l’on accepte l’ensemble des modifications suggérées par l’agent, sur un produit complexe cela est plus complexe.
L’agent impact la dynamique de l’équipe de développement
La code review risque de devenir un goulet d’étranglement. Sans agent une équipe pouvait produire environ une merge request par développeur par jour, avec les agents ce nombre explose. Les pratiques suivantes peuvent aider à limiter le goulot :
- Celui qui fait appel à l’agent doit relire le code et ne pas faire passe plat entre l’agent et le reviewer.
- Enrichir la CI/CD pour augmenter la qualité de ce qui est envoyé en code review et autonomiser les agents : linter fort, validation de sécurité, couverture de test enrichie, tests techniques ;
- Mettre en place des agents de review de code ;
- Adopter le pattern Ship / Show / Ask : qui autorise dans certaines conditions le développeur à merger une pull request sans pour autant faire appel à une review lorsqu’il n’y a peu de risques / rien d’original.
La CI/CD sera également sur-sollicitée, il faut alors investir dans son optimisation pour accélérer l’ensemble des boucles de feedback et de déploiements. Par exemple, Github a introduit la notion de merge queue afin d’accélérer le processus de merge sur la branche principale.
Le Product Owner ou référent métier qui avait l’habitude d’attendre de la bande passante de développement sera maintenant sur sollicité de questions, de besoins, de demandes de clarifications. Les équipes doivent être recomposées, en changeant le ratio dev / PO ou en responsabilisant les dev sur plus de sujets métiers, c’est le métier de Product Engineer.
Ensuite l’agent impact la vision technique
En permettant à l’agent d’écrire de la documentation, des décisions d’architecture, du code, il va orienter le projet. Il va combler d’éventuels trous dans le raisonnement, inclure de la gestion d’erreur ou des cas auxquels l’équipe n’avait pas pensé.
Si les modifications sont très orthogonales à la vision de l’équipe, cela sera très surement vu par le développeur, mais lorsque c’est une petite modification elle ne se verra pas beaucoup mais à force d’accumulation cette vision légèrement différente se généralise.
Un exemple vécu sur un projet : l’agent de code a une fois inventé ou halluciné que les fichiers partitionné sont des “hive-partition” (au sens de l’outil Apache Hive), il a introduit le terme dans un ADR, et plusieurs itérations plus tard il introduit cette notion un peu partout dans le code. L’équipe humaine n'a jamais utilisé ce terme.
Si cette anecdote est très niche, c’est également parce que l’équipe a pu la détecter. Qu’en ait-il de toutes ces imprécisions qui n’ont jamais été détectées ?
A défaut d’avoir de recommandation très solide ici, nous recommandons de garder une partie de projet uniquement humaine. Cela peut-être les tests, le code, ou les décisions d’architecture. C’est cette dernière que je favorise afin de m’assurer que les trous dans notre raisonnement, que les mots employés soient choisis de manière consciente, quitte à ce que le style de la rédaction soit plus “brut”.
Finalement, l’agent choisit les fonctionnalités qui restent et celles qui sortent.
Tous les projets suffisamment gros se retrouvent avec des invariants métiers conflictuels, c'est-à-dire des fonctionnalités qui s’opposent. Un exemple simple serait : la com’ demande à ce que l’on envoie un email à toutes les personnes qui seront majeurs dans l’année calendaire, le service juridique lui demande à ce que ce soit uniquement les majeurs à date de l’envoi.
Dans la plupart des équipes de développement avant IA, c’était la première fonctionnalité qui restait, en cas de conflit, l’équipe faisait de la résistance au changement, parfois de manière très “bruyante”. Ainsi la première fonctionnalité implémentée était celle qui avait le plus de chances de rester.
L’agent lui n’a pas cette résistance au changement, il implémente la dernière demande sans faire cas d’éventuelles fonctionnalités changées. Et il fera cela de manière silencieuse.
Si cela n’est pas dans l’absolu un problème, ce changement de dynamique peut être troublant pour les métiers.
Frein n°5 : La cohabitation
L’expérience de l’agent (AgentEx) et l’expérience du développeur (DevEx) sont très corrélées : la plupart des bonnes pratiques de code, d’architecture, de documentation améliorent l’expérience des deux. Cependant, elles ne sont pas parfaitement alignées :
- Un agent de code sera très à l’aise dans un fichier de plusieurs centaines de lignes, là où l’humain voudra que le contenu tienne dans son écran.
- Un agent de code a une aisance similaire dans la plupart des langages, là où l’humain connaît très bien un (voire deux) language “seulement”.
Il faut alors faire un choix, trouver l’équilibre entre AgentEx et DevEx. Au moment où j'écris cet article je favorise encore systématiquement la DevEx sur l’AgentEx, mais ce choix n’est peut-être pas définitif, si l’agent devient un contributeur beaucoup plus significatif, beaucoup plus pertinent, je pourrais peut-être revoir cela.
Aparté sur les projets de refonte Agentic
Les agents de code ont rendu possibles des projets précédemment trop coûteux tel qu’un “Exit SAS” pour tout recoder en python, des sorties de COBOL, ou des refontes applicatives complexes. Ces projets ont donc des très gros existants.
La démarche relève souvent de rétro-documentation du fonctionnel existant (c’est là que réside la véritable accélération) avec une review humaine en oubliant la grande majorité des pratiques, bonnes commes mauvaises, de développement et d’architecture passées puisqu’il s’agit de repartir d’une page blanche.
Ce droit à oublier la technique et les pratiques permet de simplifier grandement la contribution de l’agent.
Ensuite il faut développer le nouveau projet, qui nécessitera tout de même architecture, vision technique, standards, pratiques. Et si le début du développement ressemble à du prototypage, les équipes seront vite confrontées aux difficultés citées dans cet article.
Conclusion
Sur un produit complexe, les exigences supérieures à celle d’un prototype, la quantité d’information, parfois implicite, les challenges sur la dynamique et l’expérience développeur font qu’il faut investir plus dans le harnessing d’agent. Cela réduit une partie de l’accélération offerte plutôt que d’aller 10 fois plus vite, l’équipe va peut-être deux fois plus vite.
Cela implique également que certaines tâches, fonctionnalités, certains tickets résistent encore aux agents de code car il y a trop d’implicite, trop d’informations, le développeur expérimenté fera la tâche plus vite et mieux sans agent. Cette frontière évolue cependant à chaque innovation.
Toutes les bonnes pratiques de documentation, de craftsmanship, d’architecture permettent d’accélérer humain comme agent, lâcher un agent de code dans un produit complexe sans aucune bonnes pratiques en place ne sera que gachi de token et bug assurés.
Remerciements : Philippe Stepniewski pour sa relecture exigeante.